Coder avec un LLM local : harness, vLLM et LiteLLM
Un assistant de code utile ne se résume pas à un modèle. Il assemble un harness qui agit sur le dépôt, des modèles ouverts servis en local par vLLM, une passerelle LiteLLM qui expose une API unique et un cache clé-valeur qui rend les sessions longues abordables.
Mis à jour le 26 septembre 2026 : GLM 5.3 et Qwen 3.8 27B remplacent les générations précédentes dans le panorama des modèles ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Mis à jour le 2 septembre 2026 : le tableau du cache clé-valeur, présenté comme un « gain observé », est remplacé par un calcul à hypothèses nommées (60 tours, préfixe de 250 000 tokens, lecture de cache facturée 10 % du tarif d'entrée chez Anthropic et OpenAI) ; les chiffres sans source (« cent actions », « une dizaine de secondes ») sont retirés.
Pourquoi un harness change-t-il la donne pour coder avec l’IA ?
Un modèle de langage seul produit du texte, tandis qu'un assistant de code utile agit directement sur le dépôt. Il lit les fichiers, propose un correctif, lance les tests et vérifie la compilation avant d'itérer. Cette boucle d'exécution, qui enchaîne lecture, modification et validation, prend le nom de harness.
OpenCode et Hermes remplissent ce rôle : OpenCode orchestre les appels d'outils sur le système de fichiers, applique les règles d'approbation sur les actions sensibles et délègue à des sous-agents pour paralléliser les tâches de recherche, d'analyse ou de test.
Hermes ajoute une couche d'orchestration par rôles : un modèle raisonne, un autre code, un autre vérifie. Sans harness, le modèle reste un générateur de texte ; avec lui, il devient un collaborateur technique qui agit dans le dépôt.
L'architecture derrière l'assistant de code
Une architecture locale assemble cinq briques. Le harness OpenCode présente les outils au modèle et exécute la boucle d'édition. Hermes orchestre par rôles quand l'équipe a besoin de spécialisation. LiteLLM expose une API unique compatible OpenAI et applique des quotas par développeur.
Le moteur d'inférence vLLM sert les modèles ouverts sur le matériel de l'organisation avec une gestion fine de la mémoire GPU. Le choix du modèle dépend du profil de tâche : raisonnement long, appels d'outils stables, ou compromis qualité-coût pour le quotidien.
Côté matériel, une ou plusieurs RTX PRO 6000 suffisent pour une équipe complète, tandis qu'un ou plusieurs DGX Spark suffisent pour un développeur isolé, le dimensionnement se décidant sur le nombre d'utilisateurs simultanés.
Le code source ne quitte-t-il jamais l'infrastructure ?
L'argument tient en une phrase : le code ne sort pas du réseau interne. Le harness appelle LiteLLM sur une adresse privée, LiteLLM route vers vLLM sur la même machine ou un poste voisin, et le modèle traite la requête sans qu'aucun octet ne traverse Internet.
Cette propriété règle plusieurs problèmes à la fois : le secret industriel reste dans le périmètre certifié, les exigences de conformité NIS2 trouvent une réponse technique simple, et les auditeurs vérifient que le code de production n'apparaît dans aucun journal d'un fournisseur tiers.
Les équipes juridiques n'ont plus à négocier de clause sur les données envoyées à un service externe, puisqu'aucune ne sort. La souveraineté devient une propriété du système, et non une promesse contractuelle que l'on vérifie après coup.
Pourquoi le cache clé-valeur local rend les sessions longues économiques ?
Une session de développement productive dure plusieurs heures, pendant lesquelles le modèle relit le même module, retrouve les mêmes définitions et parcourt les mêmes dépendances. Recalculer l'attention sur ce préfixe partagé à chaque tour coûte cher en temps et en énergie.
vLLM conserve un cache clé-valeur en mémoire GPU entre les tours d'une même session. Le préfixe commun du contexte n'est recomputé qu'une seule fois, et chaque tour suivant ne porte que sur le nouveau fragment.
Sur une session de quatre heures avec un contexte de plusieurs centaines de milliers de tokens, ce mécanisme divise le nombre de tokens à recalculer par un facteur que donne la formule ci-dessous, couramment supérieur à dix. Le modèle reste longtemps utile sans que la consommation s'envole, et le développeur peut laisser l'assistant itérer sans surveiller la dépense.
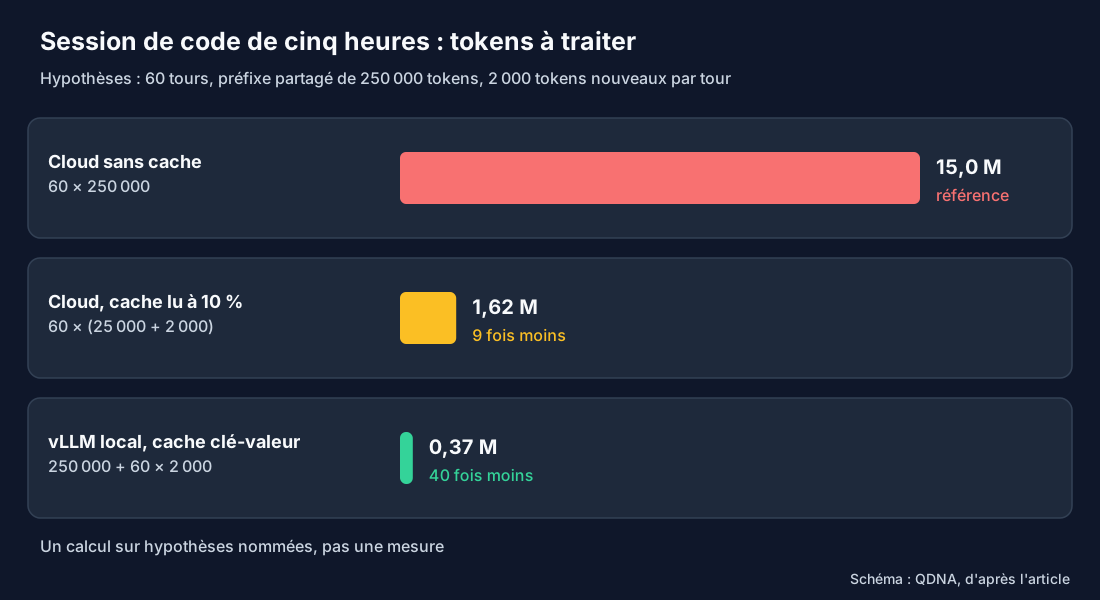
Le tableau ci-dessous n'est pas une mesure mais un calcul, sur des hypothèses nommées : une session de cinq heures, soixante tours (un toutes les cinq minutes), un préfixe partagé de 250 000 tokens et 2 000 tokens nouveaux par tour.
Sans cache, chaque tour relit tout le contexte : 60 × 250 000 = 15 millions de tokens d'entrée. Avec un cache de préfixe, seuls le préfixe puis les fragments nouveaux sont calculés : 250 000 + 60 × 2 000 = 370 000 tokens, soit quarante fois moins.
Sur une API, la lecture du cache reste facturée, à 10 % du tarif d'entrée chez Anthropic comme chez OpenAI (grilles relevées le 2 septembre 2026) : 60 × (250 000 × 0,1 + 2 000) = 1,62 million de tokens en équivalent plein tarif. Le gain réel dépend du nombre de tours et de la part du préfixe réutilisée : mesurez-le sur vos sessions.
| Régime | Tokens traités | Coût relatif |
|---|---|---|
| Cloud facturé au token, sans cache | 15,0 M tokens facturés | Référence |
| Cloud facturé au token, cache de préfixe (lecture à 10 % du tarif) | 1,62 M tokens en équivalent plein tarif | Neuf fois inférieur |
| vLLM en local, cache clé-valeur GPU | 0,37 M tokens calculés | Quarante fois inférieur |
Quel modèle choisir pour quelle tâche de code ?
Le paysage des modèles ouverts pour le code s'étoffe vite, et le bon réflexe consiste à choisir le modèle selon le profil de la tâche, et non l'inverse, en commençant par les modèles les plus lourds pour les chantiers qui l'exigent.
GLM 5.3 sert les refactorisations lourdes et les raisonnements de longue portée : 744 milliards de paramètres en mélange d'experts, dont une fraction active par token, pour absorber une base de code entière sans perte de fil.
Kimi K2.7 Code se distingue sur les sessions longues qui multiplient les appels d'outils successifs : il garde la cohérence du raisonnement sur de longs enchaînements. DeepSeek V4 occupe deux postes : la variante Pro pour les investigations profondes, la variante Flash pour le quotidien de l'équipe, qui combine vitesse et coût contenu.
Qwen 3.8 27B tient sur une carte unique et convient à un développeur isolé qui veut une réponse immédiate sans mobiliser un cluster, ce qui en fait le point d'entrée naturel avant de dimensionner une machine partagée.
Gemma 4 entre dans la même catégorie, avec un profil différent sur les langages de niche. Le passage à l'échelle se fait ensuite en sélectionnant le modèle selon la tâche, ou en l'adaptant via un entraînement local QLoRA, sans toucher au harness ni à LiteLLM.
Une API unique, des clés virtuelles et des quotas par développeur
LiteLLM joue le rôle de point d'entrée unique, le harness lui parlant comme il parlerait à OpenAI. LiteLLM route ensuite vers vLLM, applique les garde-fous et inscrit chaque appel dans un journal d'audit, si bien que les développeurs ne manipulent qu'une seule clé, qu'ils échangent contre une clé virtuelle à leur nom.
Cette clé virtuelle porte un quota par personne et par jour, parfois par projet. L'administrateur plafonne la dépense d'un stagiaire, ouvre un quota large pour un lead technique et coupe l'accès à un modèle pour un sous-traitant. Le provisionnement tient dans un fichier de configuration, et un redémarrage du service suffit.
Les développeurs changent de modèle sans changer d'outil. Le matériel suit la même logique. Un développeur isolé travaille sur un DGX Spark et un seul modèle. Une équipe de cinq à dix développeurs s'appuie sur une ou plusieurs RTX PRO 6000 et sert plusieurs modèles en parallèle, le tout routé par LiteLLM.
Le point de bascule financier entre auto-hébergement et API externe dépend du volume mensuel et du profil de tâches : l'analyse détaillée figure dans notre étude sur les coûts du LLM en local ou via API.
Un assistant de code utile reste local par construction : le code ne quitte pas l'infrastructure, le cache clé-valeur rend les sessions longues abordables, et LiteLLM impose une seule API, des clés virtuelles et des quotas par développeur.
Comment passer du POC à l'usage quotidien ?
Trois conditions réunies font basculer un prototype en pratique d'équipe. Premièrement, un harness configuré pour le dépôt, avec des règles d'approbation explicites sur les fichiers sensibles et un sous-agent de test dédié. Deuxièmement, un moteur vLLM dimensionné pour le modèle de référence et un cache clé-valeur calibré sur la taille de contexte typique.
Troisièmement, une politique LiteLLM qui attribue à chaque développeur une clé virtuelle, plafonne les quotas et journalise les appels pour l'audit.
Une fois ces trois briques en place, l'assistant de code passe du statut d'outil de curiosité à celui d'infrastructure de production. Le code reste dans l'organisation, les sessions longues restent abordables, et chaque développeur consomme sa juste part.
Sources : la documentation de vLLM pour le service des modèles et la réutilisation du cache clé-valeur, la documentation de LiteLLM pour les clés virtuelles et les quotas, et OpenCode pour le harness d'agent.
Questions fréquentes
Pourquoi exécuter un assistant de code en local plutôt que dans le cloud ?
Le code source ne quitte pas l'infrastructure, ce qui satisfait les exigences de souveraineté, de secret industriel et de conformité NIS2. Le cache clé-valeur local réduit le coût des sessions longues, et la latence reste prévisible.
Quel rôle joue LiteLLM dans cette architecture ?
LiteLLM présente une API unique compatible OpenAI face au harness. Elle attribue une clé virtuelle à chaque développeur, applique des quotas par personne et route la requête vers le modèle ouvert choisi. L'application n'a qu'un seul point d'entrée à maintenir.
Quel matériel choisir pour démarrer ?
Une station DGX Spark suffit pour un développeur qui travaille sur des modèles de taille moyenne. Une équipe qui sert plusieurs modèles en parallèle s'appuie sur un poste RTX PRO 6000 ou un cluster équivalent pour absorber la charge concurrente.
Le cache clé-valeur change-t-il réellement l'économie du projet ?
Sur une session de plusieurs heures, le préfixe partagé du contexte n'est recomputé qu'une seule fois. Le coût marginal par tour devient négligeable, ce qui rend viable un travail itératif long.
Un modèle local écrit-il du code de qualité suffisante ?
Les modèles ouverts récents obtiennent des scores élevés sur les tests de résolution de bugs réels comme SWE-bench, au niveau des meilleures API fermées. Servi en local, l'assistant garde votre code dans vos murs, ce qui supprime la fuite de propriété intellectuelle vers un tiers et laisse la maîtrise des accès et de la journalisation.