Sur site ou API : à partir de combien d'utilisateurs le LLM local est-il rentable ?
Le paiement au token se compare mal à une installation amortie, et voici où se situe le point de bascule et pourquoi le cache clé-valeur change tout.
Mis à jour le 8 octobre 2026 : prix du DGX Spark porté à 7 000 € HT ; le coût sur site passe d'environ 170 à environ 223 € HT par mois et le seuil d'environ 75 à 98 utilisateurs agentiques (436 à 574 occasionnels).
Mis à jour le 26 septembre 2026 : grille DeepSeek du 26 septembre 2026 (V4.1 Flash a remplacé V4 Flash 0731 dans l'API le 10 septembre : 0,30 $ en entrée, 1,20 $ en sortie en heures pleines), taux BCE du 25 septembre, DGX Spark à 5 083 € HT chez LDLC.pro ; le seuil passe d'environ 55 à environ 75 utilisateurs agentiques ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Mis à jour le 2 septembre 2026 : tous les coûts sont recalculés avec la formule visible et des hypothèses nommées et datées (prix du DGX Spark, puissance de la fiche NVIDIA, Tarif Bleu EDF, grille DeepSeek et taux BCE ; ces valeurs ont été remises à jour le 26 septembre 2026, voir ci-dessus). Les seuils « 15 à 100 utilisateurs », les « retours de terrain » chiffrés (2 400 €, 800 €, 300 €, 2 000 €) et les gains de leviers (30 à 100 %, facteur deux à trois, moitié) n'avaient pas de source et sont retirés ou remplacés par le calcul.
Deux structures de coût opposées
Une interface facturée à l'usage n'a presque pas de coût fixe, mais un coût qui croît avec chaque token, quand une installation sur site demande un investissement initial élevé puis un coût marginal proche de zéro.
Les deux courbes se croisent à un point de bascule qui dépend de l'intensité d'usage, et qui ne se devine pas : il se calcule à partir de cinq nombres sourcés, tous datés et publiés plus bas.
Quelles sont les hypothèses du calcul ?
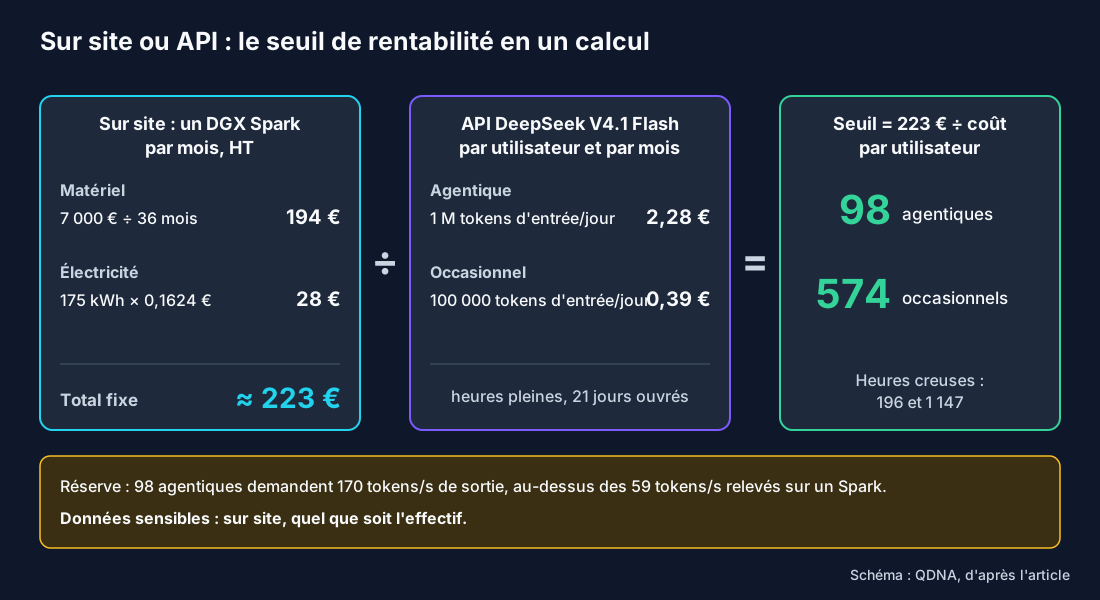
Coût API mensuel par utilisateur = 21 × (entrée non cachée × 0,26 € + entrée cachée × 0,0053 € + sortie × 1,05 €) par million de tokens. Profil occasionnel : 21 × (0,05 × 0,26 + 0,05 × 0,0053 + 0,005 × 1,05) = 0,39 €.
- Matériel : DGX Spark (PNY), 7 000 € HT (8 400 € TTC), prix retenu en octobre 2026 après la hausse constatée (relevé LDLC.pro du 26 septembre 2026 : 5 083 € HT), amorti linéairement sur 36 mois, soit 194 € HT par mois. Le modèle servi est sous licence MIT, sans redevance.
- Électricité : 240 W, alimentation nominale de la fiche NVIDIA DGX Spark retenue en hypothèse haute (ServeTheHome mesure 60 à 200 W en charge), 24 h sur 24, soit 175 kWh par mois, au Tarif Bleu professionnel d'EDF, option Base, jusqu'à 36 kVA, grille du 1er août 2026 (0,1624 € HT le kWh, accise et CTA incluses, hors TVA ; délibération CRE 2026-147, valeur relevée sur Selectra Entreprises le 2 septembre 2026) : 28 € HT par mois. Total sur site : ≈ 223 € HT par mois, hors intégration et exploitation, qui se chiffrent sur devis et s'ajoutent aux deux colonnes de la même façon si l'on compare des offres équivalentes.
- Tarif API : DeepSeek V4.1 Flash (modèle deepseek-flash, qui a remplacé V4 Flash 0731 dans l'API le 10 septembre 2026), grille publique relevée le 26 septembre 2026, heures pleines (01:00–04:00 et 06:00–10:00 UTC en semaine, plage que chevauche une journée de bureau française) : 0,30 $ par million de tokens d'entrée non cachés, 0,006 $ cachés, 1,20 $ en sortie ; heures creuses moitié prix. Au taux de 1 € = 1,1403 $ (BCE, 25 septembre 2026) : 0,26 €, 0,0053 € et 1,05 € par million.
- Profil occasionnel : 100 000 tokens d'entrée par jour ouvré, dont la moitié servis depuis le cache, et 5 000 tokens de sortie ; 21 jours ouvrés par mois.
- Profil agentique : 1 000 000 de tokens d'entrée par jour ouvré, dont 80 % de préfixes répétés servis depuis le cache, et 50 000 tokens de sortie.
Profil agentique : 21 × (0,2 × 0,26 + 0,8 × 0,0053 + 0,05 × 1,05) = 2,28 €. Seuil = 223 € ÷ coût par utilisateur, arrondi à l'unité supérieure.
À partir de combien d’utilisateurs le sur-site devient-il rentable ?
Le sur-site devient rentable au-delà d'environ 98 utilisateurs agentiques, ou 574 utilisateurs occasionnels, au tarif heures pleines de DeepSeek V4.1 Flash. Au tarif heures creuses le seuil double, à 196 agentiques ou 1 147 occasionnels. En dessous, l'interface au token reste moins chère.
| Effectif | Profil d'usage | Option la moins chère |
|---|---|---|
| Moins de 98 agentiques (ou 574 occasionnels) | 222,90 € ÷ 2,2835 € = 97,6, soit 98 ; 222,90 € ÷ 0,3888 € = 573,3, soit 574 | Interface au token (DeepSeek V4.1 Flash, heures pleines) |
| Moins de 196 agentiques (ou 1 147 occasionnels) | Mêmes formules au tarif heures creuses, moitié prix | Interface au token si la charge tourne la nuit ou le week-end |
| Au-delà | Coût sur site fixe, coût API proportionnel | Sur site, écart croissant, à condition que la machine tienne la charge |
Deux réserves bornent ce résultat.
La première est la capacité : 98 utilisateurs agentiques produisent 103 millions de tokens de sortie par mois, soit 170 tokens par seconde sur les heures de bureau, au-dessus des 18 à 20 tokens par seconde en flux unique et des 59 tokens par seconde agrégés à douze requêtes relevés par Entrpi sur un DGX Spark pour DeepSeek V4 Flash.
Ce relevé (moteur DSpark, forum NVIDIA, 15 juillet 2026) est complété par deux Spark en vLLM FP8 qui atteignent 210,8 tokens/s agrégés à six utilisateurs (Classmethod, 10 août 2026) ; le débit d'un Spark sous forte concurrence reste [À MESURER], et si la machine ne suffit pas, c'est le prix de la suivante qui entre dans la formule.
La seconde est le choix de l'API de référence : une grille plus chère que celle de DeepSeek abaisse le seuil dans la même proportion. Enfin la présence de données sensibles impose le sur site quel que soit l'effectif, pour des raisons de conformité et de souveraineté.
Le cache clé-valeur, l'atout du sur site
Les charges agentiques sont dominées par les tokens d'entrée, vingt pour un dans le profil retenu ci-dessus, davantage sur des boucles d'outils, et c'est là que le cache de préfixe change le calcul, car il évite de refacturer le même texte à chaque tour.
Un prompt système de dix mille tokens envoyé mille fois par jour représente dix millions de tokens : 2,60 € par jour au tarif heures pleines de DeepSeek s'il n'est pas servi depuis le cache, 0,05 € s'il l'est, et presque rien en local une fois le préfixe en cache.
Le moteur d'inférence vLLM réutilise gratuitement le cache de préfixe, si bien que le délai avant le premier token chute fortement lorsqu'un début de conversation se répète, et les boucles répétées deviennent quasi gratuites.
Une interface distante, elle, facture le token non mis en cache à un tarif nettement supérieur. La combinaison du cache documentaire et du cache de prompt réduit fortement le coût des scénarios agentiques, où le même contexte revient à chaque tour.
Quelles sont les deux voies de l'hébergement souverain en France ?
Deux voies existent. Le sur site combine l'investissement matériel et l'électricité française, d'origine nucléaire pour une large part, donc stable et bas carbone. La colocation dans un data center souverain français évite l'achat d'un local. Elle conserve la maîtrise juridique, à la différence d'opérateurs soumis à un droit étranger.
Comment rationaliser sans exposer la donnée ?
Un socle matériel mutualisé sert l'ensemble des agents, avec des quotas par équipe, et l'innovation sur des données publiques peut déborder vers un service distant, tandis que les données sensibles demeurent en local, ce qui rationalise le coût sans exposer l'information. Le cadre général est présenté dans notre définition de la plateforme IA souveraine.
Pourquoi le faux local génère-t-il des coûts cachés ?
Une équipe croit parfois fonctionner en local tout en réglant chaque mois une facture d'interface distante. Une analyse de sentiment ou une classification cachée dans un agent continue d'appeler un fournisseur externe. La ligne de facture n'est rattachée à aucun projet.
Le calcul est le même que ci-dessus, appliqué au relevé réel de la passerelle : tant que cette dépense mensuelle dépasse les 223 € HT d'une machine amortie, le rapatriement se finance seul, et la règle tient en une phrase : un local partiel reste une dépendance facturée.
Quels leviers réduisent le coût par token ?
Le coût du sur site baisse encore lorsque le moteur d'inférence est réglé, plusieurs leviers se cumulant sans exiger de matériel supplémentaire.
- Le traitement par lots continu sert plusieurs requêtes à chaque passe de calcul ; le gain se mesure sur la charge visée, il n'est pas un pourcentage universel.
- Le cache de préfixe et de clé-valeur transforme les tokens d'entrée répétés en tokens presque gratuits.
- La quantification loge davantage de modèle sur une même carte graphique, ce qui élève les tokens par seconde et par euro.
- Le décodage spéculatif fait proposer plusieurs tokens par un petit modèle que le grand vérifie en une passe, ce qui abaisse le délai entre tokens quand les propositions sont acceptées ; le facteur dépend du couple de modèles et se mesure.
- Un format d'échange compact entre agents réduit les tokens consommés à chaque tour ; l'économie se compte sur le journal de la passerelle, pas d'avance.
La passerelle LiteLLM unifie plus de cent fournisseurs et modèles derrière une seule interface (« Call 100+ LLMs », documentation officielle), si bien que le passage d'un fournisseur à l'autre tient en une ligne de configuration.
Les clés virtuelles fixent un budget et des limites par équipe, tandis que la dépense reste stockée dans votre propre base, sur votre infrastructure en Europe, de sorte que la facture cesse d'être une inconnue et se lit équipe par équipe.
Questions fréquentes
À partir de combien d'utilisateurs le local est-il rentable ?
À partir d'environ 98 utilisateurs agentiques ou 574 occasionnels face à DeepSeek V4.1 Flash en heures pleines : un DGX Spark amorti sur trois ans coûte environ 223 € HT par mois (7 000 € HT sur 36 mois plus 175 kWh à 0,1624 €/kWh HT, Tarif Bleu professionnel), qu'il faut diviser par le coût API mensuel d'un utilisateur, 2,28 € pour le profil agentique et 0,39 € pour l'occasionnel. Le seuil double en heures creuses et suppose que la machine tienne la charge.
Pourquoi le cache clé-valeur change-t-il le calcul ?
Il rend les préfixes répétés quasi gratuits en local, alors que l'API facture chaque token non mis en cache. Les charges agentiques, dominées par l'entrée, en profitent le plus.
Les données sensibles imposent-elles le sur site ?
Oui, indépendamment du coût : la conformité et la souveraineté imposent le local pour les données sensibles.
Références
- Grille tarifaire de l'API DeepSeek, relevée le 26 septembre 2026
- PNY DGX Spark chez LDLC.pro, prix relevé le 26 septembre 2026
- NVIDIA DGX Spark, fiche technique (alimentation 240 W)
- Grille de prix du Tarif Bleu EDF, applicable au 1er août 2026
- LiteLLM, documentation officielle
- Artificial Analysis, comparatifs de performance et de coûts
- vLLM, documentation officielle
- On-Premise vs Cloud: Generative AI Total Cost of Ownership