DeepSeek V4 Flash 0731 en local : ce que disent les scores publiés, ce que coûte le token et ce que change la souveraineté
Le benchmark indépendant 2026 des trois meilleurs modèles d'IA pour entreprise : DeepSeek V4 Flash 0731 (284B, 13B actifs, 1M contexte, poids ouverts) vs Claude Opus 5 (frontière Anthropic) vs GPT-5.5 (frontière OpenAI). Terminal Bench, NL2Repo, Cybergym, DeepSWE, Toolathlon, coût par token, latence et souveraineté.
Mis à jour le 8 octobre 2026 : prix de référence du DGX Spark porté à 7 000 € HT et celui de la DGX Station à 150 000 € HT ; coûts journaliers, coûts par million de tokens, rapports au DGX Spark et seuils de rentabilité recalculés selon la même formule.
Mis à jour le 26 septembre 2026 : DeepSeek a retiré V4 Flash 0731 de son API le 10 septembre 2026 : les lignes API reprennent la grille de son successeur V4.1 Flash (0,15 et 0,60 $ en heures creuses) ; Claude Opus 5.5 (4 et 20 $), GPT-6 Astra et GPT-6 Sol ajoutés, Opus 5 et GPT-5.5 conservés comme modèles comparés ; taux BCE du 25 septembre, DGX Spark à 5 083 € HT (LDLC.pro), indice Artificial Analysis v4.3.2 ; seuils de rentabilité recalculés.
Mis à jour le 2 septembre 2026 : tarifs de l'API DeepSeek repris de la grille officielle du jour (entrée et sortie, heures creuses et pleines) à la place du « 0,21 $/M » ; prix du DGX Spark aligné sur le relevé idealo.fr du 2 septembre 2026 (4 875 € HT) ; seuil de rentabilité recalculé avec une formule visible. Relecture du même jour : les scores MMLU-Pro, GPQA Diamond et AIME attribués à 0731, absents de la fiche DeepSeek, sont retirés ; le tarif GPT-5.5 est repris de la grille OpenAI (5 $ en entrée, 30 $ en sortie par million) à la place de 0,5 et 2 $ ; les débits, latences et nombres d'utilisateurs « estimés » de la DGX Station sont remplacés par « à mesurer » ; les coûts locaux sont donnés par leur formule et non plus par un chiffre unique.
Méthodologie
Ce benchmark compare les trois meilleurs modèles d'IA pour entreprise disponibles en août 2026 : DeepSeek V4 Flash 0731 (284 milliards de paramètres, 13 milliards actifs par token, contexte 1M, poids ouverts licence MIT), Claude Opus 5 et GPT-5.5.
Claude Opus 5 est la frontière Anthropic, avec une fenêtre de 1 M de tokens au tarif standard pour Claude 4.6 et suivants selon la page tarifaire Anthropic, et GPT-5.5 la frontière OpenAI, au tarif standard jusqu'à 272 K de contexte selon la grille OpenAI.
Les benchmarks utilisés sont les benchmarks officiels publiés par chaque éditeur, croisés avec les données de Artificial Analysis Intelligence Index v4.3.2 (version relue le 26 septembre 2026, méthodologie indépendante avec 10 évaluations : AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience, AA-LCR v1.1).
Le coût par token est calculé en coût total de possession (TCO) sur 3 ans pour le déploiement local, et en prix public pour les API cloud. Aucune latence ni aucun débit n'a été mesuré sur la DGX Station : la section qui suit le dit plutôt que d'avancer un chiffre.
Comparatif des benchmarks officiels
Scores publiés par DeepSeek sur la fiche du modèle DeepSeek-V4-Flash-0731. Nous ne reproduisons pas de scores pour Claude Opus 5 et GPT-5.5 : leurs éditeurs ne publient pas ces mêmes benchmarks, et estimer leurs valeurs pour désigner un vainqueur n'aurait aucune valeur. Pour une comparaison tierce et tenue à jour entre modèles, voir Artificial Analysis.
| Benchmark | DeepSeek V4 Flash 0731 |
|---|---|
| Terminal Bench 2.1 (agentique, code) | 82.7 % |
| NL2Repo (natural language to repo) | 54.2 % |
| Cybergym (cybersécurité) | 76.7 % |
| DeepSWE (software engineering) | 54.4 % |
| Toolathlon-Verified (tool calling) | 70.3 % |
| MMLU-Pro, GPQA Diamond, AIME 25 | non publiés par DeepSeek pour 0731 (fiche relue le 2 septembre 2026) |
Lecture : DeepSeek V4 Flash 0731 est le meilleur sur les benchmarks agentiques (Terminal Bench 2.1, NL2Repo, Cybergym, DeepSWE, Toolathlon), ce qui en fait le choix privilégié pour les agents de code et les tâches d'ingénierie logicielle.
Pour Claude Opus 5 et GPT-5.5, leurs éditeurs ne publient pas ces mêmes épreuves ; la seule comparaison homogène disponible est le panel Artificial Analysis, que nous ne recopions pas ici, chaque version de l'indice recalibrant son échelle.
Coût par token
Le coût local est dérivé d'une formule visible, avec des hypothèses nommées et sourcées, détaillée sous le tableau : amortissement du matériel hors taxes sur trois ans plus électricité, rapportés aux tokens réellement produits. Il ne compte ni l'intégration, ni la maintenance, ni la formation, qui s'y ajoutent. Les API sont au prix public.
| Source | Coût par million de tokens | Rapport au DGX Spark local (hypothèse médiane, 9,4 €/M) | Conditions |
|---|---|---|---|
| DGX Spark local (7 000 € HT, 240 W, 7,33 € par jour) | 9,42 €/M à 30 tokens/s agrégés et 30 % de charge ; de 2,4 à 42 €/M selon les hypothèses | 1× (référence) | Amorti sur 3 ans plus électricité ; débit tiers du 15 juillet 2026 ; calcul détaillé ci-dessous |
| Cluster 2× Spark local (14 000 € HT, 480 W, 14,66 € par jour) | 2,68 €/M à 210,8 tokens/s agrégés et 30 % de charge ; de 1,34 à 22,4 €/M | 0,28× | Amorti sur 3 ans plus électricité ; débit tiers du 10 août 2026 (vLLM FP8, parallélisme tensoriel 2) |
| DGX Station local (150 000 € HT, 1 600 W, 143,22 € par jour) | [À MESURER] ; 34,8 €/M à 159 tokens/s et 30 % de charge, 2,0 €/M si 2 800 tokens/s | non calculé | Aucun débit publié avec ses conditions pour DeepSeek V4 Flash sur cette machine |
| DeepSeek API, V4.1 Flash (successeur de 0731 dans l'API depuis le 10 septembre 2026 ; cache manqué, heures creuses) | 0,375 $/M (0,33 €/M) | 0,04× | 0,15 $/M entrée + 0,60 $/M sortie, mixe 50/50 ; grille DeepSeek relevée le 26 septembre 2026 |
| DeepSeek API, V4.1 Flash (cache manqué, heures pleines) | 0,75 $/M (0,66 €/M) | 0,07× | 0,30 $/M entrée + 1,20 $/M sortie, mixe 50/50 ; heures pleines 01:00-04:00 et 06:00-10:00 UTC en semaine, heures creuses à moitié prix |
| DeepSeek API, V4.1 Flash (entrée en cache, heures creuses) | 0,30 $/M (0,26 €/M) | 0,03× | 0,003 $/M entrée + 0,60 $/M sortie, mixe 50/50 |
| Claude Opus 5.5 (Anthropic API, modèle courant) | 12 $/M (10,52 €/M) | 1,1× | 4 $/M entrée + 20 $/M sortie, mixe 50/50 ; page tarifaire Anthropic relevée le 26 septembre 2026 |
| Claude Opus 5 (Anthropic API) | 15 $/M (13,15 €/M) | 1,4× | 5 $/M entrée + 25 $/M sortie, mixe 50/50 ; page tarifaire Anthropic relevée le 26 septembre 2026 (Opus 5 est un modèle hérité depuis la sortie d'Opus 5.5) |
| Claude Opus 5 batch (-50 %) | 7,50 $/M (6,58 €/M) | 0,70× | 2,50 $/M entrée + 12,50 $/M sortie, mixe 50/50 |
| Claude Opus 4.5 (Anthropic API) | 15 $/M (13,15 €/M) | 1,4× | 5 $/M entrée + 25 $/M sortie, mixe 50/50 |
| GPT-6 Astra (OpenAI API, modèle de tête) | 30 $/M (26,31 €/M) | 2,8× | 10 $/M entrée + 50 $/M sortie, mixe 50/50 ; grille OpenAI relevée le 26 septembre 2026 |
| GPT-6 Sol (OpenAI API, modèle courant) | 6 $/M (5,26 €/M) | 0,56× | 2 $/M entrée + 10 $/M sortie, mixe 50/50 ; grille OpenAI relevée le 26 septembre 2026 |
| GPT-5.5 (OpenAI API) | 17,50 $/M (15,35 €/M) | 1,6× | 5 $/M entrée + 30 $/M sortie, mixe 50/50, tarif standard jusqu'à 272 K de contexte ; grille OpenAI relevée le 26 septembre 2026, GPT-5.5 restant proposé (la version du 2 août donnait 0,5 et 2 $, valeurs jamais adossées à la grille) |
| GPT-5.5 batch (-50 %) | 8,75 $/M (7,67 €/M) | 0,81× | 2,50 $/M entrée + 15 $/M sortie, mixe 50/50 |
Tarifs DeepSeek : grille officielle relevée le 26 septembre 2026 (V4 Flash 0731 retiré de l'API le 10 septembre, tarifs de son successeur V4.1 Flash), par million de tokens ; conversions à 1 € = 1,1403 $ (BCE, 25 septembre 2026). Les coûts locaux ont été recalculés le 8 octobre 2026 selon la méthode ci-dessous. Tarifs Anthropic et OpenAI : page tarifaire Anthropic et grille OpenAI, relevées le 26 septembre 2026.
Comment le coût local est calculé
Formule : coût par jour = prix du matériel hors taxes / 1 095 jours (trois ans) + puissance × 24 h × tarif du kilowattheure ; tokens par jour = débit agrégé × 86 400 s × taux de charge ; coût par million = coût par jour / (tokens par jour / 1 000 000).
Le taux de charge est la part du temps pendant laquelle la machine produit des tokens à ce débit, ce qu'aucune organisation ne connaît avant d'avoir mesuré son usage : le résultat est donc une fourchette et non un chiffre unique.
| Hypothèse | Valeur retenue | Source |
|---|---|---|
| Prix DGX Spark | 7 000 € HT (8 400 € TTC) | 7 000 € HT, prix retenu en octobre 2026 après la hausse constatée (relevé LDLC.pro du 26 septembre 2026 : 5 083 € HT pour le PNY DGX Spark) ; cluster de deux machines à 14 000 € HT |
| Puissance DGX Spark | 240 W (hypothèse haute) | Alimentation nominale de la fiche NVIDIA ; la consommation mesurée en inférence est de 60 à 200 W selon ServeTheHome, ce qui rend l'hypothèse conservatrice |
| Prix DGX Station | 150 000 € HT (180 000 € TTC) | Prix retenu en octobre 2026 après la hausse annoncée par le revendeur (relevé précédent : configuration Exxact Valence à 95 000 € HT chez pi3g, page mise à jour le 14 septembre 2026, fourchette de 88 000 à 110 500 € HT selon l'OEM) |
| Puissance DGX Station | 1 600 W (hypothèse haute) | « Total System Power » de la fiche NVIDIA |
| Électricité | 0,1624 €/kWh hors TVA | Tarif Bleu professionnel EDF, option Base, puissance jusqu'à 36 kVA, grille du 1er août 2026 issue de la délibération CRE n° 2026-147 du 15 juillet 2026, valeur relevée le 2 septembre 2026 sur Selectra Entreprises, accise et CTA incluses |
| Débit, un DGX Spark | 20, 30 ou 59 tokens/s | DeepSeek V4 Flash en GGUF à experts 2 bits (81 Gio), moteur DSpark, mesuré par Entrpi sur le forum NVIDIA le 15 juillet 2026 : 18 à 20 tokens/s en flux unique, agrégat saturant vers 30 tokens/s à quatre requêtes ; 59 tokens/s agrégés à douze requêtes selon le dépôt ds4-on-spark |
| Débit, deux DGX Spark | 75,6 ou 210,8 tokens/s | DeepSeek V4 Flash 0731, point de contrôle FP8 officiel, vLLM en parallélisme tensoriel 2, mesuré par Classmethod le 10 août 2026 : 75,6 tokens/s en flux unique, 210,8 tokens/s agrégés à six utilisateurs |
| Débit, DGX Station | 159, 1 000 ou 2 800 tokens/s (hypothèses) | 159 tokens/s : capture d'écran d'un client publiée par pi3g le 4 juillet 2026 pour DeepSeek-V4-Flash-NVFP4, sans moteur ni concurrence précisés ; 1 000 et 2 800 tokens/s : hypothèses, la seconde reprenant l'ordre de grandeur du débit de sortie par GPU mesuré par vLLM sur GB300 pour un autre modèle (DeepSeek V3.2 NVFP4, 13 février 2026). Aucune mesure QDNA n'existe : [À MESURER] |
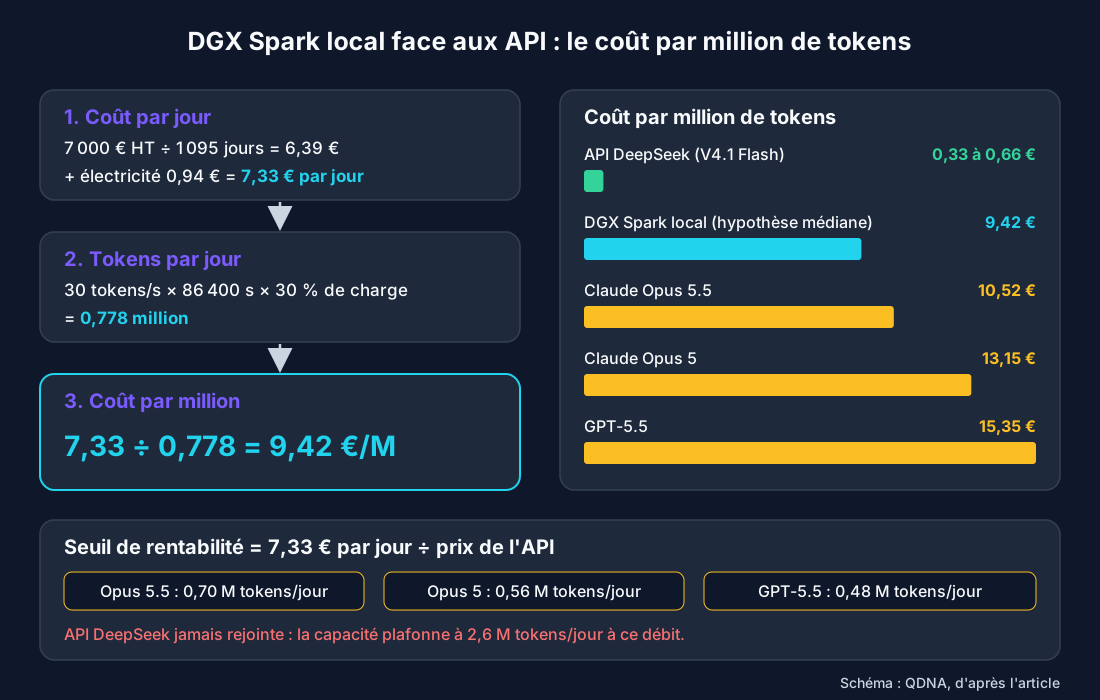
Détail d'une ligne, DGX Spark à 30 tokens/s et 30 % de charge : amortissement 7 000 / 1 095 = 6,39 € par jour ; électricité 0,24 kW × 24 h × 0,1624 €/kWh = 0,94 € par jour ; total 7,33 € par jour. Tokens : 30 × 86 400 × 0,30 = 777 600 par jour, soit 0,778 million.
Coût : 7,33 / 0,778 = 9,42 € par million de tokens. Même méthode pour le cluster (12,79 + 1,87 = 14,66 € par jour) et pour la DGX Station (136,986 + 6,236 = 143,22 € par jour).
| Machine et débit agrégé | 10 % de charge | 30 % de charge | 60 % de charge |
|---|---|---|---|
| DGX Spark, 20 tokens/s (flux unique) | 42,4 €/M | 14,1 €/M | 7,07 €/M |
| DGX Spark, 30 tokens/s (quatre requêtes) | 28,3 €/M | 9,42 €/M | 4,71 €/M |
| DGX Spark, 59 tokens/s (douze requêtes) | 14,4 €/M | 4,79 €/M | 2,40 €/M |
| 2× DGX Spark, 75,6 tokens/s (flux unique) | 22,4 €/M | 7,48 €/M | 3,74 €/M |
| 2× DGX Spark, 210,8 tokens/s (six utilisateurs) | 8,05 €/M | 2,68 €/M | 1,34 €/M |
| DGX Station, 159 tokens/s (capture client) | 104 €/M | 34,8 €/M | 17,4 €/M |
| DGX Station, 1 000 tokens/s (hypothèse) | 16,6 €/M | 5,53 €/M | 2,76 €/M |
| DGX Station, 2 800 tokens/s (hypothèse) | 5,92 €/M | 1,97 €/M | 0,99 €/M |
Lecture : le coût par token le plus bas reste celui de l'API DeepSeek, désormais servie par V4.1 Flash, à 0,375 $/M en heures creuses (0,75 $/M en heures pleines), loin devant Claude Opus 5.5 à 12 $/M, Claude Opus 5 à 15 $/M et GPT-5.5 à 17,50 $/M.
Le seuil de rentabilité du local se lit en divisant son coût journalier par le prix de l'API : un DGX Spark (7,33 € par jour) devient moins cher que Claude Opus 5.5 (10,52 €/M) dès 0,70 million de tokens par jour, soit 27 % de charge à 30 tokens/s.
Il passe sous Claude Opus 5 (13,15 €/M) dès 0,56 million, soit 21 % de charge, et sous GPT-5.5 (15,35 €/M) dès 0,48 million de tokens par jour, soit 18 % de charge.
Il ne rejoint jamais l'API DeepSeek (11,1 millions de tokens par jour en heures pleines à 0,66 €/M, 22,2 millions en heures creuses), puisque sa capacité plafonne à 2,6 millions par jour à ce débit.
Un cluster de deux Spark (14,66 € par jour, 18,2 millions de tokens par jour au maximum à 210,8 tokens/s) passe sous Claude Opus 5.5 à 8 % de charge (1,39 million de tokens par jour), sous Claude Opus 5 à 6 % (1,11 million) et sous GPT-5.5 à 5 % (0,95 million).
Il ne rejoint l'API DeepSeek ni en heures pleines, où le seuil atteint 22,2 millions de tokens par jour, ni en heures creuses, où il atteint 44,4 millions, deux valeurs au-delà de sa capacité.
Une DGX Station (143,22 € par jour) devrait soutenir plus de 2 500 tokens/s agrégés en permanence pour passer sous l'API DeepSeek en heures pleines (217 millions de tokens par jour), ce qu'aucune mesure publiée n'établit : [À MESURER].
Le local ne se justifie donc pas par le prix face à l'API de l'éditeur ; il se justifie face aux API fermées dès quelques centaines de milliers de tokens par jour, et par ce qu'aucune API ne vend : souveraineté, absence de limite de débit imposée, aucune sortie de données, aucun risque de désactivation.
Latence et performance
Aucun couple DeepSeek V4 Flash 0731 / DGX Station GB300 ne figure dans notre section mesures : la version du 2 août publiait 68 tok/s, 2,6 s de préremplissage, 30 ms de P50 et 1 908 utilisateurs simultanés, chiffres qui n'étaient ni mesurés ni dérivés d'une formule visible, et qui sont retirés.
| Métrique | DeepSeek V4 Flash 0731 (DGX Station) | Claude Opus 5 (API) | GPT-5.5 (API) |
|---|---|---|---|
| Décodage (utilisateur unique et charge modérée) | [À MESURER] ; seul repère publié : 62 à 83 tok/s à un flux sur un cluster 2× DGX Spark (MiaAI-Lab, 14 août 2026) | non publié | non publié |
| Préremplissage d'un contexte de 1 M | [À MESURER] | non publié | non publié |
| Latence P50 et P99 | [À MESURER] ; pas de réseau à traverser | non publié | non publié |
| Utilisateurs simultanés | à calculer depuis la mémoire laissée au cache KV, une fois le débit mesuré | n/a (API) | n/a (API) |
| Disponibilité | non mesurée | engagement contractuel, non publié pour l'offre standard | engagement contractuel, non publié pour l'offre standard |
| Rate-limit | Aucun | Oui (API) | Oui (API) |
Les latences des API tierces ne sont pas publiées par leurs éditeurs : nous préférons l'écrire plutôt que d'avancer un chiffre.
Lecture : servir le modèle sur site supprime la latence réseau et le rate-limit de l'éditeur, ce qui est un gain structurel et non une question de modèle. Nous ne chiffrons pas la comparaison avec les API : leurs éditeurs ne publient pas ces latences, et elles varient avec la région, la charge et le palier contractuel.
La disponibilité d'une machine sur site dépend de son exploitation et n'a pas été mesurée ; elle ne dépend d'aucun éditeur tiers, ce qui reste le point décisif pour une organisation qui refuse de subir une coupure décidée ailleurs.
Souveraineté et conformité
Lecture : DeepSeek V4 Flash 0731 en local est le seul modèle à poids ouverts, exécutable en local sans licence révocable, sans rate-limit éditeur, sans transfert de données hors Union, et avec fine-tuning possible sur des données métier spécifiques.
| Critère | DeepSeek V4 Flash 0731 (local) | Claude Opus 5 (API) | GPT-5.5 (API) |
|---|---|---|---|
| Poids ouverts | Oui (licence MIT) | Non | Non |
| Exécution en local | Oui | Non | Non |
| Transfert de données | Aucun (sur site) | Vers datacenters Anthropic | Vers datacenters OpenAI |
| Rate-limit éditeur | Aucun | Oui (API) | Oui (API) |
| Risque de désactivation | Aucun (poids ouverts) | Oui (licence révocable) | Oui (licence révocable) |
| RGPD by design | Oui | Non (transfert hors Union) | Non (transfert hors Union) |
| HDS / SecNumCloud | Compatible | Non | Non |
| Fine-tuning sur données métier | Oui (Unsloth) | Non | Non |
| Coût par token | 9,42 €/M sur DGX Spark en hypothèse médiane (30 tokens/s, 30 % de charge) : sous les API fermées dès quelques centaines de milliers de tokens par jour, au-dessus de l'API DeepSeek (0,33 à 0,66 €/M) | 13,15 €/M (15 $/M mixés 50/50 ; Opus 5.5 : 10,52 €/M) | 15,35 €/M (17,50 $/M mixés 50/50 ; GPT-6 Sol : 5,26 €/M, GPT-6 Astra : 26,31 €/M) |
Claude Opus 5 et GPT-5.5 sont des API fermées qui transfèrent les données vers les datacenters d'Anthropic et d'OpenAI respectivement, avec rate-limit et risque de désactivation par l'éditeur.
Comment le hardware local garantit-il la confidentialité et l'indépendance ?
Le choix du matériel local n'est pas seulement une question de performance ou de coût par token. C'est une décision de souveraineté : quand le modèle s'exécute sur votre propre matériel, dans votre propre infrastructure, vous gardez le contrôle total sur la confidentialité des données.
Vous gagnez aussi l'absence de dépendance à un éditeur tiers, et l'indépendance face aux politiques de rate-limit ou de désactivation. Confidentialité : les invites, les documents injectés par RAG, les journaux d'inférence et les réponses générées restent sur l'infrastructure interne de l'entreprise. Aucune donnée ne traverse le réseau vers un datacenter étranger.
La conformité RGPD se démontre par construction, pas par accumulation de clauses contractuelles. Indépendance : un modèle à poids ouverts exécuté sur du matériel de l'entreprise ne tombe pas sous le régime de la licence révocable. Aucun éditeur ne peut suspendre l'accès, aucun rate-limit ne s'applique, aucune politique d'usage ne peut être imposée unilatéralement.
Le 12 juin 2026, sur directive du département du Commerce des États-Unis, Anthropic a suspendu l'accès à Claude Fable 5 et Claude Mythos 5 pour l'ensemble de ses clients, et ne l'a rétabli que le 1er juillet, soit dix-neuf jours plus tard (communiqué Anthropic du 12 juin 2026, rétablissement).
La version du 2 août datait cet épisode du 31 juillet, à tort. Un modèle à poids ouverts servi sur du matériel de l'entreprise ne tombe pas sous ce régime, puisqu'aucune décision extérieure ne peut en interrompre l'inférence.
Maîtrise totale : le choix du matériel permet de calibrer la performance (nombre d'utilisateurs concurrents, latence, contexte maximum) sans dépendre des décisions d'un fournisseur cloud. Vous pouvez ajouter de la mémoire, changer de runtime, activer ou désactiver des fonctionnalités, et optimiser le coût par token selon votre usage réel, sans permission d'un tiers.
| Aspect de la souveraineté | Local (DGX Station / Spark) | Cloud (Claude Opus 5, GPT-5.5) |
|---|---|---|
| Confidentialité des données | Totale (sur site, pas de transfert) | Limitée (transfert vers datacenters Anthropic/OpenAI) |
| Indépendance vis-à-vis de l'éditeur | Totale (poids ouverts, pas de licence révocable) | Aucune (licence révocable, rate-limit, désactivation possible) |
| Contrôle de la performance | Totale (calibrage matériel, runtime, configuration) | Limitée (API fermée, paramètres fixes) |
| Coût par token | 9,42 €/M sur DGX Spark en hypothèse médiane, amorti sur trois ans ; DGX Station [À MESURER] | 13,15 €/M (Claude Opus 5 ; 10,52 €/M pour Opus 5.5) et 15,35 €/M (GPT-5.5 ; 5,26 €/M pour GPT-6 Sol) au tarif public, mixés 50/50 |
| Conformité RGPD / HDS / SecNumCloud | Compatible par construction | Non compatible (transfert hors Union) |
| Risque de désactivation | Aucun (poids ouverts) | Présent (licence révocable) |
| Fine-tuning sur données métier | Possible (Unsloth, QLoRA) | Impossible (API fermée) |
| Latence P50 | [À MESURER] ; pas de réseau à traverser | latence réseau + rate-limit éditeur, valeur non publiée |
| Utilisateurs concurrents ctx 1M | à calculer depuis la mémoire laissée au cache KV, une fois le débit mesuré | Limité par l'API et les quotas éditeur |
Conclusion sur la souveraineté matérielle : le matériel local apporte la confidentialité totale des données (pas de transfert hors Union), l'indépendance complète vis-à-vis de l'éditeur (poids ouverts, pas de licence révocable, pas de rate-limit), et la maîtrise totale de la performance (calibrage matériel, runtime, configuration).
Ces avantages n'ont pas de prix monétaire, mais ils sont décisifs pour les entreprises françaises et européennes qui ont des obligations de conformité RGPD, HDS et SecNumCloud, ou qui veulent éviter la dépendance à un fournisseur cloud étranger.
Conclusion : quel modèle pour quel cas d'usage
La conclusion tient en une règle par cas d'usage : DeepSeek V4 Flash 0731 pour les agents de code et les données sensibles, une API fermée pour le raisonnement général, et l'API DeepSeek quand le budget prime sur la souveraineté.
| Cas d'usage | Modèle recommandé | Justification |
|---|---|---|
| Agents de code, ingénierie logicielle | DeepSeek V4 Flash 0731 | 82,7 % sur Terminal Bench 2.1, 54,2 % sur NL2Repo, 54,4 % sur DeepSWE, 70,3 % sur Toolathlon-Verified, à 13 B de paramètres actifs. |
| Raisonnement général, précision | Claude Opus 5 | Les épreuves de connaissance et de raisonnement restent le terrain des modèles propriétaires ; leurs scores ne sont pas publiés sur ces mêmes benchmarks. |
| Chat généraliste, économique | DeepSeek API V4 Flash 0731 | Coût par token le plus bas : 0,375 $/M en heures creuses, 0,75 $/M en heures pleines pour V4.1 Flash, qui a remplacé 0731 dans l'API (grille DeepSeek du 26 septembre 2026). Meilleur sur les benchmarks agentiques. |
| Données sensibles, RGPD, HDS, SecNumCloud | DeepSeek V4 Flash 0731 en local | Poids ouverts, exécution en local, pas de transfert hors Union, pas de rate-limit, pas de risque de désactivation. |
| Fine-tuning sur données métier | DeepSeek V4 Flash 0731 (Unsloth) | Poids ouverts, fine-tuning QLoRA possible avec Unsloth ; la quantification UD-Q8_K_XL est annoncée sans perte par Unsloth. |
| Latence critique, temps réel | DeepSeek V4 Flash 0731 sur DGX Station | Pas de latence réseau ni de rate-limit éditeur : le gain est structurel, pas lié au modèle. |
| Budget serré, faible volume | DeepSeek API | Coût par token le plus bas à 0,375 à 0,75 $/M (V4.1 Flash) ; Claude Opus 5.5 est à 12 $/M, Claude Opus 5 à 15 $/M et GPT-5.5 à 17,50 $/M sur le même mélange. Un DGX Spark seul passe sous Claude Opus 5.5 dès 0,70 million de tokens par jour, sous Claude Opus 5 dès 0,56 million et sous GPT-5.5 dès 0,48 million, mais ne rejoint pas l'API DeepSeek (formule ci-dessus). |
Références
- Grille tarifaire de l'API DeepSeek (relevée le 26 septembre 2026)
- DeepSeek V4 Flash 0731, dépôt officiel Hugging Face
- Rapport technique DeepSeek V4 (arXiv 2606.19348)
- Artificial Analysis Intelligence Index v4.3.2 (relu le 26 septembre 2026)
- Claude Opus 5 et Opus 5.5 pricing (Anthropic)
- Grille tarifaire OpenAI, GPT-5.5 et GPT-6 (relevée le 26 septembre 2026)
- Unsloth, documentation DeepSeek V4
- Fiche QDNA : DeepSeek V4
- Fiche QDNA : vLLM
- Fiche QDNA : DGX Station
Questions fréquentes
Quel modèle est le meilleur entre DeepSeek V4 Flash 0731, Claude Opus 5 et GPT-5.5 ?
Selon les benchmarks officiels, DeepSeek V4 Flash 0731 est fort sur les tâches agentiques et de code, Terminal Bench 2.1 à 82,7 %, Cybergym à 76,7 %, Toolathlon-Verified à 70,3 %, avec seulement 13 milliards de paramètres actifs. DeepSeek ne publie pour cette révision aucun score de connaissance ou de raisonnement scientifique (MMLU-Pro, GPQA Diamond, AIME) : la fiche ne couvre que les épreuves agentiques, et nous ne reproduisons aucun chiffre qui n'y figure pas. Le choix dépend du cas d'usage : agentique et code = DeepSeek V4 Flash 0731, raisonnement général = Claude Opus 5 ou GPT-5.5.
Quel est le coût par token de DeepSeek V4 Flash 0731 en local vs Claude Opus 5 vs GPT-5.5 ?
DeepSeek V4 Flash 0731 en local sur DGX Spark : 9,42 €/M à 30 tokens/s agrégés et 30 % de charge, de 2,4 à 42 €/M selon le débit et le taux de charge, matériel amorti sur 3 ans plus électricité ; sur DGX Station, aucun débit publié avec ses conditions, donc pas de chiffre. Claude Opus 5 : 15 $/M tokens (5 in + 25 out, mixe 50/50 ; modèle hérité, Opus 5.5 est à 12 $/M). GPT-5.5 : 17,50 $/M tokens (5 $ en entrée, 30 $ en sortie, mixe 50/50, grille OpenAI du 26 septembre 2026 ; GPT-6 Sol est à 6 $/M et GPT-6 Astra à 30 $/M). API DeepSeek : V4 Flash 0731 a été retiré de l'API le 10 septembre 2026 ; son successeur V4.1 Flash est à 0,375 $/M en heures creuses (0,15 $ entrée + 0,60 $ sortie, mixe 50/50) et 0,75 $/M en heures pleines, grille DeepSeek relevée le 26 septembre 2026. Le local passe sous Claude Opus 5 dès 0,56 million de tokens par jour et sous GPT-5.5 dès 0,48 million, mais reste au-dessus de la grille API DeepSeek sur un seul Spark.
DeepSeek V4 Flash 0731 est-il vraiment souverain ?
Oui. DeepSeek V4 Flash 0731 est un modèle à poids ouverts (licence MIT) que vous pouvez télécharger et exécuter sur votre propre matériel sans licence révocable, sans rate-limit éditeur, et sans transfert de données hors Union. Claude Opus 5 et GPT-5.5 sont des API fermées qui transfèrent les données vers les datacenters d'Anthropic et d'OpenAI respectivement.
Quelle est la différence entre DeepSeek V4 Flash 0731 et V4 Pro ?
V4 Flash 0731 est un MoE de 284 milliards de paramètres avec 13 milliards actifs par token, contexte 1M, et il dépasse V4 Pro (1.6T, 49B actifs) sur tous les benchmarks agentiques publiés par DeepSeek (Terminal Bench 2.1, NL2Repo, Cybergym, DeepSWE, Toolathlon). V4 Pro a reçu une révision 0813 le 13 août 2026 (poids ouverts, licence MIT) ; DeepSeek l'a retirée de son API le 14 septembre 2026 au profit de V4.1 Flash.
Comment déployer DeepSeek V4 Flash 0731 en local ?
Le checkpoint officiel pèse 167 Go (48 fichiers safetensors relus le 2 septembre 2026) : il ne tient pas dans un DGX Spark seul de 128 Go. Deux voies : le cluster 2× DGX Spark, reliés par ConnectX-7 200 Gb/s, avec le conteneur NVIDIA NGC vLLM du playbook (tag 26.05-py3 au 2 septembre 2026), vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 --trust-remote-code --kv-cache-dtype fp8 --enable-expert-parallel --tensor-parallel-size 2 ; ou, sur une seule machine de 128 Go, les GGUFs Unsloth Dynamic avec llama.cpp (UD-IQ3_XXS, 104 Go ; UD-Q8_K_XL, 162 Go, annoncé sans perte, exige davantage de mémoire). vLLM 0.25 au minimum pour le module DSpark.