Cybersécurité et IA locale : s'attaquer soi-même pour se défendre
Un laboratoire personnel peut se tester comme le ferait un attaquant, avec ses propres outils et des modèles qui tournent sur ses machines, puis transformer ce qu'il apprend en défenses mesurées. Voici l'outillage, la méthode et ce que publient les éditeurs de modèles.
Pourquoi s'attaquer soi-même plutôt qu'attendre l'attaque ?
Une défense écrite sans connaître les attaques ressemble à une serrure posée sans savoir comment on crochète une porte. Le principe du test d'intrusion, ou pentest, consiste donc à rejouer contre soi les gestes d'un adversaire, dans un cadre autorisé, pour découvrir ses faiblesses avant qu'un autre ne les exploite.
Les agents IA changent l'échelle de cet exercice. Un agent outillé enchaîne la reconnaissance, l'essai et le compte rendu sans se lasser, ce qui profite autant à l'attaquant qu'au défenseur. Il devient alors raisonnable de confier à ses propres agents une partie du travail d'audit, à condition de garder la main sur le périmètre et de tout tracer.
Le choix de faire tourner les modèles en local suit la même logique de maîtrise. Les journaux, les constats et les traces d'attaque décrivent les faiblesses d'un système, et ce sont précisément les données qu'on ne veut pas confier à un fournisseur. Le laboratoire privilégie donc des modèles hébergés sur ses propres machines, et masque les données sensibles quand une tâche part vers un modèle extérieur.
Quels outils pour tester ses propres défenses ?
Le cœur offensif du laboratoire s'appelle save-rs, un gestionnaire d'environnements Docker de test d'intrusion développé en Rust et conçu pour fonctionner hors ligne. Les opérations passent par l'API Docker plutôt que par un shell, et toutes ses cibles de compilation interdisent les blocs unsafe hors des tests.
La sécurité de l'outil lui-même compte autant que ce qu'il permet de tester. Les données sensibles sont chiffrées au repos en AES-256-GCM avec Argon2id, les fichiers de configuration reçoivent des droits réservés à leur propriétaire juste après leur écriture, et un journal d'audit chaîné par SHA-256 conserve la trace vérifiable de chaque action effectuée pendant une mission.
save-rs expose ses capacités par le protocole MCP, le standard qui permet à un agent IA d'appeler des outils. Le relevé du 30 octobre 2026 compte 1 446 outils exposés par le serveur en service, branchés sur le concentrateur d'outils du laboratoire pour que n'importe quel agent local puisse les invoquer avec les mêmes garde-fous.
| Famille d'outils | À quoi elle sert |
|---|---|
| Conteneurs et espaces de travail | Créer, isoler et détruire l'environnement de chaque mission |
| Périmètre et règles d'engagement | Vérifier qu'une cible fait bien partie du périmètre autorisé avant toute action |
| Preuves et rapports | Collecter les éléments, rédiger les constats, produire le rapport final |
| Mémoire de mission | Prendre des notes, reprendre une mission interrompue, suivre son état |
| Audit des systèmes d'IA | Éprouver une base vectorielle, un RAG ou la configuration d'un agent |
| Équipe rouge contre les LLM | Mesurer la résistance d'un modèle aux attaques documentées |
Comment MITRE ATT&CK et ATLAS structurent-ils l'outillage ?
MITRE ATT&CK est le référentiel public des tactiques et techniques observées chez les attaquants réels, chacune repérée par un identifiant. MITRE ATLAS en est le pendant pour les systèmes d'IA, avec des techniques propres aux modèles comme l'empoisonnement de données ou l'injection de consignes.
Rattacher chaque outil à ces référentiels donne une carte lisible de ce que le laboratoire sait éprouver. Dans les descriptions des outils, 172 citent au moins une technique ATT&CK, pour 177 techniques distinctes, et 113 citent ATLAS, pour 110 identifiants distincts. Un même outil peut citer plusieurs techniques, ce qui explique l'écart.
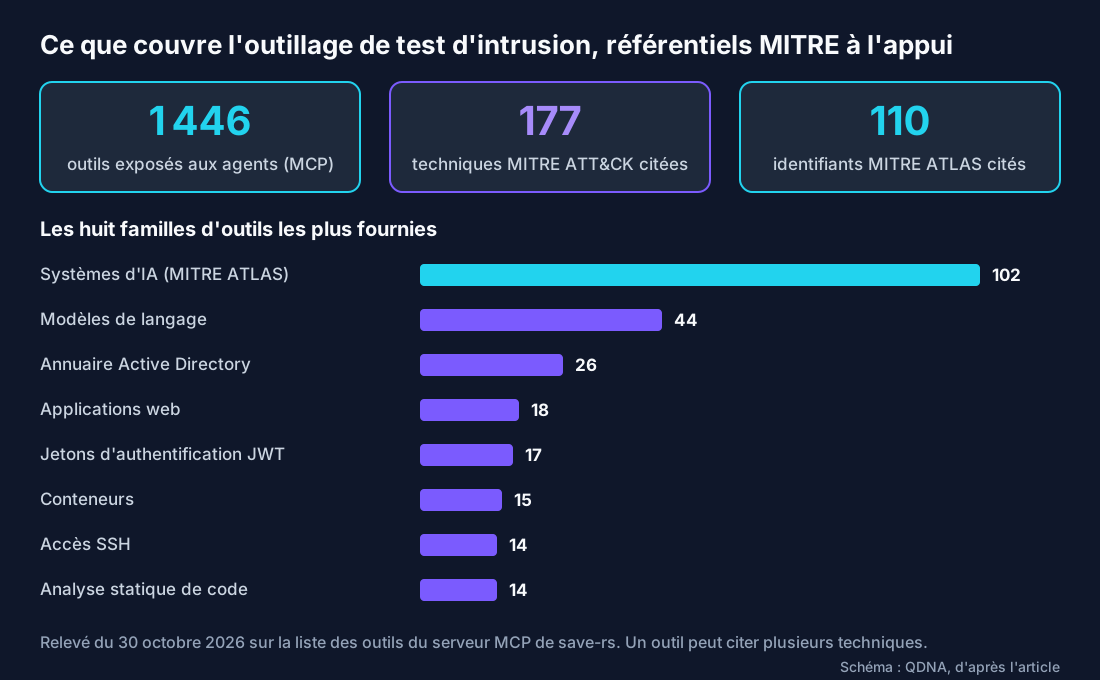
Un module dédié rassemble 26 outils d'équipe rouge contre les modèles de langage, conçus comme un banc défensif. Il s'appuie sur des projets ouverts reconnus, comme garak de NVIDIA, PyRIT de Microsoft ou promptfoo, et range chaque essai sous une technique ATT&CK ou ATLAS pour qu'une équipe de défense mesure sa posture.
Comment l'outillage apprend-il de chaque essai ?
Chaque technique apprise est consignée dans une fiche réutilisable que l'agent relit avant d'agir, ce qui la transforme en brique de savoir plutôt qu'en souvenir diffus. Le laboratoire compte 67 familles de fiches, qui vont de l'audit de code à la surveillance des journaux en passant par les protocoles des agents.
Ces fiches se nourrissent d'épreuves publiques. Hackropole, l'archive d'entraînement de l'ANSSI qui republie les épreuves du France Cybersecurity Challenge, sert de terrain de jeu : 36 épreuves y sont validées par un drapeau concordant, et chacune produit un compte rendu, une leçon et, si la technique est nouvelle, une fiche.
Pour mesurer les progrès sur des tâches plus difficiles, le laboratoire s'appuie sur Cybench, un banc académique de 40 épreuves professionnelles de capture de drapeau. Il couvre la cryptographie, le web, la rétro-ingénierie et l'analyse forensique, ce qui force l'agent à sortir de sa zone de confort.
Le dernier étage est un modèle local spécialisé, dérivé d'un modèle ouvert de taille moyenne et affiné sur les traces de l'outillage par adaptateurs LoRA. Il tourne sur une seule carte graphique, sans dépendre d'un service extérieur. La méthode est détaillée dans l'article sur l'entraînement d'un modèle local.
Où s'exercer sans toucher à des tiers ?
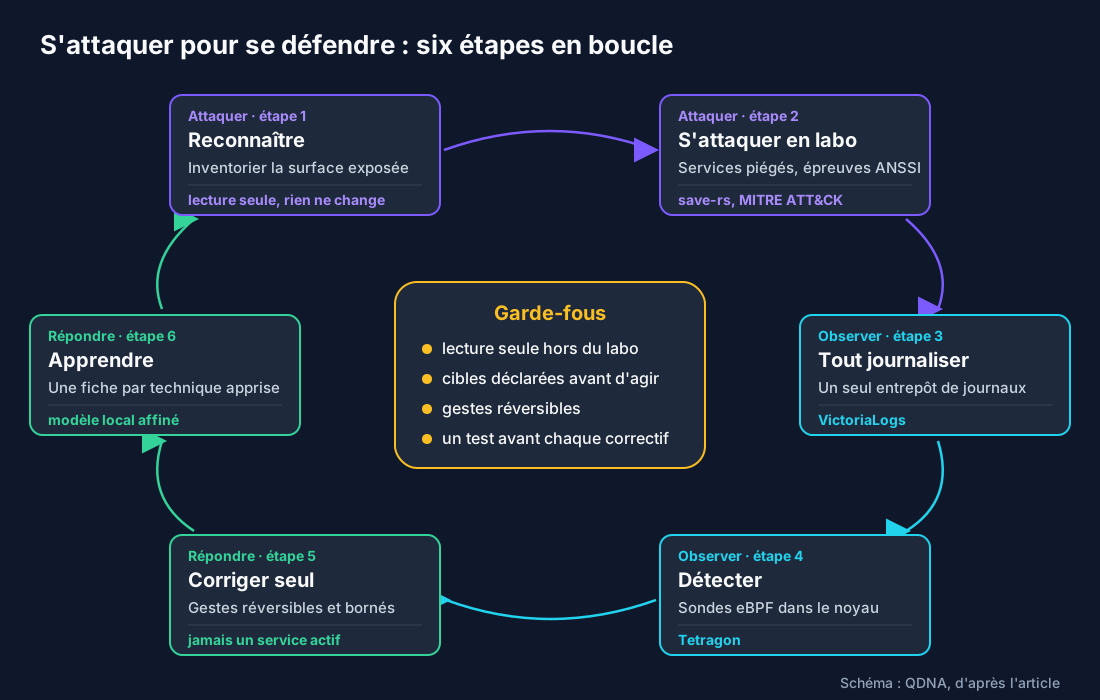
Les essais offensifs ne visent jamais des tiers. Ils tournent contre un laboratoire de services volontairement vulnérables, isolés dans des conteneurs, et contre des épreuves publiées pour l'entraînement. Chaque campagne autonome fonctionne dans son propre conteneur, et un contrôle de périmètre vérifie que chaque cible a bien été déclarée avant d'agir.
Le même outillage peut auditer une infrastructure réelle, à condition de rester en lecture seule. La méthode consiste à répartir les domaines entre plusieurs modèles, locaux et distants, puis à croiser leurs constats pour qu'aucun modèle ne gonfle seul une gravité. Les résultats d'un tel audit ne se publient pas : ils se corrigent.
Comment se défendre : centraliser, détecter, corriger ?
La première règle de la défense tient en une phrase : tout journaliser au même endroit. Un entrepôt de journaux comme VictoriaLogs, joignable depuis la seule machine qui l'héberge, reçoit les traces du système, des sondes et des agents, et les garde assez longtemps pour remonter le fil d'un incident plusieurs semaines après.
La détection repose sur des sondes eBPF, ces petits programmes vérifiés que le noyau Linux exécute au plus près des événements. Un outil comme Tetragon suit les lancements de programmes, les élévations de privilèges et les connexions sortantes, tandis qu'un filtre réseau peut bloquer au niveau du noyau les connexions vers des adresses jugées dangereuses.
Cette détection reste heuristique et produit des faux positifs, souvent des services commerciaux ordinaires pris pour des fuites. Chaque faux positif corrigé devient un test de non-régression, pour qu'il ne revienne pas à la mise à jour suivante. Sans cette discipline, l'alerte finit ignorée, ce qui coûte plus cher qu'une absence d'alerte.
La correction automatique est volontairement bridée. Un superviseur passe à intervalle régulier sur les services et ne s'autorise que des gestes réversibles, comme démarrer une unité arrêtée, avec un nombre borné de réparations par passe. Il ne redémarre jamais un service déjà actif et espace ses tentatives pour ne pas aggraver une panne.
Les agents IA ont eux aussi leurs garde-fous, car un agent qui exécute des commandes est une surface d'attaque. Les suppressions dangereuses sont filtrées avant exécution, les commandes tournent sous un confinement du noyau, et les requêtes sortantes sont inspectées pour y repérer une clé ou un secret avant de quitter la machine.
Le reste de la chaîne suit la même discipline. Les secrets sont servis par un coffre comme OpenBao plutôt que stockés en clair, la passerelle des modèles vérifie l'empreinte de ses fichiers avant de démarrer, et un filtre masque les données personnelles des requêtes destinées à un modèle extérieur.
Quelles limites garder en tête ?
Une telle boucle n'est jamais vraiment fermée, et le dire fait partie de la méthode. Consolider les alertes en un flux unique, corréler les sources entre elles et confier la lecture des journaux de détection à un modèle local restent des chantiers difficiles, que peu de dispositifs, même professionnels, mènent jusqu'au bout.
Le chaînon le plus important est aussi le plus délicat : transformer automatiquement un constat d'auto-attaque en règle de défense. La prudence veut qu'un humain valide ce passage, puis qu'un test qui échoue avant le correctif et réussit après conditionne chaque déploiement, avec un retour arrière prêt en cas d'échec.
Que publient les éditeurs sur les capacités cyber de leurs modèles ?
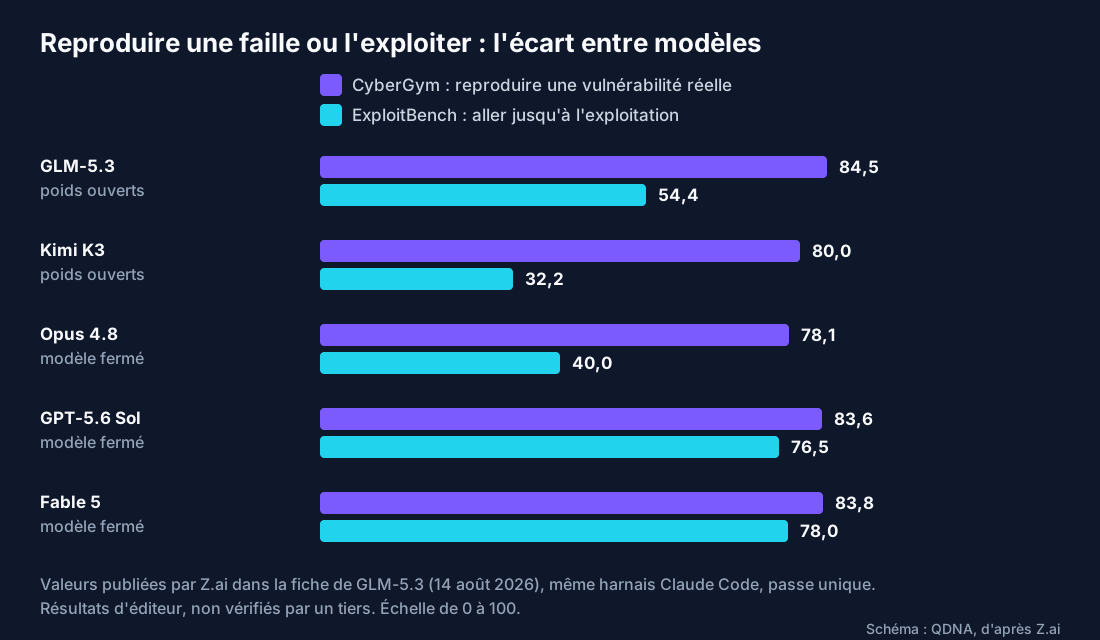
En 2026, les éditeurs de modèles à poids ouverts ont pris l'habitude de publier leurs résultats sur des bancs de cybersécurité agentiques. CyberGym demande de reproduire des vulnérabilités réelles trouvées par fuzzing dans des logiciels libres, tandis qu'ExploitGym et ExploitBench visent l'étape suivante, l'exploitation, dans des environnements prévus pour l'évaluation.
Ces chiffres ne se comparent qu'avec prudence, car chaque éditeur choisit son harnais, son effort de raisonnement et le nombre de tâches. Le tableau suivant distingue donc les résultats publiés par l'éditeur lui-même et les mesures d'un évaluateur indépendant, plus basses dans les cas comparables relevés ici.
| Modèle et licence | Résultat cyber publié, et qui l'a mesuré |
|---|---|
| GLM-5.3 (Z.ai, licence GLM-5.3) | CyberGym 84,5 %, passe unique sur 1 507 tâches ; ExploitBench 54,4 %. Publié par l'éditeur. |
| DeepSeek V4.1 Flash (DeepSeek, MIT) | CyberGym 88,1 et SEC-Bench Pro 62,8, en Pass@1. Publié par l'éditeur. |
| DeepSeek V4.1 Flash 1017 (DeepSeek, MIT) | 85 vulnérabilités reproduites sur un sous-ensemble de 100, contre 82 pour la version précédente. Mesuré par Averlon. |
| DeepSeek V4 Pro 0813 (DeepSeek, MIT) | CyberGym 83,3 selon l'éditeur, 53,7 % sur la cohorte commune de 697 tâches de Fireworks. Publié par l'éditeur, puis mesuré par Fireworks. |
| Kimi K3 (Moonshot AI, licence Kimi K3) | ExploitBench 32 % ; étape 17 sur 32 d'un scénario d'attaque simulé, en moyenne. Mesuré par l'AISI britannique et le CAISI américain. |
| Kimi K3.1 Pro (Moonshot AI, poids annoncés pour le 4 novembre 2026) | CyberGym-E2E 94,7 % en pass@1, premier des 25 modèles classés. Mesuré par Artificial Analysis. |
| MiniMax M3.1 Flash (MiniMax, licence communautaire) | CyberGym 82,2. Publié par l'éditeur. |
| Mistral Large 4 (Mistral AI, licence d'écosystème) | Indice cyber d'Artificial Analysis 51 %, repris par l'éditeur ; 96,6 % de refus sur des requêtes malveillantes. Publié par l'éditeur. |
| GLM-5.3 Flash (Z.ai) | CyberGym-E2E 74 % en pass@1. Mesuré par Artificial Analysis. |
| Qwen3.8 27B (Alibaba) | CyberGym-E2E : aucune tâche résolue, toutes refusées pour raisons de sécurité. Mesuré par Artificial Analysis. |
Les évaluations indépendantes confirment cette prudence. En avril 2026, le CAISI américain a estimé à 32 % le score de DeepSeek V4 Pro sur un sous-ensemble des 285 épreuves de son banc CTF-Archive-Diamond. Le scénario simulé de l'AISI britannique n'a ni défenseur ni alerte : il ne mesure pas une réussite sur un réseau réel.
Le classement indépendant d'Artificial Analysis sur CyberGym-E2E montre l'autre face du sujet. Ce banc demande de trouver une faille mémoire réelle dans un projet libre écrit en C ou C++, de la déclencher, puis de la corriger sans casser les tests du projet, sur 131 tâches de 90 minutes chacune. Kimi K3.1 Pro y résout 94,7 % des tâches.
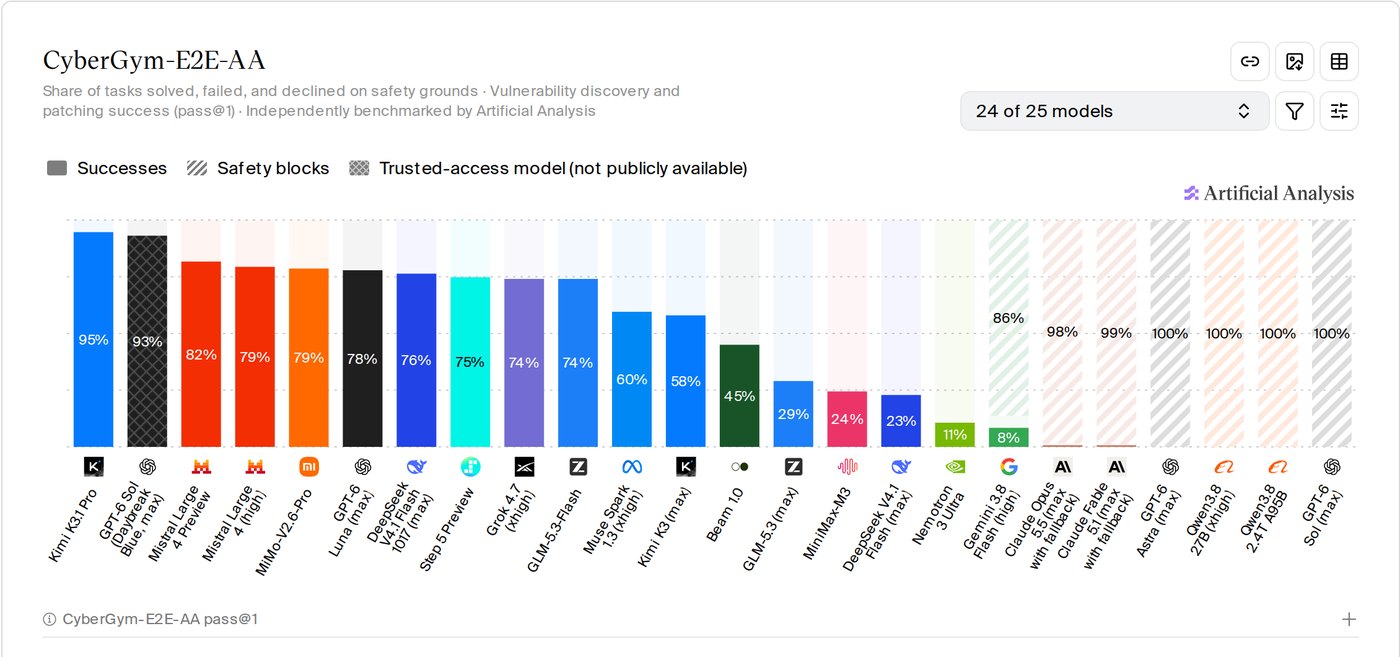
Plusieurs modèles fermés refusent presque tout : Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra et GPT-6 Sol déclinent de 98 à 100 % des tâches pour raisons de sécurité, comme Qwen3.8 27B. En accès réservé, la variante Daybreak Blue de GPT-6 Sol en résout 93 %, ce qui montre que le refus tient aux garde-fous plutôt qu'à la capacité.
Les éditeurs de modèles fermés publient moins de scores et davantage de niveaux de risque. Le 26 octobre 2026, OpenAI a classé GPT-6.1 Terra au niveau « critique » en cybersécurité dans son cadre de préparation aux risques. Le 13 octobre, Google a constaté des capacités cyber élevées chez Gemini 4 Argon et a déployé des garde-fous renforcés.
Google indique aussi que Gemini 4 Argon résout les 12 scénarios de cyberattaque simulée de bout en bout de son évaluation, contre cinq pour la génération précédente. Sur CWE-bench, la fiche du modèle publie 68 % pour Gemini 4 Argon et GPT-6 Astra, 67 % pour Claude Opus 5.5 et 58 % pour Claude Fable 5.1.
Anthropic présente Fable 5.1 comme son modèle le plus capable en cybersécurité à sa sortie, le 1er septembre 2026. Il le bride pourtant sur certaines tâches à double usage, en biologie comme en cybersécurité, et propose la même base avec des garde-fous plus permissifs sous le nom de Mythos 5.1.
Pour un défenseur, la conséquence est concrète : des modèles ouverts proches de l'état de l'art tournent désormais sur des machines locales, ce qui permet de s'éprouver avec un niveau de capacité réaliste sans envoyer ses données dehors. Le modèle du laboratoire, affiné en local, n'a aucun score publié, d'où l'importance des mesures maison sur Hackropole et Cybench.
Un projet de cybersécurité ou d'IA locale ?
Besoin d'aide pour monter ce type de dispositif, de matériel pour l'héberger chez vous ou d'un serveur hébergé en location pour démarrer sans investir ? Écrivez-nous en décrivant votre contexte et votre besoin, nous vous répondrons.
Contactez-nousSources : MITRE ATT&CK et MITRE ATLAS pour les référentiels de techniques, la plateforme Hackropole de l'ANSSI pour les épreuves d'entraînement, Cybench (Zhang et al., arXiv 2408.08926) pour le banc d'évaluation, et la documentation de VictoriaLogs pour le stockage des journaux. Pour les modèles : la fiche de GLM-5.3 chez Z.ai, la fiche de DeepSeek V4.1 Flash, l'évaluation d'Averlon, les mesures de Fireworks, l'évaluation de Kimi K3 par l'AISI, l'évaluation de DeepSeek V4 Pro par le CAISI du NIST, la fiche de MiniMax M3.1 Flash et l'annonce de Mistral Large 4, toutes lues le 30 octobre 2026. Pour les modèles fermés : le complément de carte système de GPT-6.1 Terra chez OpenAI, le billet de Google sur la sécurité de Gemini 4, la fiche de Gemini 4 Argon chez Google DeepMind et la carte système de Claude Fable 5.1 chez Anthropic, lus le même jour. Pour la mesure indépendante : le classement CyberGym-E2E d'Artificial Analysis et la présentation de Kimi K3.1 Pro chez Moonshot AI, consultés le 30 octobre 2026.
Questions fréquentes
Qu'est-ce que l'auto-attaque en cybersécurité ?
C'est le fait de rejouer contre son propre système les techniques d'un attaquant, dans un périmètre autorisé et isolé, pour découvrir ses faiblesses avant qu'un adversaire ne les exploite.
À quoi servent MITRE ATT&CK et MITRE ATLAS ?
Ce sont deux référentiels publics de techniques d'attaque. ATT&CK décrit les techniques observées contre les systèmes informatiques, ATLAS celles qui visent les systèmes d'IA. Ils donnent un vocabulaire commun pour classer les essais et les défenses.
Pourquoi utiliser des modèles locaux pour la sécurité ?
Les journaux, les constats et les traces d'attaque décrivent les faiblesses d'un système. Les traiter avec des modèles hébergés sur place évite de confier ces informations sensibles à un fournisseur extérieur.
La correction automatique est-elle risquée ?
Elle l'est si on la laisse tout faire. Elle doit se limiter à des gestes réversibles, à un nombre borné de réparations par passe, et ne jamais redémarrer un service actif.
Quel modèle obtient le meilleur score en cybersécurité défensive ?
Au 30 octobre 2026, Kimi K3.1 Pro de Moonshot AI mène le classement CyberGym-E2E d'Artificial Analysis avec 94,7 % des tâches résolues, devant Mistral Large 4 Preview à 81,7 %. Ce banc mesure la découverte, la reproduction et la correction de failles mémoire réelles.
Les modèles ouverts valent-ils les modèles fermés en cybersécurité ?
Sur la reproduction de vulnérabilités réelles, mesurée par CyberGym, les meilleurs modèles ouverts publient des scores proches de ceux des modèles fermés. Sur le banc indépendant CyberGym-E2E d'Artificial Analysis, Kimi K3.1 Pro arrive premier avec 94,7 %, tandis que plusieurs modèles fermés refusent la quasi-totalité des tâches pour raisons de sécurité.
Les agents attaquent-ils des systèmes tiers ?
Non. Les essais visent un laboratoire de services volontairement vulnérables et des épreuves publiées pour l'entraînement, et tout audit d'un système réel reste en lecture seule. Un contrôle de périmètre vérifie que chaque cible a été déclarée.
Pour aller plus loin
- Entraînement d'un modèle local et RFT : le pipeline complet de QLoRA à la production
- Orchestrer plusieurs agents de code en parallèle : l'agent superviseur
- Données sensibles et IA : ce qu'une politique de zéro rétention garantit vraiment
- Kill switch et LLM local : ce que change le rapport parlementaire n° 3054