Données sensibles et IA : ce qu'une politique de zéro rétention garantit vraiment
« Nous ne conservons pas vos données » rassure, et ne recouvre pas le champ qu'on imagine. La clause porte sur la conservation, jamais sur la transmission, et laisse hors de son périmètre les journaux, la détection d'abus, le cache et les sauvegardes.
Mis à jour le 26 septembre 2026 : Passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots) ; annonces OpenAI (19 août 2026) et Anthropic (1er septembre 2026) sur la rétention ajoutées.
Ce que la clause dit, et ce qu'elle ne dit pas
« Nous ne conservons pas vos données » et « nous n'entraînons pas nos modèles sur vos données » sont deux promesses distinctes, souvent confondues, et aucune ne recouvre le champ que l'on croit. La première porte sur la conservation. Elle laisse intact le fait que la donnée a été transmise, déchiffrée en mémoire puis traitée sur une infrastructure que vous n'administrez pas.
Pour un secret professionnel ou un secret d'affaires, c'est précisément ce fait qui compte, et non ce qu'il advient de la donnée par la suite. La seconde porte sur le réentraînement, garantie réelle et utile mais étroite, puisqu'elle n'interdit ni la journalisation, ni la conservation temporaire au titre de la détection d'abus, ni l'accès d'un opérateur en cas d'incident.
Le contrat reste l'outil adapté pour encadrer un traitement, mais il devient insuffisant dès lors que l'obligation porte sur le fait même de ne pas communiquer l'information, distinction développée dans notre article sur la traduction juridique et l'IA.
Où la donnée se dépose-t-elle malgré la politique du fournisseur ?
Même chez un fournisseur de bonne foi qui applique sa politique à la lettre, une requête laisse des traces à des endroits qui ne relèvent pas de la promesse commerciale.
Les deux grands fournisseurs américains ont revu leur promesse à la rentrée 2026 : OpenAI présente le 19 août un « traitement privé de sécurité » qui analyse plusieurs interactions liées sans accès de son personnel au contenu, et Anthropic annonce le 1er septembre des garde-fous qui stockent l'activité dans le nuage du client, non dans le sien.
| Emplacement | Pourquoi il existe | Ce que la clause en dit |
|---|---|---|
| Journaux d'exploitation | Diagnostiquer les incidents, mesurer la charge | Rien, ou une durée distincte de la promesse principale |
| Détection d'abus | Obligation du fournisseur de surveiller les usages interdits | Exclusion explicite de la non-conservation, souvent en note |
| Cache de réponses | Réduire coût et latence sur les requêtes répétées | Rarement mentionné ; son cloisonnement encore moins |
| Sauvegardes | Continuité d'activité | Cycle de rotation propre, indépendant de la suppression |
Aucun de ces quatre points n'est un manquement du fournisseur : ce sont des composants normaux d'un service en production. Le problème est qu'ils sont invisibles depuis le contrat, et qu'ils échappent donc à l'analyse d'impact qui s'appuie sur ce contrat.
Le cas de la suppression mérite un examen distinct, tant il illustre l'écart entre la clause et le système. Une demande d'effacement traitée immédiatement dans la base primaire reste sans effet sur les sauvegardes tant que leur cycle de rotation n'a pas expiré. C'est admis et documenté, mais rarement anticipé par l'organisation qui a demandé la suppression.
Le cas particulier des données sensibles
Pour les catégories particulières de données, santé, opinions, appartenance syndicale, données biométriques, le raisonnement change de nature. Il ne s'agit plus d'optimiser un risque mais de justifier une exception, puisque leur traitement est interdit par principe et n'est possible que dans des cas limitativement énumérés. Cette inversion emporte trois conséquences sur l'architecture du système, qu'aucune clause contractuelle ne peut remplacer.
- La charge de la preuve est renversée. Il ne suffit pas que le risque paraisse faible ; il faut démontrer que le traitement relève d'une exception et que les mesures sont proportionnées. Une clause fournisseur ne démontre rien de votre côté.
- Le classifieur doit être local. Détecter qu'une requête contient une donnée de santé suppose de lire la requête. Faire évaluer par une API la question « cette donnée a-t-elle le droit de partir vers une API ? » revient à l'avoir déjà envoyée. Voir le moteur d'orchestration.
- La bascule doit être interdite. Sur un flux sensible, un repli automatique vers un modèle hébergé en cas de panne locale annule la mesure au moment précis où elle comptait. Une panne doit produire une erreur.
Les secteurs concernés ont en outre leurs propres régimes, qu'aucune clause contractuelle ne remplace. La santé relève de l'hébergement de données de santé. Le secteur public a des exigences propres. Le juridique est couvert par le secret professionnel.
Ce que le local garantit, et ce qu'il ne garantit pas
Exécuter le modèle dans votre propre infrastructure supprime la cause du problème plutôt que ses effets : il n'existe aucune rétention chez un tiers puisqu'il n'y a pas eu de transmission, et la promesse devient vérifiable parce qu'elle porte désormais sur des composants que vous administrez vous-même.
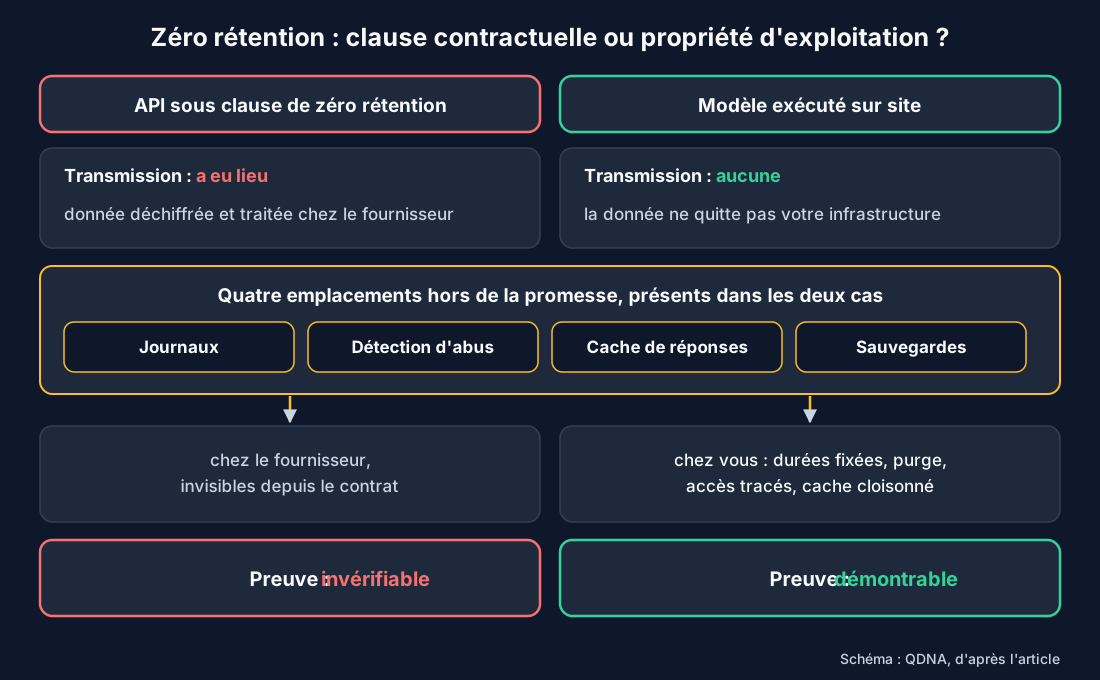
Il faut être précis sur ce que cela ne règle pas, sous peine de remplacer une confiance mal placée par une autre. Les quatre emplacements du tableau ci-dessus existent toujours, simplement chez vous plutôt que chez un prestataire.
Des journaux locaux conservant les requêtes en clair pendant deux ans, sur un serveur dont personne n'audite les accès, constituent un risque plus concret qu'une API correctement contractualisée. La différence n'est pas qu'il n'y a plus rien à faire : c'est que vous pouvez le faire, et le démontrer.
La zéro rétention devient donc, sur site, une propriété d'exploitation : durées fixées explicitement aux quatre endroits, purge implémentée et exécutée, accès aux journaux restreint et tracé, cache cloisonné par habilitation. C'est plus de travail qu'une signature au bas d'un contrat, et c'est la seule version qui se démontre.
Comment vérifier, plutôt que croire
Quatre questions suffisent à distinguer une politique réelle d'une formule commerciale, quel que soit le fournisseur : y compris votre propre équipe.
- Quelle est la durée de rétention des journaux techniques, et est-elle distincte de celle annoncée pour les données utilisateur ? Une réponse floue est déjà une réponse.
- Que devient une requête retenue par la détection d'abus : combien de temps est-elle conservée, et qui peut la lire ?
- La clé de cache inclut-elle l'identité et le périmètre d'habilitation de l'appelant ? Sinon, une réponse calculée pour un utilisateur autorisé peut être resservie à un autre.
- Quel est le délai réel d'effacement, sauvegardes comprises ? C'est le chiffre à inscrire dans le registre, pas celui de la base primaire.
Posées à un fournisseur, ces quatre questions révèlent la maturité de son offre ; posées à votre propre équipe, elles révèlent le plus souvent que le déploiement local ne possède pas encore les propriétés qu'on lui prête volontiers.
Cet article décrit des conséquences d'architecture, il ne constitue pas un conseil juridique. Sources : recommandations IA et RGPD de la CNIL, recommandations spécifiques au développement des systèmes d'IA, recommandations de sécurité de l'ANSSI. Consultées le 28 août 2026.
Ce qu'il faut retenir
La zéro rétention contractuelle et la zéro rétention architecturale portent le même nom et ne se démontrent pas de la même façon. La première engage un tiers sur un fait que vous ne pouvez pas observer ; la seconde décrit un système dont vous tenez les journaux, la purge et les accès.
Sur des données sensibles, où la charge de la preuve pèse sur vous, cette différence est décisive. Elle ne dispense pas du travail d'exploitation, elle le rend possible et vérifiable.
Questions fréquentes
Que garantit vraiment une politique de zéro rétention ?
Elle garantit ce qu'un fournisseur s'engage à ne pas conserver. Elle ne dit rien de la transmission, qui a bien eu lieu : la donnée a été envoyée, déchiffrée et traitée sur une infrastructure que vous n'administrez pas. Elle laisse aussi hors périmètre les journaux d'exploitation, la détection d'abus, le cache de réponses et les sauvegardes, qui ont chacun leur propre durée.
Zéro rétention et non-réentraînement, est-ce la même chose ?
Non, ce sont deux promesses distinctes souvent confondues. La première porte sur la conservation, la seconde sur l'usage des données pour améliorer le modèle. Le non-réentraînement est une garantie réelle mais étroite : il n'interdit ni la journalisation, ni la conservation temporaire pour la détection d'abus, ni l'accès d'un opérateur en cas d'incident.
Peut-on traiter des données de santé avec une API d'IA ?
Le raisonnement change de nature pour les catégories particulières de données : leur traitement est interdit par principe et n'est possible que dans des cas limitativement énumérés, ce qui renverse la charge de la preuve. Une clause fournisseur ne démontre rien de votre côté, et les secteurs concernés ont en outre leurs propres régimes, comme l'hébergement de données de santé.
Le déploiement sur site suffit-il à garantir zéro rétention ?
Non, il en donne la capacité. Les journaux, le cache et les sauvegardes existent toujours, simplement chez vous. Des journaux locaux gardant les requêtes en clair pendant deux ans, sur un serveur dont personne n'audite les accès, sont un risque plus concret qu'une API correctement contractualisée. Sur site, la zéro rétention est une propriété d'exploitation à tenir.
Comment vérifier la politique de rétention d'un fournisseur ?
Quatre questions suffisent : quelle durée pour les journaux techniques, et est-elle distincte de celle annoncée ; que devient une requête retenue par la détection d'abus, et qui peut la lire ; la clé de cache inclut-elle l'identité et l'habilitation de l'appelant ; quel est le délai réel d'effacement, sauvegardes comprises. Une réponse floue est déjà une réponse.