ASRock AI BOX-A395 + Qwen3.8-27B : 256K de contexte sur Strix Halo 128 GB
L'ASRock AI BOX-A395 (Ryzen AI Max+ 395, Radeon 8060S, 128 GB de LPDDR5X-8000 partagée) fait tourner Qwen3.8-27B multimodal en local, et voici les mesures de débit, le dimensionnement du cache KV, les fenêtres de contexte de 262k natives extensibles à 1 M, le comparatif des systèmes et les prix.
Mis à jour le 8 octobre 2026 : AI BOX-A395 relevé chez MITXPC à 4 299,95 $ HT, soit environ 3 771 € HT au taux BCE du 25 septembre 2026 ; DGX Spark porté à 7 000 € HT (8 400 € TTC), prix retenu en octobre 2026 après la hausse constatée, au lieu de 5 083 € HT ; l'AI BOX-A395 se place désormais environ 46 % en dessous.
Mis à jour le 26 septembre 2026 : conversion dollar-euro au taux BCE du 25 septembre 2026 (1 € = 1,1403 $, soit 3 507 € HT pour l'AI BOX-A395), prix du DGX Spark relevé chez LDLC.pro (5 083 € HT) au lieu du comparateur idealo ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots) ; mesure indépendante Sleeping Robots (15 août 2026, 9,6 puis 18,0 tok/s avec MTP) ajoutée au tableau.
Mis à jour le 2 septembre 2026 : cache KV recalculé sur les 16 couches d'attention complète de config.json (64 Kio par token, non 256), soit 30 % de la mémoire à 262k au lieu de 48 % ; profil KyaniteLabs relu (UD-Q4_K_XL, ROCm, 11 à 24 tok/s en trafic réel) ; encodeur vision de 0,9 Go (fichier mmproj) au lieu de 5 ; prix Framework, Minisforum et Mac Studio relevés le 2 septembre 2026, prix HP non publié ; fiche ASRock relue via LinuxGizmos.
Le contexte
Le Strix Halo (Ryzen AI Max+ 395) est un cas particulier du LLM local : un APU avec un iGPU Radeon 8060S (RDNA 3.5, 40 CU) et jusqu'à 128 GB de LPDDR5X unifiée entre CPU, GPU et NPU, la même mémoire servant de VRAM à l'iGPU via le mécanisme GTT.
ASRock Industrial a industrialisé cette puce dans l'AI BOX-A395, un boîtier compact d'IA de périphérie, que nous avons évalué sur Qwen3.8-27B, le multimodal vision-language publié par Alibaba/Qwen le 14 août 2026 sous licence Apache-2.0.
Quelles sont les spécifications de l'AI BOX-A395 ?
Sources : fiche ASRock Industrial (page rendue en JavaScript, relue le 2 septembre 2026 via LinuxGizmos), fiche AMD Ryzen AI Max+ 395 (40 CU, LPDDR5x-8000, 256 Go/s).
| Composant | Détail |
|---|---|
| APU | AMD Ryzen AI Max+ 395 (Strix Halo), 16 cœurs / 32 threads, Zen 5 + Zen 5c, jusqu'à 5.1 GHz |
| iGPU | Radeon 8060S, RDNA 3.5, 40 CU, gfx1151 |
| NPU | XDNA 2, ~50 TOPS INT8 |
| Mémoire | 128 GB LPDDR5X-8000 unifiée CPU/GPU/NPU (version 128 GB) |
| Stockage | 2 × M.2 2242/2280 NVMe PCIe Gen4 x4, RAID 0/1 |
| Réseau | 1 × 10 GbE (Marvell AQC113) + 1 × 2,5 GbE, Wi-Fi 7, Bluetooth 5.4 |
| Ports USB | 2 × USB4, 1 × USB-C 3.2 Gen2, 2 × USB-A 3.2 Gen2, 2 × USB-A 2.0 |
| Alimentation | Bloc 400 W ; APU 120 W TDP, 140 W soutenus, 160 W en pointe |
| OS supportés | Windows 11, Linux (Ubuntu 24.04 LTS, Fedora 41+) |
Qwen3.8-27B : multimodal Apache-2.0
Qwen3.8-27B est publié le 14 août 2026 par Alibaba/Qwen, sous licence Apache-2.0. C'est un modèle multimodal vision-language (image + vidéo + texte), basé sur une architecture hybride Gated DeltaNet (linear attention) + Gated Attention.
| Paramètre | Valeur (config.json) |
|---|---|
| Paramètres totaux | 27 B (dense) |
| Hidden dimension | 5120 |
| Couches | 64 |
| Têtes attention (Q) | 24 |
| Têtes KV (GQA) | 4 |
| Head dim attention | 256 |
| Head dim linear (DeltaNet) | 128 (V:48 têtes, QK:16 têtes) |
| FFN intermediate | 17 408 |
| Vocab size | 248 320 |
| Context natif | 262 144 tokens (extensible à 1 000 000 par YaRN, facteur 4, selon la fiche Qwen ; le MTP sert au décodage spéculatif, pas au contexte) |
| Layout | 16 × (3 × (DeltaNet → FFN) → 1 × (Attention → FFN)) |
| Multi-Token Prediction (MTP) | Oui, entraîné multi-étapes |
Source : huggingface.co/Qwen/Qwen3.8-27B : config.json verbatim.
Prérequis ROCm / Vulkan
Sur Strix Halo, deux approches coexistent pour llama.cpp, et le choix entre Vulkan et ROCm conditionne à la fois la simplicité d'installation et le moteur de service que vous pourrez utiliser :
- Vulkan (recommandé en 2026) : support natif gfx1151, pas de HSA_OVERRIDE_GFX_VERSION, performances généralement supérieures à HIP/ROCm. Ollama-vulkan, LM Studio, llama.cpp Vulkan se partagent le même backend.
- ROCm / HIP : nécessaire pour vLLM en batch serving. ROCm 7.13 officialise RDNA 3.5 APU. Toujours utiliser
HSA_OVERRIDE_GFX_VERSION=11.5.1sauf si ROCm 7.14+ détecte gfx1151 nativement.
Sur Fedora 41+ ou Ubuntu 24.04 LTS avec un noyau 6.13 ou plus récent, la commande rocminfo | grep gfx1151 doit retourner le périphérique. Sur Windows 11, vLLM n'est pas disponible, mais Vulkan fonctionne sans réglage préalable via LM Studio ou Ollama-vulkan.
Sources : ROCm 7.13 Expanding Hardware, llama.cpp Strix Halo build, NixOS Discourse.
Benchmarks mesurés
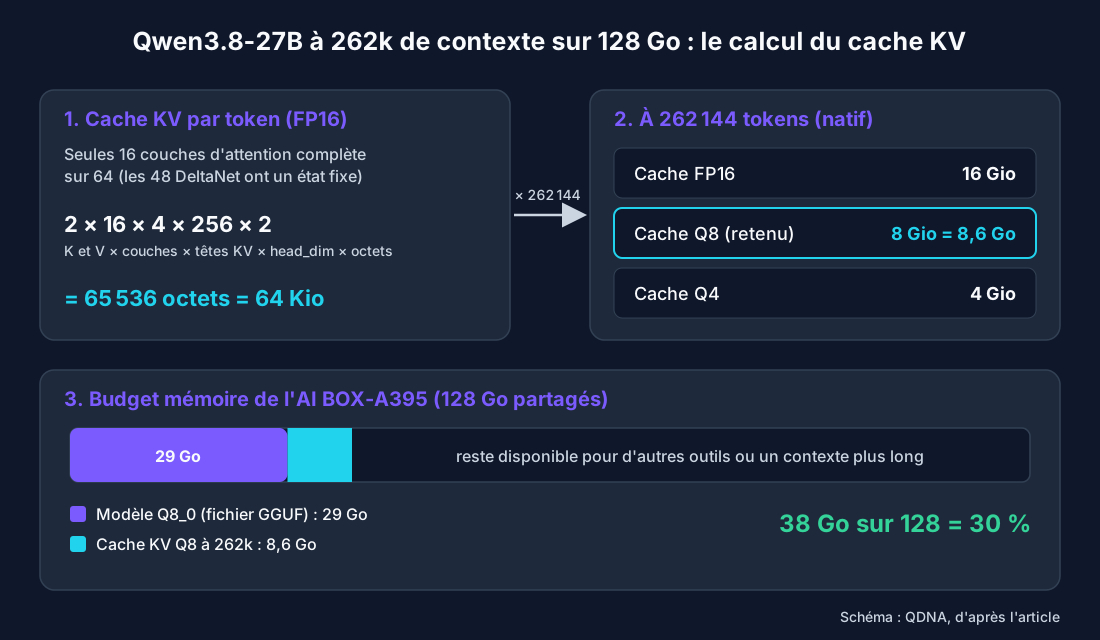
96k n'est pas le plafond, c'est le point où le profil de service publié a été mesuré. Le tableau du cache KV montre que le contexte natif de 262 144 tokens tient à 30 % de la mémoire (modèle Q8_0 29 Go + cache KV Q8 8 Gio, soit 8,6 Go, à 262k = 38 Go sur 128).
Les débits ci-dessous valent donc pour 96k ; à 256K, attendez-vous à une baisse proportionnelle au volume de cache relu, sans que la mémoire devienne le facteur limitant. Trois sources communautaires publient des benchmarks mesurés sur Qwen3.8-27B sur Strix Halo 128 GB :
| Source | Configuration | Throughput |
|---|---|---|
| kyuz0 (r/LocalLLaMA, Q8/Q4 30k contexte, llama.cpp ; relevé communautaire que nous n'avons pas pu relire le 2 septembre 2026, page inaccessible) | Qwen3.8-27B Q8 / Q4_K_M | ~208 tokens/s annoncés (génération, 30k ctx) |
| KyaniteLabs (profil de service publié, MTP n12 + spéculation ngram, relu le 2 septembre 2026) | Qwen3.8-27B UD-Q4_K_XL, llama.cpp ROCm/HIP, cache KV q4_0, contexte 262 144 | 59,7 tok/s à froid ; 148 à 163 tok/s à chaud sur relances identiques (artefact ngram) ; 11 à 24 tok/s en trafic réel (prose), 30 à 40 tok/s (code) |
| Sleeping Robots (billet du 15 août 2026, 1 passe de chauffe puis 3 mesures, 256 tokens générés, relu le 26 septembre 2026) | Qwen3.8-27B Q6_K (22 Go), llama.cpp Vulkan RADV, Strix Halo 128 Go | 9,6 tok/s sans MTP ; 18,0 tok/s avec MTP (2 jetons de brouillon), 15,2 tok/s avec 5 ; préremplissage 24 à 26 tok/s |
Le Q4 est plus rapide que le Q8 en tokens par seconde, le Q8 restant le format le plus proche des poids BF16. KyaniteLabs précise que ses valeurs à chaud viennent de relances identiques et que le trafic conversationnel réel retombe à 11 à 24 tok/s : c'est ce dernier chiffre qu'il faut retenir pour dimensionner.
Sources : kyuz0 r/LocalLLaMA benchmark, KyaniteLabs/qwen38-27b-strix-halo.
KV cache et fenêtres de contexte
Le KV cache de Qwen3.8-27B ne concerne que les 16 couches d'attention complète sur 64 (full_attention_interval = 4 dans config.json), les 48 couches DeltaNet gardant un état de taille fixe ; chacune a 4 têtes KV (GQA, 256 head_dim).
Par token, en FP16 : 2 × 16 × 4 × 256 × 2 = 65 536 octets (64 KiB/token). La version du 20 août comptait les 64 couches et surestimait le cache d'un facteur quatre, ce qui explique l'écart avec les tableaux publiés alors.
| Contexte | FP16 | Q8 | Q4 |
|---|---|---|---|
| 32 768 (32k) | 2,0 GiB | 1,0 GiB | 0,5 GiB |
| 65 536 (64k) | 4,0 GiB | 2,0 GiB | 1,0 GiB |
| 131 072 (128k) | 8,0 GiB | 4,0 GiB | 2,0 GiB |
| 262 144 (262k natif) | 16,0 GiB | 8,0 GiB | 4,0 GiB |
Avec 128 GB partagés : modèle Q8_0 (29,0 Go, fichier Qwen3.8-27B-Q8_0.gguf du dépôt unsloth relu le 2 septembre 2026) + KV Q8 (8 GiB, soit 8,6 Go, à 262k) = 38 Go sur 128, soit 30 % d'utilisation. Largement de quoi faire tourner en parallèle d'autres outils, ou de réserver la mémoire au KV cache pour des fenêtres plus longues.
Sources : config.json Qwen3.8-27B, kyuz0 amd-strix-halo-toolboxes.
Windows vs Linux
Pour Qwen3.8-27B multimodal, Vulkan est aujourd'hui le chemin de moindre friction, et la matrice suivante résume les options disponibles :
| OS | Backend | vLLM | Usage recommandé |
|---|---|---|---|
| Windows 11 | Vulkan (LM Studio, Ollama-vulkan, llama.cpp) | ❌ | Développement interactif, multimodal |
| Linux (Fedora 41+, Ubuntu 24.04 HWE) | Vulkan ou ROCm | ✅ ROCm | Serving batch, multimodal, multimodal agentique |
Pour une station de travail AI BOX-A395, Linux Fedora 41+ avec un noyau 6.14 ou plus récent est la cible privilégiée, avec vLLM, llama.cpp Vulkan, ROCm-SMI pour la supervision et l'accès BIOS à l'allocation de l'iGPU, tandis que Windows 11 reste valide pour un usage interactif via LM Studio, sans vLLM.
Source : KyaniteLabs/qwen38-27b-strix-halo.
Comparatif prix
L'AI BOX-A395 128 GB est listé à 4 299,95 $ HT chez MITXPC (intégrateur américain, relevé du 8 octobre 2026, prix sur demande « Contact Sales »), contre 3 999 $ en août 2026, soit environ 3 771 € HT au taux BCE du 25 septembre 2026 (1 € = 1,1403 $), avant la marge du canal de distribution européen (Avnet, Arrow, MITXPC EU).
La NVIDIA DGX Spark (édition PNY) est à 7 000 € HT, prix retenu en octobre 2026 après la hausse constatée (relevé LDLC.pro du 26 septembre 2026 : 5 083 € HT), soit 8 400 € TTC, ce qui place l'ASRock environ 46 % en dessous, à capacité de mémoire unifiée égale et pour un usage comparable.
| Machine | RAM unifiée | Prix indicatif 2026 | Usage |
|---|---|---|---|
| ASRock AI BOX-A395 | 128 GB LPDDR5X partagée | ~3 771 € HT (4 299,95 $) | Edge AI compact, multimodal local |
| Nvidia DGX Spark | 128 GB unifiée | 7 000 € HT (8 400 € TTC, prix retenu en octobre 2026) | CUDA, vLLM natif |
| Framework Desktop (DIY, Ryzen AI Max+ 395) | 128 GB | 3 889 € TTC, soit 3 241 € HT (frame.work, 2 septembre 2026) | DIY modulaire |
| HP Z2 Mini G1a (Ryzen AI Max PRO) | 128 GB | prix non publié (configurateur HP sans offre affichée le 2 septembre 2026) | Workstation ECC |
| Minisforum MS-S1 MAX (128 GB + 2 To) | 128 GB | 3 999 € TTC, soit 3 333 € HT (boutique européenne Minisforum, 2 septembre 2026, prix barré 4 999 €) | Mini-ITX alternative |
| Mac Studio M5 Ultra | 96 GB de base, 512 GB annoncés pour fin octobre 2026 | à partir de 6 599 € TTC, soit 5 499 € HT (apple.com/fr, 2 septembre 2026) | 1,2 To/s, plus rapide en MLX pur |
Pour Qwen3.8-27B multimodal, l'AI BOX-A395 se place environ 46 % sous le DGX Spark au prix retenu en octobre 2026, 3 771 contre 7 000 € HT, et les avantages sont inverses, puisque le DGX Spark offre CUDA et vLLM natif tandis que l'AI BOX-A395 a ROCm en cours d'officialisation et Vulkan dès aujourd'hui.
Le Mac Studio M5 Ultra, à partir de 6 599 € TTC soit environ 5 499 € HT, coûte sensiblement plus cher, mais il monte à 512 Go de mémoire unifiée servie à 1,2 To/s, pour une compatibilité vision moins bonne.
Sources : MITXPC (4 299,95 $ HT, 8 octobre 2026), LDLC.pro, PNY DGX Spark (26 septembre 2026), Framework Desktop (configurateur, 2 septembre 2026), Minisforum MS-S1 MAX (boutique EU, 2 septembre 2026), Apple, Mac Studio M5 Ultra (2 septembre 2026), HP Z2 Mini G1a, LinuxGizmos coverage. Conversions HT au taux de TVA de 20 %.
Quelles sont les limites de cet article ?
Les débits à 262k contexte, limite native de Qwen3.8-27B, et à 1 M de tokens, extension YaRN, restent à mesurer sur l'AI BOX-A395. La communauté publiant régulièrement sur r/StrixHalo et r/LocalLLaMA, nous mettrons cet article à jour au fil des benchmarks plus poussés d'ETA Prime et Phoronix.
L'AI BOX-A395 est commercialisé par le canal industriel entre professionnels, si bien que le prix catalogue n'est pas public et qu'un devis reste nécessaire, les estimations de marché ci-dessus n'étant fournies qu'à titre indicatif.
Sources officielles
- ASRock Industrial : AI BOX-A395 (fiche produit)
- Qwen/Qwen3.8-27B : Hugging Face (model card)
- unsloth/Qwen3.8-27B-GGUF (quants)
- AMD Ryzen AI Max+ 395
- AMD ROCm 7.13 : Expanding Hardware and Reach
- ROCm system-optimization RDNA 3.5
- llama.cpp : Strix Halo gfx1151 build
- KyaniteLabs/qwen38-27b-strix-halo : tuned serving profile
- Phoronix : ROCm 7.9 Strix Halo early tests
- r/LocalLLaMA : Qwen3.5/3.8 benchmarks Strix Halo
- kyuz0 amd-strix-halo-toolboxes dashboard
Questions fréquentes
L'ASRock AI BOX-A395 est-il le bon choix pour Qwen3.8-27B ?
Qwen3.8-27B ou Qwen3.5-27B-Instruct ?
ROCm ou Vulkan pour llama.cpp ?
Quelle quantization choisir ?
Combien coûte l'AI BOX-A395 ?
L'ASRock AI BOX-A395 est-il le bon choix pour faire tourner Qwen3.8-27B en local ?
Oui, sous trois conditions. Premièrement, Qwen3.8-27B est multimodal (vision + texte), pas un LLM texte seul : Qwen3.5-27B-Instruct reste le choix pour du texte pur. Deuxièmement, les 128 GB de LPDDR5X-8000 partagée permettent de charger le modèle en Q8 (~30 GB) + un KV cache confortable pour 96k de contexte (3 Gio en Q8 KV, 16 couches d'attention complète). Troisièmement, le backend Vulkan de llama.cpp est aujourd'hui plus performant et plus stable que ROCm/HIP sur gfx1151 : commencer par Vulkan, basculer en ROCm si un workload spécifique le demande.
Pourquoi Qwen3.8-27B plutôt qu'un autre modèle 27B ?
Qwen3.8-27B est publié par Alibaba/Qwen le 14 août 2026 sous licence Apache-2.0. C'est un modèle multimodal avec un mécanisme hybride Gated DeltaNet (linear attention) + Gated Attention, contexte natif de 262 144 tokens extensible à 1 000 000 par YaRN selon la fiche Qwen. Pour le VL local, il combine une compréhension image/vidéo et une capacité de raisonnement agentique qui n'existent pas dans Qwen3.5-27B texte pur. Pour du texte pur uniquement, Qwen3.5-27B-Instruct est plus rapide et plus léger.
Combien de tokens par seconde peut-on espérer sur l'AI BOX-A395 ?
Dépend de la quantization et du contexte. Selon kyuz0 (r/LocalLLaMA, Qwen3.5/Qwen3.8 30k contexte, llama.cpp), Qwen3.8-27B Q8 atteindrait environ 208 tokens par seconde en génération, relevé que nous n'avons pas pu relire le 2 septembre 2026. Selon KyaniteLabs (profil de service publié, UD-Q4_K_XL, llama.cpp ROCm, contexte 262 144), on observe 59,7 tokens/s à froid, 148 à 163 tokens/s à chaud sur relances identiques et 11 à 24 tokens/s en trafic conversationnel réel. À 262k contexte, il faut s'attendre à une baisse de throughput proportionnelle au cache relu, non mesurée sur cette machine.
Le backend ROCm est-il nécessaire ou Vulkan suffit ?
Sur Strix Halo (gfx1151), Vulkan est aujourd'hui le backend recommandé pour llama.cpp : pas de override HSA_OVERRIDE_GFX_VERSION, support natif, performances généralement supérieures à HIP/ROCm. ROCm 7.13 officialise RDNA 3.5 APU, mais pour llama.cpp ou ollama-vulkan, Vulkan reste le chemin de moindre friction. Pour vLLM en batch serving, ROCm est obligatoire et Linux requis (pas de vLLM Windows).
Quels prérequis pour installer Qwen3.8-27B sur l'AI BOX-A395 ?
Trois prérequis. OS : Fedora 41+ ou Ubuntu 24.04 LTS avec kernel 6.13+ (amdgpu upstream stable pour gfx1151), ou Windows 11 + Vulkan si on accepte de ne pas utiliser vLLM. Backend : llama.cpp compilé avec -DGGML_VULKAN=1 (recommandé), vLLM ROCm si serving batch. Modèle : télécharger les GGUFs Unsloth (Q4_K_M pour économiser la VRAM, Q8_0 pour la qualité) depuis huggingface.co/unsloth/Qwen3.8-27B-GGUF.
Combien coûte l'ASRock AI BOX-A395 ?
L'AI BOX-A395 128 GB est listé à 4 299,95 $ HT chez MITXPC (8 octobre 2026), soit environ 3 771 € HT au taux BCE du 25 septembre 2026 (1 € = 1,1403 $), avant marge du canal européen. La NVIDIA DGX Spark est retenue à 7 000 € HT (8 400 € TTC) depuis octobre 2026, ce qui place l'ASRock environ 46 % en dessous. La distribution est en canal industrial B2B (Avnet, Arrow, MITXPC EU) : pas de MSRP public, devis obligatoire.