Mac Studio M5 Ultra : 512 Go à 1,2 To/s, ce que ça change pour un LLM local
Apple a annoncé le Mac Studio M5 Ultra le 25 août 2026. La machine passe à 1,2 To/s de bande passante mémoire unifiée, garde un plafond de 512 Go et démarre à 6 599 € TTC en France. Voici ce que ces chiffres permettent réellement, et ce que personne ne peut encore affirmer, faute de mesure.
Mis à jour le 26 septembre 2026 : état des mesures relu le 26 septembre 2026, quatre jours après les premières livraisons : toujours aucune mesure indépendante reproductible, les chiffres en circulation extrapolent le M3 Ultra.
Mis à jour le 2 septembre 2026 : Qwen3.8-Flash-Next compte 180 milliards de paramètres publiés (125 de calcul, 51 d'embeddings n-gram, 4 de prédiction multi-token, 360 Go en BF16) et non 125 : il ne tient pas en 96 Go (111,6 Go mesurés en MLX 4 bits) et son plafond passe à 320 tokens/s ; les plafonds de GLM 5.3 Flash sont recalculés sur les octets par paramètre réellement mesurés des conversions citées ; le prix du châssis 36 cœurs, non lisible sur l'Apple Store par nos outils, est retiré ; l'écart entre Thunderbolt 5 et la mémoire est un facteur 80, non trois ordres de grandeur ; caractéristiques Apple relues (communiqués du 25 août 2026, fiche technique France).
Ce qu'Apple a annoncé, chiffres officiels
Apple décline deux puces aux positionnements distincts : le M5 Max s'adresse au poste de travail créatif, tandis que le M5 Ultra intéresse une plateforme d'inférence, puisqu'il demeure le seul à dépasser 128 Go de mémoire unifiée.
| M5 Max | M5 Ultra | |
|---|---|---|
| CPU (base) | 18 cœurs (6 super + 12 performance) | 30 cœurs (10 super + 20 performance) |
| CPU (configurable) | 18 cœurs | 36 cœurs |
| GPU | 32 cœurs, ou 40 en option | 64 cœurs, ou 80 en option |
| Neural Engine | 16 cœurs | 32 cœurs |
| Bande passante mémoire | 460 Go/s, ou 614 Go/s avec le GPU 40 cœurs | 1,2 To/s sur les deux variantes |
| Mémoire unifiée | 36 Go, configurable 48 / 64 / 128 Go | 96 Go, configurable 256 ou 512 Go |
| Stockage | 512 Go, jusqu'à 8 To | 1 To, jusqu'à 16 To |
| Prix France (à partir de) | 2 999 € TTC | 6 599 € TTC |
| Consommation maximale continue | 480 W | |
| Disponibilité | 22 septembre 2026 · option 512 Go fin octobre | |
Sources : caractéristiques techniques Apple France et communiqué Apple Newsroom du 25 août 2026. Prix relevés sur l'Apple Store France le 28 août 2026.
Deux détails de la grille de configuration comptent davantage que le reste, et l'un comme l'autre se laissent facilement manquer à la lecture d'une fiche produit.
Les options 256 et 512 Go ne sont pas disponibles sur la configuration d'entrée de gamme. Apple les réserve à la variante dotée du CPU 36 cœurs et du GPU 80 cœurs, si bien qu'une machine facturée 6 599 € ne peut pas être portée à 512 Go.
Il faut d'abord passer sur le châssis supérieur (CPU 36 cœurs, GPU 80 cœurs), dont le prix se lit sur l'Apple Store, avant même de payer la mémoire, ce qui change le budget réel de cette configuration.
La bande passante ne dépend pas de la quantité de mémoire commandée. Les 1,2 To/s sont en effet annoncés sur les deux variantes M5 Ultra, y compris celle à 96 Go. C'est l'inverse du M5 Max, dont la bande passante monte de 460 à 614 Go/s uniquement avec le GPU 40 cœurs.
Pour un usage LLM, cela veut dire qu'une M5 Ultra 96 Go délivre le même débit de génération qu'une 512 Go, sur les modèles qui tiennent dans 96 Go, la mémoire supplémentaire n'achetant que de la capacité.
1,2 To/s : le seul chiffre qui décide du débit de sortie
Servir un modèle de langage, ce sont deux régimes distincts, et ils ne dépendent pas du même composant. Nous l'avons détaillé dans prefill, decode et cache KV : quel matériel pour un LLM ; le M5 illustre cette séparation de façon presque caricaturale.
Apple l'écrit noir sur blanc dans sa propre publication de recherche : « générer le premier token est borné par le calcul », tandis que « générer les tokens suivants est borné par la bande passante mémoire, et non par la capacité de calcul ».
Les Neural Accelerators intégrés au GPU M5 accélèrent donc massivement la phase de prefill, et beaucoup moins la génération. Les mesures publiées par Apple, qui comparent un M5 à un M4, donnent l'ordre de grandeur de cette dissociation :
| Modèle | Format | Premier token (TTFT) | Génération | Mémoire |
|---|---|---|---|---|
| Qwen3-1.7B | BF16 | × 3,57 | × 1,27 | 4,40 Go |
| Qwen3-8B | BF16 | × 3,62 | × 1,24 | 17,46 Go |
| Qwen3-8B | 4 bits | × 3,97 | × 1,24 | 5,61 Go |
| Qwen3-14B | 4 bits | × 4,06 | × 1,19 | 9,16 Go |
| Qwen3-30B-A3B | 4 bits | × 3,52 | × 1,25 | 17,31 Go |
| gpt-oss-20b | MXFP4-Q4 | × 3,33 | × 1,24 | 12,08 Go |
Source : Apple Machine Learning Research, « Exploring LLMs with MLX and the Neural Accelerators in the M5 GPU ». Méthode : invite de 4 096 tokens, 128 tokens générés, MLX. Ces mesures comparent un M5 à un M4 sur MacBook Pro, pas un M5 Ultra à un M3 Ultra. Elles décrivent le comportement de l'architecture, pas la performance de la machine dont parle cet article.
Le rapport est spectaculaire dans une colonne et modeste dans l'autre : jusqu'à quatre fois plus vite sur le premier token, un cinquième à un quart de mieux sur la suite. L'écart s'explique entièrement par la bande passante : entre M4 et M5, elle passe de 120 à 153 Go/s, soit +28 %, exactement l'ordre de grandeur du gain observé en génération.
C'est précisément ce qui rend le chiffre annoncé pour le M5 Ultra intéressant, puisque passer de 819 Go/s à 1,2 To/s représente +47 % sur la grandeur qui borne la génération. Sur une machine dont la capacité mémoire ne bouge pas, c'est là que se trouve tout le progrès.
Le plafond de génération est-il calculé ou mesuré ?
Personne n'a encore publié de mesure reproductible sur M5 Ultra au 26 septembre 2026 : la machine est livrée depuis le 22 septembre et la configuration à 512 Go n'arrive qu'en fin octobre. Les débits en tokens par seconde qui circulent déjà relèvent donc de l'estimation, parfois présentée comme un relevé, raison pour laquelle nous ne les reproduisons pas.
Le plafond, en revanche, se calcule sans ambiguïté à partir des seules caractéristiques publiées, puisque générer un token suppose de lire les poids qui participent effectivement au calcul, soit la totalité des paramètres pour un modèle dense, soit les seuls experts activés pour une architecture à mélange d'experts.
Diviser la bande passante annoncée par ce volume fournit une borne supérieure que le matériel ne peut structurellement pas dépasser, et dont on atteint en pratique 50 à 80 % selon le runtime retenu, la longueur du contexte et la concurrence.
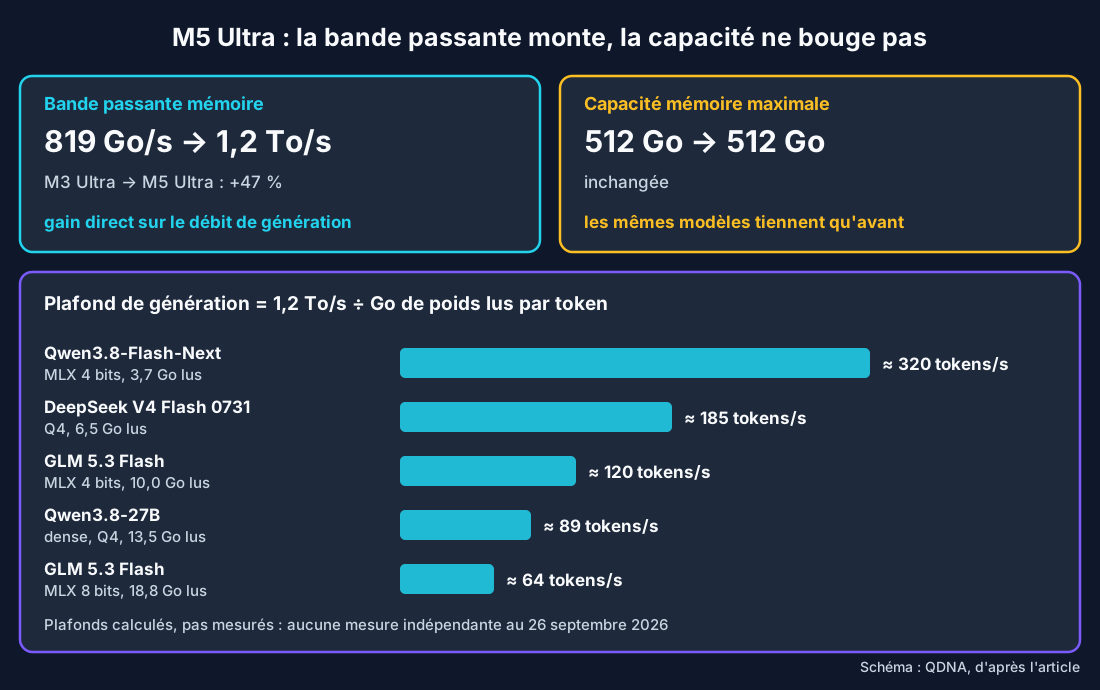
| Modèle | Poids lus par token | Format | Volume lu | Plafond à 1,2 To/s |
|---|---|---|---|---|
| Qwen3.8-Flash-Next | 6 B actifs sur 180 B publiés | MLX 4 bits (0,62 octet/paramètre mesuré) | 3,7 Go | ≈ 320 tokens/s |
| DeepSeek V4 Flash 0731 | 13 B actifs sur 284 B | Q4 | 6,5 Go | ≈ 185 tokens/s |
| GLM 5.3 Flash | 18 B actifs sur 320 B | MLX 4 bits (0,555 octet/paramètre mesuré) | 10,0 Go | ≈ 120 tokens/s |
| GLM 5.3 Flash | 18 B actifs sur 320 B | MLX 8 bits (1,044 octet/paramètre mesuré) | 18,8 Go | ≈ 64 tokens/s |
| Qwen3.8-27B | 27 B (dense) | Q4 | 13,5 Go | ≈ 89 tokens/s |
Calcul QDNA : bande passante annoncée ÷ volume de poids lus par token, le volume valant paramètres actifs × octets par paramètre, mesurés sur la conversion citée quand elle existe (0,62 pour Qwen3.8-Flash-Next en MLX 4 bits, 0,555 et 1,044 pour GLM 5.3 Flash en MLX 4 et 8 bits, relevés sur les safetensors le 2 septembre 2026).
Les valeurs nominales servent sinon (0,5 octet en Q4). Ce sont des plafonds arithmétiques, pas des mesures. Ils n'incluent ni la lecture du cache d'attention, ni les activations, ni le surcoût du runtime. Le tableau ne retient que des modèles qui logent effectivement sur la machine et dont le nombre de paramètres actifs est publié.
Il s'agit de Qwen3.8-Flash-Next (180 B publiés, 6 B actifs), DeepSeek V4 Flash 0731 (284 B, 13 B actifs), GLM 5.3 Flash (320 B, 18 B actifs) et Qwen3.8-27B (dense). Les très grands modèles à mélange d'experts comme Kimi K3 sont exclus : ils ne tiennent dans aucun format, donc aucun débit n'a de sens pour eux ici.
Sur la même arithmétique, un M3 Ultra à 819 Go/s plafonnerait à environ 221 tokens/s pour Qwen3.8-Flash-Next en MLX 4 bits, contre 320 pour le M5 Ultra ; 126 contre 185 pour DeepSeek V4 Flash 0731. Le rapport de 1,47 se retrouve ligne par ligne, puisqu'il ne dépend que de la bande passante.
Quels modèles logent selon la mémoire commandée ?
La capacité, en revanche, n'a pas bougé depuis le M3 Ultra et 512 Go demeure le plafond, si bien que la question « quel modèle tient » a donc la même réponse qu'avant, et elle dépend entièrement de l'option mémoire choisie.
| Modèle | Total / actifs | 96 Go | 256 Go | 512 Go |
|---|---|---|---|---|
| Qwen3.8-27B | 27 B, dense | FP16 | FP16 | FP16 |
| Qwen3.8-Flash-Next | 180 B publiés / 6 B | ne tient pas (111,6 Go mesurés en MLX 4 bits) | MLX 4 bits (111,6 Go mesurés) | BF16 (360 Go publiés) |
| DeepSeek V4 Flash 0731 | 284 B / 13 B | ne tient pas | Q4 (163 Go) | FP8 (327 Go) |
| GLM 5.3 Flash | 320 B / 18 B | ne tient pas | Q4 (184 Go) | FP8 (368 Go) |
Calcul QDNA : paramètres × octets par paramètre × 1,15 de marge d'exécution, hors cache d'attention. Même règle que la matrice de dimensionnement. Tailles et paramètres actifs relevés sur les fiches officielles, consultées le 28 août 2026 et relues le 2 septembre 2026.
Qwen3.8-Flash-Next compte 125 B de calcul dont 6 B actifs, plus 51 B d'embeddings n-gram et 4 B de prédiction multi-token, soit 180 B et 360 Go publiés en BF16, 262 144 tokens natifs extensibles à 1 000 000, la taille MLX 4 bits étant relevée sur Vontra/Qwen3.8-Flash-Next-MLX-4bit.
DeepSeek V4 Flash 0731 compte 284 B dont 13 B actifs, et GLM 5.3 Flash 320 B dont 18 B actifs, sous licence MIT, ce qui place les trois modèles dans la même famille de conceptions à mélange d'experts peu actives et économes en bande passante.
Le verdict s'est inversé avec la génération actuelle de modèles ouverts, pour une raison qui tient à leur architecture : les conceptions à mélange d'experts « Flash » activent peu de paramètres par token, ce qui les rend à la fois compactes une fois quantifiées et rapides.
La configuration d'entrée à 96 Go ne fait tourner que Qwen3.8-27B, Qwen3.8-Flash-Next demandant 111,6 Go en MLX 4 bits à cause de ses 51 milliards d'embeddings n-gram. Ce sont les 256 et 512 Go qui ouvrent Qwen3.8-Flash-Next, DeepSeek V4 Flash et GLM 5.3 Flash, et eux seuls justifient de passer sur la variante 36 cœurs.
Restent hors de portée les modèles à très grand nombre total de paramètres : Kimi K3 (2 800 B) demande environ 1 610 Go de poids en Q4. C'est la limite structurelle de la machine : 512 Go, c'est beaucoup pour un poste de travail et peu face à un DGX Station ou à un serveur RTX PRO 6000.
MLX : ce que 512 Go achètent réellement
Sur Apple Silicon, le choix du runtime d'inférence conditionne directement les performances observées. L'étude comparative de Rajesh et al. (arXiv 2511.05502), menée sur un Mac Studio M2 Ultra à 192 Go avec la famille Qwen-2.5 et des invites de quelques centaines à 100 000 tokens.
Elle conclut que MLX obtient le débit de génération soutenu le plus élevé, tandis que MLC-LLM donne un temps au premier token plus bas sur les invites moyennes, et que llama.cpp reste très efficace en usage mono-flux léger. Les auteurs posent aussi la limite honnêtement : ces piles « restent en retrait des systèmes GPU NVIDIA comme vLLM en performance absolue ».
Cette hiérarchie recoupe les mesures publiées par Apple : les Neural Accelerators accélèrent la phase de prefill tandis que la génération demeure bornée par la bande passante mémoire, et MLX reste le runtime qui exploite conjointement ces deux dimensions.
L'échelle de quantification, mesurée
C'est ici que la capacité mémoire cesse d'être une ligne de fiche technique pour devenir une décision de qualité. Les conversions MLX de GLM 5.3 Flash publiées par orcarouter sont accompagnées de mesures de perplexité et d'accord de token, contre la référence FP8 :
| Variante MLX | Taille sur disque | Perplexité vs FP8 | Accord du 1er token | Machine minimale |
|---|---|---|---|---|
| 6 bits | ≈ 296 Go | + 0,24 % | 97,76 % | 512 Go |
| 4 bits | ≈ 204 Go | + 2,96 % | 96,13 % | 256 Go |
| 3 bits | ≈ 184 Go | + 9,96 % | 92,06 % | 256 Go |
| 2 bits | ≈ 145 Go | + 56,9 % | 86,56 % | 256 Go |
| 2 bits « lite » | ≈ 102 Go | + 141 % | 77,19 % | 128 Go |
Source : orcarouter/GLM-5.3-Flash-MLX, perplexité mesurée contre la référence FP8 à 2,7797. La colonne « machine minimale » est notre lecture : taille sur disque plus une marge pour le cache d'attention et l'état d'exécution.
La lecture de ce tableau est aussi abrupte qu'instructive pour qui arbitre une commande. Entre 6 et 4 bits, la qualité ne perd qu'un peu moins de trois points de perplexité et l'accord de token se maintient au-dessus de 96 %, ce qui rend l'écart réel mais discutable.
Entre 4 et 2 bits en revanche, la perplexité augmente de 57 % et l'accord chute à 86,6 %. L'auteur de ces conversions le dit sans détour pour la variante la plus agressive : « la génération de code longue n'est pas fiable à cette précision », avec des boucles de répétition et du code manquant.
Autrement dit : 512 Go n'achètent pas la capacité de faire tourner un modèle de plus, ils achètent le droit de le faire tourner en 6 bits plutôt qu'en 4. En rédaction ou en questions-réponses, l'écart de précision ne se verra pas. En génération de code longue, il sépare un assistant utilisable d'un assistant qui invente.
GLM 5.3 Flash sur M5 Ultra, le cas concret
Croiser les trois données précédentes donne le tableau qu'un acheteur cherche réellement, puisque la variante MLX retenue détermine à la fois la machine nécessaire, le débit atteignable et la qualité conservée. GLM 5.3 Flash active 18 milliards de paramètres sur 320.
Son plafond de génération devient une fonction directe de la précision choisie : moins de bits par paramètre signifie moins d'octets relus à chaque token, donc davantage de tokens par seconde, au prix d'une dégradation que les mesures de perplexité chiffrent précisément.
| Variante MLX | Taille | Machine minimale | Plafond à 1,2 To/s | Perplexité | Accord du 1er token |
|---|---|---|---|---|---|
| 6 bits | ≈ 296 Go | 512 Go | ≈ 72 tokens/s | + 0,24 % | 97,76 % |
| 4 bits | ≈ 204 Go | 256 Go | ≈ 104 tokens/s | + 2,96 % | 96,13 % |
| 3 bits | ≈ 184 Go | 256 Go | ≈ 116 tokens/s | + 9,96 % | 92,06 % |
| 2 bits | ≈ 145 Go | 256 Go | ≈ 147 tokens/s | + 56,9 % | 86,56 % |
Tailles, perplexité et accord de token relevés sur orcarouter/GLM-5.3-Flash-MLX. Les plafonds sont un calcul QDNA, non une mesure : 1,2 To/s divisés par 18 milliards de paramètres actifs × (taille sur disque ÷ 320 milliards), soit 0,92 octet par paramètre en 6 bits (16,6 Go lus par token), puis 0,64 en 4 bits (11,5 Go).
La série continue : 0,58 en 3 bits (10,4 Go), puis 0,45 en 2 bits (8,2 Go), tailles relevées sur les safetensors du dépôt le 2 septembre 2026. La colonne « machine minimale » ajoute à la taille du modèle une marge pour le cache d'attention et l'état d'exécution.
La lecture pratique tient en une phrase : la configuration à 512 Go est la seule qui permette de servir GLM 5.3 Flash en 6 bits, c'est-à-dire à une qualité pratiquement indistinguable de la référence FP8, tandis que 256 Go imposent de descendre en 4 bits et d'accepter trois points de perplexité supplémentaires.
Le mouvement est contre-intuitif pour qui raisonne en débit, puisque descendre en précision accélère la génération : 4 bits plafonne à 104 tokens par seconde contre 72 en 6 bits. Autrement dit, les 512 Go n'achètent pas de la vitesse, ils achètent le droit de renoncer à en gagner au détriment de la qualité.
Reste la contrainte pratique, que la fiche produit ne mentionne pas : au moment de la livraison de la machine, servir ce modèle suppose d'installer mlx-vlm depuis sa branche principale, où l'architecture glm5_next n'est arrivée que le 26 août 2026, avec le correctif tiers qui rétablit la parité numérique avec la référence.
L'état réel du support
Un point que les fiches produit ne mentionnent pas et qui décide de la faisabilité à court terme : l'architecture glm5_next n'est arrivée dans la branche principale de mlx-vlm que le 26 août 2026, et aucune version publiée ne la porte encore.
La conversion 4 bits de PipeNetwork, qui pèse 177,6 Go contre 642,7 Go pour le bfloat16 amont, documente au passage deux bugs numériques et deux écarts d'epsilon trouvés dans cette branche, corrigés par un runtime rustiné qui atteint une parité de 1e-6 de bout en bout avec la référence.
Cette situation ne relève pas du détail d'implémentation, car elle signifie qu'au moment où la machine est livrée, exécuter le modèle qui l'intéresse le plus suppose d'installer mlx-vlm depuis la branche principale accompagnée d'un correctif tiers. L'opération demeure réalisable, mais elle ne correspond pas à ce que décrit une fiche commerciale.
Le cluster de quatre machines
Apple annonce qu'« un cluster de quatre Mac Studio permet d'obtenir des performances d'inférence d'IA jusqu'à 3 fois plus rapides », en s'appuyant sur Thunderbolt 5 et RDMA. La M5 Ultra dispose pour cela de six ports Thunderbolt 5 à 120 Gb/s, dont deux accessibles en façade du boîtier.
Cette annonce mérite d'être lue pour ce qu'elle énonce exactement, sans y projeter davantage : quatre machines pour un facteur trois représentent un rendement de 75 %, ce qui reste honnête pour du parallélisme de pipeline sur un lien externe, mais les 120 Gb/s annoncés correspondent à 15 Go/s, soit environ 1,2 % de la bande passante mémoire interne.
Le lien entre machines est donc près de deux ordres de grandeur plus lent que la mémoire locale (un facteur 80) : le découpage doit être fait par couches, avec très peu d'échanges, et le gain porte sur le débit agrégé, pas sur la latence d'une requête isolée.
L'UltraFusion qui relie les quatre dies d'un même M5 Ultra (deux puces M5 Max à double die, selon le communiqué Apple du 25 août 2026) dépasse 4,4 To/s. L'écart entre l'intérieur et l'extérieur du boîtier est ce qui rend le cluster utile pour servir plusieurs requêtes en parallèle, et peu utile pour accélérer une seule.
Face aux alternatives
Le Mac Studio n'a jamais gagné sur le débit brut, et le M5 Ultra ne change pas cela. Son terrain reste la mémoire par euro et par watt, dans un boîtier silencieux de 3,6 kg qui consomme 480 W au maximum.
- Contre un DGX Spark (128 Go, LPDDR5X unifiée) : le Mac Studio 512 Go joue dans une autre catégorie de capacité, mais le Spark reste dans l'écosystème CUDA, ce qui compte dès qu'on veut affiner un modèle.
- Contre un DGX Station (748 Go, HBM3e et LPDDR5X) : la Station loge des modèles que le Mac ne peut pas charger, et sert davantage de requêtes simultanées. Elle coûte aussi un ordre de grandeur de plus.
- Contre une API : la question n'est pas le débit mais le contrôle. Un Mac Studio ne transmet rien à personne, ce qui règle d'un coup la question de la localisation des données. Voir sur site ou API : comparer le coût réel.
Pour un poste d'inférence dédié à une équipe, installé dans un bureau plutôt que dans une salle serveur, la M5 Ultra représente aujourd'hui l'option la plus dense en mémoire qui ne réclame aucune infrastructure dédiée. Ce périmètre demeure étroit, mais il correspond à un besoin réel.
Ce qu'on ne sait pas encore
Trois inconnues restent ouvertes à la date de publication, et il vaut mieux les nommer explicitement que les combler par des estimations invérifiables.
- Le débit réel. Aucune mesure indépendante reproductible n'est publiée au 26 septembre 2026, quatre jours après les premières livraisons. Les plafonds ci-dessus disent ce que le matériel ne peut pas dépasser, pas ce qu'il atteint.
- Le prix des options 256 et 512 Go. Apple ne les publie pas sur sa page de caractéristiques, et les montants qui circulent dans la presse spécialisée se contredisent d'un facteur deux. Il faut un devis.
- Le comportement de MLX sur une puce à quatre dies. Les mesures publiées par Apple portent sur un M5 monolithique. Comment MLX répartit la charge sur les 80 cœurs GPU d'un M5 Ultra, et avec quel rendement, reste à observer.
Nous complèterons cet article par des relevés dès qu'une machine sera mesurable, selon la même méthode que la section mesures : un couple (modèle, format, matériel) par page, avec la procédure reproductible, et aucune valeur pour ce qui n'a pas été mesuré.
Ce qu'il faut retenir
Le M5 Ultra constitue une mise à jour de bande passante et non de capacité, ce qui détermine à qui il s'adresse. Les 47 % supplémentaires alimentent directement le débit de génération, qui en dépend linéairement, tandis que la question de savoir quel modèle tient en mémoire reçoit exactement la même réponse qu'avec un M3 Ultra.
Une organisation dont la contrainte était la capacité ne verra donc aucune amélioration, alors qu'une organisation limitée par la vitesse à capacité constante bénéficiera de la progression la plus nette qu'Apple ait proposée sur cette gamme.
Le piège commercial réside dans la configuration d'entrée, puisqu'à 6 599 € la machine ne dispose que de 96 Go et ne peut pas être portée ultérieurement à 512 Go. Le dimensionnement se décide donc avant la commande et non après la livraison. Ce dimensionnement se pose sur la matrice modèle × matériel.
Questions fréquentes
Quelle est la bande passante mémoire du Mac Studio M5 Ultra ?
1,2 To/s de bande passante mémoire unifiée, sur les deux variantes de la puce M5 Ultra. Apple annonce 50 % de plus qu'auparavant, la génération M3 Ultra plafonnant à environ 819 Go/s. Pour la génération de tokens, qui est bornée par la bande passante et non par le calcul, c'est le chiffre qui décide de la vitesse.
Combien de mémoire peut-on mettre dans un Mac Studio M5 Ultra ?
96 Go en base, 256 ou 512 Go en option, mais uniquement sur la variante CPU 36 cœurs / GPU 80 cœurs, pas sur la configuration d'entrée. L'option 512 Go n'est annoncée que pour fin octobre 2026.
Quels modèles ouverts tiennent sur un Mac Studio M5 Ultra 512 Go ?
Quatre modèles ouverts de génération courante couvrent l'essentiel des usages sur cette machine. En 512 Go : GLM 5.3 Flash (320 B, 18 B actifs) et DeepSeek V4 Flash 0731 (284 B, 13 B actifs) en FP8, Qwen3.8-Flash-Next (180 B publiés dont 6 actifs) jusqu'en BF16 (360 Go), et Qwen3.8-27B dense dans tous les formats. En 96 Go, un seul tient : Qwen3.8-27B, Qwen3.8-Flash-Next demandant 111,6 Go en MLX 4 bits. Les très grands modèles à mélange d'experts comme Kimi K3 (2 800 B) ne tiennent dans aucun format.
Le Mac Studio M5 Ultra remplace-t-il un serveur GPU NVIDIA ?
Pour un poste d'inférence à débit modéré et silencieux, il est crédible. Pour du service en production à forte concurrence, un serveur GPU garde l'avantage sur le débit agrégé et l'écosystème CUDA. L'affinage de modèles suppose encore du matériel NVIDIA.
Existe-t-il des mesures indépendantes de débit sur M5 Ultra ?
Non, aucune mesure reproductible au 26 septembre 2026 : la machine est livrée depuis le 22 septembre, la configuration 512 Go arrive fin octobre, et les débits qui circulent sont des extrapolations du M3 Ultra. Les tokens par seconde qui circulent sont des estimations calculées, pas des relevés.