GLM 5.3 deep on-premise : quel matériel, à quelle vitesse ?
Étude complète du modèle open weight de Zhipu AI annoncé le 14 août 2026 et dont les poids ont été publiés sur Hugging Face le 28 août 2026, et guide de dimensionnement matériel pour le faire tourner en local.
Mis à jour le 11 octobre 2026 : débits retirés. Ceux du DGX Spark ×2 (~28 tok/s) et de la DGX Station (~45 tok/s) portaient sur le FP8 de 756 Go, qui ne tient dans aucune de ces machines. Le tableau matériel indique le format qui tient, et les coûts par million de jetons repassent à « [À MESURER] ».
Mis à jour le 8 octobre 2026 : prix de référence du DGX Spark (7 000 € HT) et du DGX Station GB300 (150 000 € HT) relevés. Coûts par million de jetons recalculés avec la formule du site (0,94 € au lieu de 0,06 € sur DGX Spark ×2), seuil de rentabilité et affirmation sur la deuxième année retirés.
Mis à jour le 26 septembre 2026 : conversion NVFP4 officielle nvidia/GLM-5.3-NVFP4 publiée le 14 septembre 2026 (464 Go), indice Artificial Analysis v4.3.2 (GLM 5.3 à 45), vLLM 0.30.0 ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Mis à jour le 2 septembre 2026 : relecture de toutes les valeurs chiffrées contre les sources primaires. Dates de sortie corrigées (GLM 5 : février 2026 ; GLM 5.3 : annonce le 14 août, poids le 28 août 2026), cache KV recalculé depuis le config.json (44 Kio par token en FP8, non 64), mémoire du DGX Station (748 Go cohérents) et du serveur B200 ×8 (1 440 Go) alignées sur les fiches NVIDIA, taille NVFP4 relevée sur la conversion NVIDIA de GLM 5.2 (465 Go) au lieu d'un calcul, débits non mesurés remplacés par « [À MESURER] », affirmations sans source retirées (30 utilisateurs, 18 requêtes par seconde, p95, seuil de 4 000 mots).
Mis à jour le 1er septembre 2026 : tableau de scores et comparatif corrigés contre la fiche Hugging Face de GLM 5.3 et les dépôts des modèles comparés. La version du 18 août citait un modèle inexistant (« Qwen 3.8 Max 235 B »), des licences fausses (Llama 3.1 « CC-BY-NC »), et une colonne « Intelligence Index » sans source ; les poids publiés par Z.ai sont en FP8 (756 Go), pas en BF16.
Méthodologie
La méthodologie de cette étude croise trois sources, les annonces officielles de l'éditeur, les scores publiés par Z.ai sur son propre banc et les règles de dimensionnement de QDNA (empreinte des poids, cache KV), sans reprendre d'indice tiers en colonne :
- Les annonces officielles de Zhipu AI et THUDM, complétées par la fiche Hugging Face du modèle et la conversion NVFP4 de GLM 5.2 publiée par NVIDIA.
- Les scores publiés par Z.ai sur la fiche Hugging Face du modèle, mesurés par Z.ai sur son propre banc pour tous les modèles comparés (donc comparables entre eux, mais produits par un concurrent). Aucun indice tiers n'est repris en colonne : l'Intelligence Index d'Artificial Analysis (v4.1.1, consulté le 1er septembre 2026) ne couvre pas tous les modèles cités.
- Aucun débit sans mesure reproductible sur du matériel QDNA ou source tierce nommée : les configurations non mesurées restent sans valeur de débit.
Les débits non vérifiés sur notre matériel sont marqués « [À MESURER] » dans les tableaux, et les chiffres de benchmark sont repris aux sources citées, sans extrapolation, ce qui distingue partout ce qui est mesuré de ce qui est déclaré.
Les débits annoncés à la première publication (18 août 2026) ont été retirés le 11 octobre 2026, et les scores, le comparatif et toutes les valeurs de configuration ont été relus dans les dépôts Hugging Face et sur les fiches constructeurs le 2 septembre 2026.
Sources officielles
- GLM 5 : de l'agentique à l'ingénierie, Z.ai (février 2026 ; rapport technique arXiv 2602.15763)
- zai-org/GLM-5.3, fiche officielle et config.json
- Fiche de modèle GLM 5.3 Flash, Z.ai sur Hugging Face
- zai-org/GLM-5.2 (même modèle de base, licence MIT, poids BF16)
- README GLM-5 de Z.ai sur GitHub (744B-A40B, « GLM-5.3 uses the same base model as GLM-5.2 »)
- nvidia/GLM-5.3-NVFP4 (conversion officielle du 14 septembre 2026, 464 Go) et nvidia/GLM-5.2-NVFP4 (même base)
- Artificial Analysis, modèles à poids ouverts (Intelligence Index v4.3.2, consulté le 26 septembre 2026 : GLM 5.3 à 45, deuxième modèle ouvert derrière MiMo-V2.6-Pro à 46 ; non repris en colonne)
Architecture du modèle
GLM 5.3 conserve la famille d'architectures introduite par GLM 5 : mixture d'experts avec attention sparse. La structure publiée par THUDM fait état de :
- 744 milliards de paramètres totaux.
- ~40 milliards de paramètres actifs par token (256 experts routés, un expert partagé).
- 78 couches, têtes d'attention en sparse DSA (DeepSeek Sparse Attention), indexeur qui retient les 2 048 positions les mieux notées par token (index_topk du config.json) et attention latente MLA (kv_lora_rank 512, tête RoPE de 64).
- Tokenizer GLM-2 étendu, vocabulaire 154 880 entrées.
- Fenêtre de contexte 1 048 576 tokens, identique à GLM 5.2.
- Les dimensionnements de cette page retiennent un budget de cache KV de 200 000 tokens, qui n'est pas la fenêtre du modèle : servir le million complet demande beaucoup plus de mémoire.
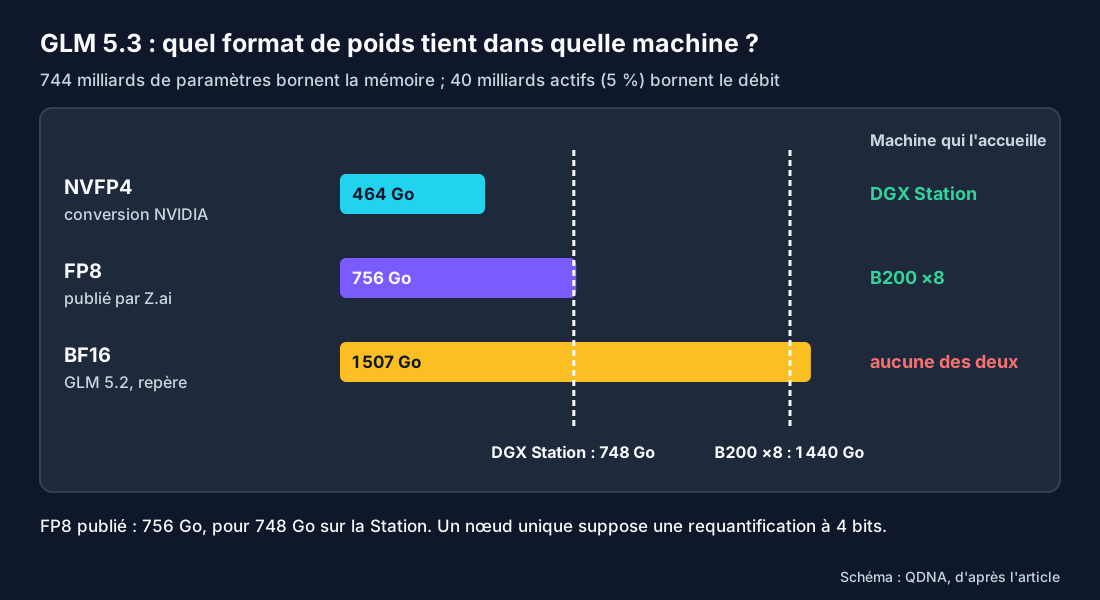
La mixture d'experts active environ 5 % des poids à chaque pas (40 sur 744 milliards), ce qui borne le débit ; c'est le total qui borne la mémoire : les 756 Go de poids FP8 publiés ne tiennent tels quels que sur un serveur à huit GPU (B200 ×8, 1 440 Go).
Un nœud unique de type DGX Station (748 Go) suppose une requantification à 4 bits (464 Go relevés le 26 septembre 2026 sur la conversion NVFP4 officielle de GLM 5.3). Le coût marginal en tokens est cependant plus élevé qu'un modèle dense équivalent, parce que la bande passante mémoire reste dominée par le poids total.
Benchmarks officiels
Le tableau ci-dessous reprend les scores publiés par Z.ai sur la fiche Hugging Face de GLM 5.3, relue le 1er septembre 2026. Z.ai a mesuré tous les modèles sur son propre banc (Claude Code 2.1.207 pour Terminal Bench 3.0, paramètres publiés en note de la fiche).
Les colonnes se comparent donc entre elles, mais ce sont les chiffres d'un concurrent des modèles comparés, pas ceux de leurs éditeurs ni d'un tiers neutre, ce qui interdit d'en tirer un classement définitif.
La fiche ne publie ni MMLU-Pro, ni GPQA, ni AIME, ni SWE-Bench Verified : nous ne les reprenons plus.
| Benchmark (banc Z.ai) | GLM 5.3 | GLM 5.2 | Kimi K3 | DeepSeek V4 Pro 0813 | Qwen3.8-Max | Claude Opus 4.8 |
|---|---|---|---|---|---|---|
| Terminal Bench 2.1 | 88,2 | 81,0 | 88,3 | 87,9 | 86,6 | 85,0 |
| Terminal Bench 3.0 | 28,3 | 4,6 | 17,4 | non publié | non publié | 21,1 |
| DeepSWE (v1.1) | 66,9 | 46,2 | 67,5 | 62,7 | 56,6 | 58,0 |
| NL2Repo | 58,0 | 48,9 | 58,0 | 61,1 | 55,9 | 69,7 |
| CyberGym | 84,5 | 77,2 | 80,0 | 83,3 | 78,5 | 78,1 |
| Toolathlon Verified | 73,0 | 59,9 | 76,5 | 74,1 | 72,5 | 76,2 |
| HLE avec outils | 62,5 | 54,7 | 59,8 | 60,0 | 56,2 | 57,9 |
Lecture rapide. Sur le banc de Z.ai, GLM 5.3 progresse nettement sur GLM 5.2 à poids égal (Terminal Bench 2.1 de 81,0 à 88,2, DeepSWE de 46,2 à 66,9, CyberGym de 77,2 à 84,5) : le gain vient du post-entraînement, le modèle de base étant le même.
Il se place au niveau de Kimi K3 sur les tâches agentiques et devant lui sur CyberGym et HLE avec outils, et il reste derrière Claude Opus 4.8 sur NL2Repo et Toolathlon.
Les scores des éditeurs eux-mêmes (DeepSeek, Moonshot, Alibaba, Anthropic) sont mesurés dans d'autres conditions et ne se comparent pas à ce tableau.
Quantifications disponibles
Z.ai publie GLM 5.3 en FP8 : le config.json du dépôt déclare une quantification fp8 (blocs 128 × 128) et les fichiers safetensors pèsent 756 Go, là où GLM 5.2 était publié en BF16 (1 507 Go). Les autres formats sont des calculs ou des conversions communautaires.
| Format | Poids modèle | Source | Matériel cible | Contexte pratique | Commentaire |
|---|---|---|---|---|---|
| FP8 (publié) | 756 Go | safetensors du dépôt zai-org/GLM-5.3 | H200 SXM ×8 (1 128 Go), B200 ×8 | 200 K | Format de référence et de production on-prem. |
| BF16 | 1 507 Go | dépôt zai-org/GLM-5.2 (même base, publié en BF16) | Cluster 8× H200 / GB300 NVL72 | 200 K | Non publié pour GLM 5.3 ; valeur de GLM 5.2 donnée à titre de repère. |
| NVFP4 | 464 Go | safetensors de nvidia/GLM-5.3-NVFP4, relevés le 26 septembre 2026 | B200, B300, GB300 NVL72, DGX Station | 200 K | Spécifique Blackwell ; conversion officielle nvidia/GLM-5.3-NVFP4 publiée le 14 septembre 2026 (50 fichiers safetensors, 464 Go), celle de GLM 5.2 (465 Go) reste disponible. |
Le DGX Spark et le DGX Station sont des Blackwell et exposent le FP4 (NVIDIA annonce 1 pétaFLOP FP4 avec parcimonie sur le GB10) : le choix entre le FP8 publié et une conversion NVFP4 se fait sur la mémoire disponible et sur la conversion que l'on accepte d'installer, pas sur une limite du matériel.
Matériel : quel GPU pour quelle cible ?
Le tableau ci-dessous croise cinq configurations matérielles que nous dimensionnons régulièrement chez QDNA, avec le format de GLM 5.3 qui tient en mémoire et l'état de la mesure de débit. « Contexte pratique » désigne la fenêtre de contexte maximale sans dégrader le débit single-user de plus de 10 %.
| Configuration | Mémoire unifiée | Quantification | Contexte pratique | tok/s single-user | tok/s charge (10 utilisateurs) | Commentaire |
|---|---|---|---|---|---|---|
| DGX Spark ×2 cluster RDMA | 256 Go | Aucune | sans objet | sans objet | sans objet | Ne tient pas : même la conversion NVFP4 (464 Go) dépasse les 256 Go du cluster. |
| DGX Spark mono | 128 Go | Aucune | sans objet | sans objet | sans objet | Ne tient pas : 128 Go pour 464 Go de poids au plus compact. |
| DGX Station GB300 | 748 Go (252 HBM3e + 496 LPDDR5X) | NVFP4 (464 Go) | [À MESURER] | [À MESURER] | [À MESURER] | Seule machine mono-nœud du tableau à loger le modèle. Le FP8 publié (756 Go) dépasse ses 748 Go. |
| Serveur H200 SXM ×1 | 141 Go | Aucune | sans objet | sans objet | sans objet | Ne tient pas (141 Go, fiche NVIDIA H200). Le FP8 demande un serveur H200 SXM ×8 (1 128 Go). |
| Serveur B200 SXM ×8 (NVFP4) | 1 440 Go (fiche NVIDIA DGX B200) | NVFP4 | 200 K | [À MESURER] | [À MESURER] | Configuration haute. 8 GPU en NVLink, contexte 200 K, multi-tenant. |
| Cluster GB300 NVL72 (NVFP4) | 20 To de HBM3e (fiche NVIDIA) | NVFP4 | 200 K | [À MESURER] | [À MESURER] | Référence pour les très fortes charges (centaines d'utilisateurs). Tarification sur devis. |
Les débits publiés jusqu'au 11 octobre 2026 pour le DGX Spark ×2 et la DGX Station ont été retirés : ils portaient sur le FP8 de 756 Go, qui ne tient dans aucune de ces machines. Faute de mesure reproductible ou de source tierce nommée, les cellules restent « [À MESURER] », comme l'explique la section mesures.
Coût d'exploitation
Le coût horaire suit la formule commune du site, qui divise le prix d'achat HT par 26 280 heures d'amortissement sur trois ans et ajoute la puissance en kW facturée 0,1624 € le kWh. Il vaut 5,97 € pour la DGX Station GB300 (150 000 €, 1 600 W), seule machine mono-nœud du tableau à loger le modèle.
Le coût par million de jetons divise ce coût horaire par le débit agrégé, multiplié par 3 600 secondes et par la charge, fixée à 30 % dans l'hypothèse médiane du site. Faute de débit mesuré, il reste « [À MESURER] » pour toutes les configurations du tableau.
Le seuil de rentabilité ne dépend pas du débit. Face à l'API DeepSeek V4 Flash (0,18 $/M, soit 0,16 € au taux BCE de 1,1403 $), une DGX Station à 4 356 € par mois ne s'équilibre qu'à 27,6 milliards de jetons mensuels, environ 10 600 par seconde. Le déploiement local se justifie donc par la souveraineté, pas par le prix du jeton.
| Configuration | Coût matériel (HT) | Coût par million de tokens générés, charge 30 % | Coût par million de tokens générés, charge 100 % | Coût API équivalent OpenRouter |
|---|---|---|---|---|
| DGX Spark ×2 | 14 000 € (2 × 7 000 € HT, prix retenu en octobre 2026 après la hausse constatée ; relevé LDLC.pro du 26 septembre 2026 : 5 083 € HT l'unité) | ne tient pas | ne tient pas | 0,18 $/M (DeepSeek V4 Flash) |
| DGX Station GB300 | 150 000 € (hypothèse commune du site retenue en octobre 2026 ; relevé pi3g du 14 septembre 2026 : 95 000 €) | [À MESURER] | [À MESURER] | 0,18 $/M |
| Serveur H200 SXM ×1 | 82 000 € | ne tient pas | ne tient pas | 0,18 $/M |
| Serveur B200 ×8 (NVFP4) | 620 000 € | [À MESURER] | [À MESURER] | 0,18 $/M |
| GB300 NVL72 | sur devis | [À MESURER] | [À MESURER] | 0,18 $/M |
Comparaison avec la concurrence open weight
Valeurs relues le 1er septembre 2026 dans le config.json, le README et la licence de chaque dépôt Hugging Face ; le détail figure dans notre comparatif des modèles open weight. Aucun indice tiers ni coût par token n'est repris : l'indice Artificial Analysis ne couvre pas tous ces modèles et les coûts dépendent de la machine, pas du modèle.
| Modèle | Paramètres totaux | Actifs / token | Contexte natif | Poids publiés | Licence | Commentaire |
|---|---|---|---|---|---|---|
| GLM 5.3 | 744 milliards | 40 milliards | 1 048 576 | 756 Go (FP8) | GLM-5.3 | Même base que GLM 5.2, post-entraînement renforcé ; tient sur DGX Station GB300 à 4 bits. |
| GLM 5.2 | 744 milliards | 40 milliards | 1 048 576 | 1 507 Go (BF16) | MIT | Modèle précédent, même base et même fenêtre, licence sans condition. |
| DeepSeek V4 Flash 0731 | 284 milliards | 13 milliards | 1 048 576 | 167 Go (FP4 + FP8) | MIT | Poids publiés qui tiennent tels quels sur DGX Station ; 13 milliards actifs seulement. |
| Kimi K3 | 2 800 milliards | 104 milliards | 1 048 576 | 1 561 Go (MXFP4) | Kimi K3 | Au niveau de GLM 5.3 sur le banc Z.ai ; 1 561 Go publiés, hors de portée d'une machine à un nœud. |
| Qwen3.8-2.4T-A95B | 2 400 milliards | 95 milliards | 262 144 | 4 892 Go (BF16) | Qwen3.8-Max | Modèle de base de Qwen3.8-Max, publié le 8 août 2026 ; multi-GPU obligatoire. |
| Qwen3.8-27B | 27 milliards (dense) | 27 milliards | 262 144 | 56 Go (BF16) | Apache 2.0 | Compact, DGX Spark seul ou RTX PRO 6000. |
| Llama 3.1 70B Instruct | 70 milliards (dense) | 70 milliards | 131 072 | 141 Go (BF16) | Llama 3.1 Community | Référence historique (2024) ; licence à conditions (mention « Built with Llama », seuil de 700 millions d'utilisateurs). |
GLM 5.3 devient la référence pour un usage frontal en auto-hébergement : au niveau de Kimi K3 sur le banc de Z.ai pour un poids publié deux fois moindre, un contexte natif d'un million de tokens dont le budget de 200 K retenu ici couvre la majorité des usages.
Sa licence GLM-5.3 n'a qu'une condition (revue de sécurité Z.ai pour un opérateur de modèle en service dépassant 10 milliards de dollars de chiffre d'affaires sur douze mois), qui ne concerne pas un déploiement d'entreprise. Kimi K3 reste au même niveau sur le papier mais ses 1 561 Go publiés dépassent toute machine à un nœud du catalogue.
Comparaison avec les modèles fermés
Sur le banc de Z.ai, GLM 5.3 dépasse Claude Opus 4.8 sur Terminal Bench 2.1 et 3.0, DeepSWE, CyberGym et HLE avec outils, et reste derrière sur NL2Repo et Toolathlon Verified (tableau ci-dessus).
Les éditeurs des modèles fermés ne publient pas de scores sur ce banc, et nous ne reprenons pas d'indice tiers ni de tarif d'API : ils se lisent sur la grille de chaque éditeur. L'avantage de GLM 5.3 reste le déploiement local sans dépendance à une API tierce.
| Modèle | Poids ouverts | Hébergeable en local |
|---|---|---|
| GLM 5.3 | Oui (licence GLM-5.3) | Oui (FP8 publié, NVFP4 par conversion) |
| Claude Opus 4.8 | Non | Non |
| GPT-5.6 | Non | Non |
Cas d'usage adaptés
Les cas d'usage adaptés à GLM 5.3 sont ceux où le banc de Z.ai le place au niveau des meilleurs modèles ouverts : agents de code, recherche augmentée à contexte long et génération augmentée par outils.
- Agents de code en production. Sur le banc de Z.ai, GLM 5.3 atteint 88,2 % à Terminal Bench 2.1 et 66,9 % à DeepSWE, au niveau de Kimi K3 (88,3 et 67,5) et devant Qwen3.8-Max (86,6 et 56,6).
- Recherche augmentée (RAG) à contexte long. 200 K tokens couvrent un dossier d'environ 500 pages A4 (hypothèse : 300 mots par page et 1,3 token par mot, soit 390 tokens par page ; 200 000 / 390 ≈ 510). Le nombre de requêtes par seconde d'une chaîne RAG dépend de l'index et du matériel : [À MESURER].
- Génération augmentée par outils. Terminal Bench 2.1 à 88,2 % (banc Z.ai) indique une bonne maîtrise du shell, Navigation API, JSON structuré. Compatible avec OpenCode, Hermes Agent, harness internes.
- Rédaction longue en français. La qualité française est légèrement en retrait de l'anglais mais le tokenizer GLM-2 étend la couverture multilingue ; aucun banc public ne chiffre cet écart.
Quand ne pas choisir GLM 5.3 ?
Il ne faut pas choisir GLM 5.3 quand le raisonnement mathématique pur domine, quand un seul DGX Spark est disponible, quand la latence prime sur la qualité ou quand le contexte dépasse régulièrement 200 K.
- Si la tâche principale est le raisonnement mathématique pur, les modèles propriétaires restent la référence ; leurs éditeurs ne publient pas de scores sur le banc de Z.ai, nous ne chiffrons donc pas l'écart.
- Si l'organisation est strictement limitée à un DGX Spark mono (128 Go), Qwen 3.8 27B dense en FP8 tient sur un seul nœud sans offload.
- Si la latence prime sur la qualité, un modèle à moins de paramètres actifs (GLM 5.3 Flash, 320 milliards dont 18 actifs ; Qwen3.8-Flash-Next, 125 milliards dont 6 actifs) sert plus vite à matériel égal, le débit étant borné par les paramètres actifs.
- Si le contexte d'entrée dépasse régulièrement 200 K, c'est le budget de cache KV, non la fenêtre du modèle, qui devient la contrainte : à machine égale, DeepSeek V4 Flash 0731 (167 Go publiés) laisse davantage de mémoire au cache qu'un GLM 5.3 requantifié (465 Go).
Quelle est la checklist pour la mise en production ?
La checklist de mise en production suit l'ordre des dépendances : récupérer les poids, choisir le runtime, calculer le cache KV, dimensionner le matériel, puis mesurer avant d'ouvrir le service.
- Récupérer les poids FP8 publiés par Z.ai sur Hugging Face (756 Go), miroir ModelScope, ou une conversion NVFP4.
- Choisir le runtime : vLLM (v0.30.0, dernière version publiée sur GitHub au 26 septembre 2026) pour la production, llama.cpp pour le debug, SGLang pour les charges agentiques à fort trafic.
- Calculer le KV cache selon la fenêtre cible. GLM 5.3 stocke par couche un latent MLA de 512 valeurs et une clé RoPE de 64 (config.json) : (512 + 64) × 78 couches = 44 928 octets, soit 44 Kio par token avec un cache en FP8 et 88 Kio en BF16, hors clés de l'indexeur DSA (128 octets par couche).
- Dimensionner le matériel via la fiche QDNA du GPU retenu (DGX Spark, DGX Station, H200, B200, B300, GB300 NVL72).
- Servir via OpenAI-compatible endpoint, brancher à LiteLLM, ajouter le routeur sémantique si plusieurs modèles cohabitent.
- Mesurer le débit en single-user puis en charge avec Locust ou k6, et fixer la cible de latence p95 à partir de cette mesure.
- Brancher le monitoring : latence inter-token, RTT NCCL (si cluster), saturation VRAM, taux de troncature KV.
Questions fréquentes
GLM 5.3 est-il open weight ?
Oui. Les poids sont publiés par Zhipu AI (THUDM) sur Hugging Face et ModelScope, sous la licence GLM-5.3. NVIDIA a publié la conversion officielle nvidia/GLM-5.3-NVFP4 le 14 septembre 2026 (464 Go), en plus de celle de GLM 5.2 (même modèle de base).
Sur quel matériel faire tourner GLM 5.3 en local ?
En mono-nœud, sur une DGX Station GB300 (748 Go) avec la conversion NVFP4 de 464 Go. Les poids FP8 publiés (756 Go) demandent un serveur à huit GPU, H200 SXM ×8 (1 128 Go) ou B200 SXM ×8 (1 440 Go). Un DGX Spark, même par deux (256 Go), ne suffit pas, et aucun débit n'est encore mesuré sur ces machines.
Quelle est la différence entre GLM 5.3 et GLM 5.2 ?
Même modèle de base (744 milliards de paramètres, 40 actifs, 78 couches, 256 experts routés, contexte de 1 048 576 tokens) : tout le gain vient du post-entraînement, selon Z.ai. Sur le banc de Z.ai, Terminal Bench 2.1 passe de 81,0 à 88,2, DeepSWE de 46,2 à 66,9 et CyberGym de 77,2 à 84,5. Les poids de GLM 5.3 sont publiés en FP8 (756 Go) sous la licence GLM-5.3, ceux de GLM 5.2 en BF16 (1 507 Go) sous MIT. À ne pas confondre avec GLM 5.3 Flash, un autre modèle de 320 milliards de paramètres dont 18 actifs.
GLM 5.3 est-il meilleur que Claude Opus ?
Sur le banc de Z.ai publié avec la fiche du modèle, GLM 5.3 dépasse Claude Opus 4.8 sur Terminal Bench 2.1 (88,2 contre 85,0), DeepSWE (66,9 contre 58,0) et CyberGym (84,5 contre 78,1), et reste derrière sur NL2Repo (58,0 contre 69,7) et Toolathlon Verified (73,0 contre 76,2). Ces chiffres sont mesurés par Z.ai, pas par Anthropic ni par un tiers neutre. Pour un usage à poids ouverts sans API tierce, GLM 5.3 est aujourd'hui l'option la plus solide en auto-hébergement à un nœud.