Modèles open weight pour déploiement local 2026 : comparatif complet
Le comparatif 2026 des modèles à poids ouverts pour un déploiement local sur DGX Spark, cluster 2× Spark et DGX Station GB300 : DeepSeek V4 Flash 0731 et V4 Pro, Kimi K3, GLM 5.3, Kimi K2.7 Code, MiniMax M3, Qwen3.8, Llama 3.1 70B, chaque valeur relue dans le dépôt Hugging Face du modèle.
Mis à jour le 8 octobre 2026 : prix de référence portés à 7 000 € HT pour le DGX Spark et à 150 000 € HT pour la DGX Station GB300 après la hausse constatée ; coûts sur trois ans et coût par million de tokens recalculés, les relevés LDLC.pro et pi3g restent cités.
Mis à jour le 26 septembre 2026 : GLM 5.3 (poids FP8 de 756 Go, licence GLM-5.3, conversion officielle NVFP4 de 464 Go depuis le 14 septembre) remplace GLM 5.2 dans les tableaux ; prix du DGX Spark relevé chez LDLC.pro (5 083 € HT), page pi3g du 14 septembre, révision DeepSeek V4 Pro 0813 signalée, Claude Opus 5.5 comme référence fermée ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Mis à jour le 2 septembre 2026 : tableau de coût sur 3 ans recalculé avec formule visible (matériel au prix marchand daté plus électricité au tarif réglementé), les montants « ~12 000 / ~25 000 / ~200 000 € » du 2 août, qui mêlaient sans détail acquisition et prestations, sont retirés ; le DGX Station est chiffré à 95 000 € HT (relevé pi3g du 27 août 2026), NVIDIA ne publiant pas de prix ; condition de revenu mensuel ajoutée à la licence Qwen3.8-Max ; toutes les valeurs du tableau des modèles relues dans les dépôts Hugging Face.
Mis à jour le 1er septembre 2026 : tableau des modèles corrigé contre les dépôts Hugging Face. La version du 2 août comparait un modèle inexistant (« Qwen 3.7 ») et donnait des paramètres actifs, des contextes et des licences faux pour Kimi K3, GLM 5.2, Kimi K2.7 Code, MiniMax M3 et Llama 3.1 70B. Les colonnes de scores et de tarifs API, qui n'avaient pas de source datée, sont retirées.
Méthodologie
Ce comparatif évalue les modèles à poids ouverts pour un déploiement local sur trois machines (DGX Spark 128 Go, cluster 2× Spark 256 Go, DGX Station GB300 748 Go). Les critères sont les paramètres totaux et actifs, et le contexte natif, soit la valeur max_position_embeddings du config.json.
S'y ajoutent les poids publiés (somme des fichiers safetensors du dépôt, dans le format où l'éditeur les distribue), la licence (fichier LICENSE du dépôt) et le matériel (le modèle tient-il en mémoire, poids publiés tels quels ou requantifiés à 4 bits).
Chaque valeur a été relue le 1er septembre 2026 dans le config.json, le README et la licence du dépôt Hugging Face de chaque modèle, puis confrontée à la base de faits du site (connaissance/faits.yaml) pour détecter toute divergence avant publication.
Les indices de tiers, comme l'Intelligence Index d'Artificial Analysis, ne sont pas repris en colonne. À la date de consultation (v4.3.2, 26 septembre 2026), cet indice ne couvre pas tous les modèles du tableau, et les scores que publient les éditeurs ne se comparent pas d'un éditeur à l'autre.
Les tarifs d'API ne sont pas repris non plus : ils changent sans préavis et se lisent sur la grille de chaque éditeur, que nos articles de coût citent chaque fois avec leur date de relevé, ce qui suffit à refaire le calcul.
Comparatif des modèles open weight pour déploiement local
Lecture : « Paramètres totaux » et « actifs » sont les chiffres annoncés par l'éditeur dans la fiche du modèle ; le compteur de Hugging Face, qui mesure des éléments de tenseurs, diffère de quelques pour cent (753 milliards pour GLM 5.3, 291 pour DeepSeek V4 Flash).
| Modèle | Paramètres totaux | Actifs par token | Contexte natif (tokens) | Poids publiés | Licence | Source |
|---|---|---|---|---|---|---|
| DeepSeek V4 Flash 0731 | 284 milliards | 13 milliards | 1 048 576 | 167 Go (FP4 + FP8) | MIT | deepseek-ai/DeepSeek-V4-Flash-0731 |
| DeepSeek V4 Pro | 1 600 milliards | 49 milliards | 1 048 576 | 865 Go (FP4 + FP8) | MIT | deepseek-ai/DeepSeek-V4-Pro |
| Kimi K3 | 2 800 milliards | 104 milliards | 1 048 576 | 1 561 Go (MXFP4) | Kimi K3 License | moonshotai/Kimi-K3 |
| GLM 5.3 | 744 milliards | 40 milliards | 1 048 576 | 756 Go (FP8) | GLM-5.3 | zai-org/GLM-5.3 |
| Kimi K2.7 Code | 1 000 milliards | 32 milliards | 262 144 | 595 Go (compressed-tensors) | MIT modifiée | moonshotai/Kimi-K2.7-Code |
| MiniMax M3 | 428 milliards (« environ », selon l'éditeur) | 23 milliards (« environ ») | 1 048 576 | 854 Go (BF16) | MiniMax Community | MiniMaxAI/MiniMax-M3 |
| Qwen3.8-2.4T-A95B | 2 400 milliards | 95 milliards | 262 144 (extensible à 1 010 000 selon la fiche) | 4 892 Go (BF16) | Qwen3.8-Max | Qwen/Qwen3.8-2.4T-A95B |
| Qwen3.8-27B | 27 milliards (dense) | 27 milliards | 262 144 | 56 Go (BF16) | Apache 2.0 | Qwen/Qwen3.8-27B |
| Llama 3.1 70B Instruct | 70 milliards (dense) | 70 milliards | 131 072 (« 128k » sur la fiche Meta) | 141 Go (BF16) | Llama 3.1 Community | meta-llama/Llama-3.1-70B-Instruct |
Le contexte natif est la valeur max_position_embeddings du config.json ; DeepSeek, Kimi K2.7 Code et Qwen y ajoutent une extension YaRN que la fiche annonce séparément.
Les poids publiés sont la somme des fichiers safetensors du dépôt, si bien qu'un modèle distribué en BF16 (MiniMax M3, Qwen, Llama) pèse deux octets par paramètre, un modèle en FP8 (GLM 5.3) un octet, et un modèle en FP4 ou MXFP4 (DeepSeek, Kimi K3) autour d'un demi-octet.
C'est ce qui explique que Kimi K3 (2 800 milliards) pèse à peine plus du double de GLM 5.3 (744 milliards). Sur les modèles denses (Qwen3.8-27B, Llama 3.1 70B), tous les paramètres sont actifs à chaque token, ce qui rend leur débit prévisible.
Comparatif des modèles open weight par matériel
Un modèle tient sur une machine si ses poids tiennent en mémoire avec une marge pour le cache KV. La colonne « à 4 bits » applique la formule des fiches de dimensionnement du site : paramètres totaux × 0,5 octet, plus 15 % de marge d'exécution.
Elle est comparée à la mémoire utilisable de chaque machine : 128 Go (DGX Spark), 256 Go (cluster 2× Spark), 748 Go (DGX Station GB300). Un « Non » signifie que même requantifié à 4 bits, le modèle dépasse la mémoire ; il ne préjuge pas de quantifications plus agressives.
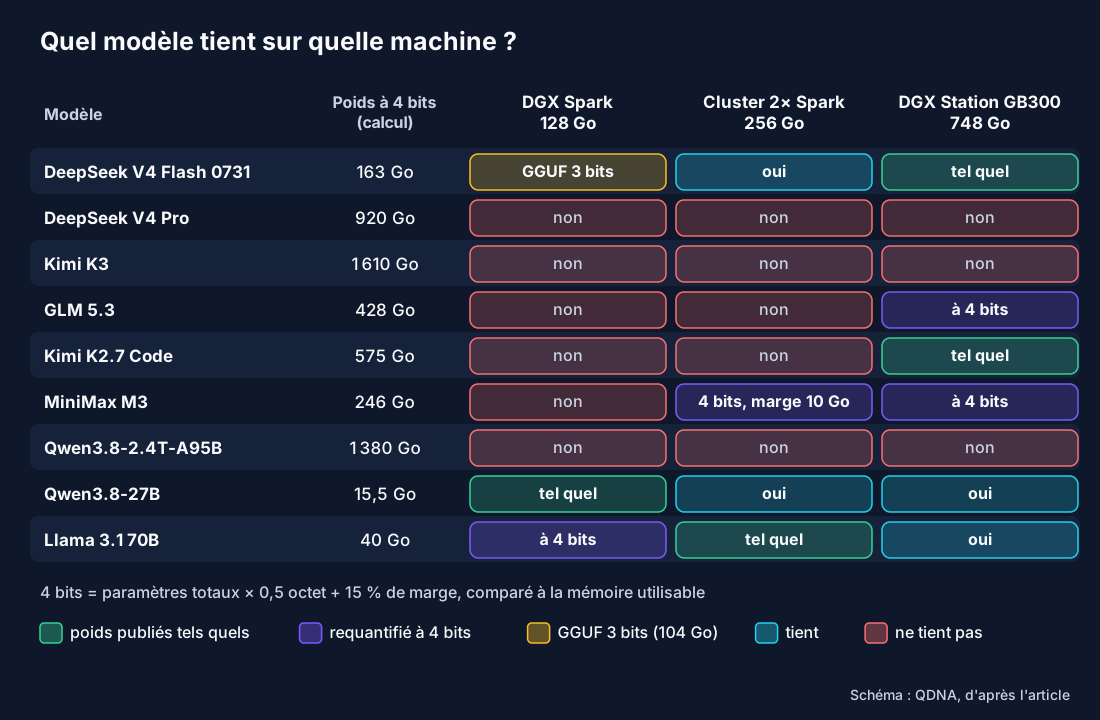
| Modèle | Poids à 4 bits (calcul) | DGX Spark 128 Go | Cluster 2× Spark 256 Go | DGX Station GB300 748 Go |
|---|---|---|---|---|
| DeepSeek V4 Flash 0731 | 163 Go | Non à 4 bits ; oui en GGUF 3 bits Unsloth (104 Go), voir le guide DGX | Oui | Oui, poids publiés tels quels (167 Go) |
| DeepSeek V4 Pro | 920 Go | Non | Non | Non (920 Go > 748 Go) |
| Kimi K3 | 1 610 Go | Non | Non | Non (1 561 Go publiés > 748 Go) |
| GLM 5.3 | 428 Go | Non | Non | Oui à 4 bits |
| Kimi K2.7 Code | 575 Go | Non | Non | Oui, poids publiés tels quels (595 Go) |
| MiniMax M3 | 246 Go | Non | Oui à 4 bits, 10 Go de marge seulement | Oui à 4 bits |
| Qwen3.8-2.4T-A95B | 1 380 Go | Non | Non | Non (1 380 Go > 748 Go) |
| Qwen3.8-27B | 15,5 Go | Oui, poids publiés tels quels (56 Go) | Oui | Oui |
| Llama 3.1 70B Instruct | 40 Go | Oui à 4 bits | Oui, poids publiés tels quels (141 Go) | Oui |
Lecture : trois modèles de niveau frontière tiennent sur une DGX Station GB300 : DeepSeek V4 Flash 0731 sans requantifier, GLM 5.3 et Kimi K2.7 Code à 4 bits. Sur un cluster de deux DGX Spark, DeepSeek V4 Flash 0731 reste le seul modèle de cette classe qui tienne avec une marge raisonnable pour le cache KV.
Le détail par quantification (nombre d'utilisateurs simultanés selon le contexte) est dans notre guide DeepSeek V4 Flash sur DGX Station et cluster 2× Spark, qui donne aussi la recette vLLM et les pièges de la mémoire unifiée.
Kimi K3, DeepSeek V4 Pro et Qwen3.8-2.4T-A95B demandent une machine multi-GPU à plus de 900 Go de mémoire, ce qui les sort du périmètre d'un déploiement à un nœud.
Comparatif des modèles open weight par usage
Lecture : pour un déploiement local sur DGX Station GB300, le choix par défaut est DeepSeek V4 Flash 0731 (167 Go publiés, contexte 1 048 576, coût par million de tokens [À MESURER] sur cette machine faute de débit publié ; 9,4 €/M en hypothèse médiane sur DGX Spark selon notre calcul).
| Usage | Modèle recommandé | Justification |
|---|---|---|
| Agents de code, ingénierie logicielle | DeepSeek V4 Flash 0731 | Scores publiés par DeepSeek sur la fiche du modèle : Terminal Bench 2.1 82,7 %, NL2Repo 54,2 %, DeepSWE 54,4 %, Toolathlon-Verified 70,3 %. Contexte 1 048 576, 167 Go publiés. |
| Chat généraliste sur site | DeepSeek V4 Flash 0731 ou GLM 5.3 | Les deux tiennent sur DGX Station GB300 avec un contexte d'un million de tokens ; GLM 5.3 demande une conversion à 4 bits (756 Go publiés en FP8 ; conversion officielle nvidia/GLM-5.3-NVFP4, 464 Go, depuis le 14 septembre 2026). |
| Assistant de code spécialisé | Kimi K2.7 Code | 1 000 milliards de paramètres, 32 actifs, 262 144 tokens de contexte, 595 Go publiés qui tiennent tels quels sur DGX Station. |
| Raisonnement général, précision | Claude Opus 5.5 (API fermée) | Les épreuves de connaissance et de raisonnement restent le terrain des modèles propriétaires ; leurs éditeurs ne publient pas de scores sur les mêmes benchmarks que les modèles ouverts, nous n'en comparons donc pas. |
| Modèle compact (TPE, poste de travail) | Qwen3.8-27B | 27 milliards de paramètres denses, 56 Go en BF16, 15,5 Go à 4 bits, contexte 262 144, Apache 2.0. Voir Qwen3.8-27B en local. |
| Fine-tuning sur données métier | DeepSeek V4 Flash 0731 | Poids ouverts sous MIT ; recette de fine-tuning documentée par Unsloth. |
| Données sensibles, RGPD, HDS, SecNumCloud | DeepSeek V4 Flash 0731 en local | Poids ouverts, exécution sur site, aucun transfert de données, pas de limite de débit ni de retrait par un éditeur. |
| Budget serré, faible volume | DeepSeek API V4 Flash 0731 | Pas d'investissement matériel ; tarif à lire sur la grille tarifaire DeepSeek, qui distingue heures pleines et heures creuses. |
| Modèle ouvert le plus grand | Kimi K3 | 2 800 milliards de paramètres, 104 actifs, contexte 1 048 576, vision native ; 1 561 Go publiés, hors de portée d'une machine à un nœud. Voir la fiche Kimi K3. |
Pour un DGX Spark 128 Go, DeepSeek V4 Flash 0731 en GGUF 3 bits (104 Go) ou Qwen3.8-27B sans requantifier. Pour un usage par API sans matériel, DeepSeek API V4 Flash 0731.
Comparatif des modèles open weight par coût total de possession (TCO) sur 3 ans
Les montants ci-dessous se limitent à ce qui se calcule depuis des sources publiques : matériel au prix de référence, soit pour le DGX Spark PNY 7 000 € HT, prix retenu en octobre 2026 (relevé LDLC.pro du 26 septembre : 5 083 € HT), et électricité sur trois ans à l'alimentation nominale de la fiche NVIDIA, hypothèse haute.
Cette hypothèse retient 240 W × 8 760 h × 3 = 6 307 kWh (ServeTheHome mesure 60 à 200 W en charge), au Tarif Bleu professionnel d'EDF, option Base, grille du 1er août 2026 (0,1624 € HT/kWh, hors TVA, délibération CRE 2026-147), donc 7 000 + 1 024 ≈ 8 000 € HT pour un Spark et le double, 16 000 € HT, pour deux.
Pour la DGX Station, 150 000 € HT, prix retenu en octobre 2026 après la hausse constatée (configuration Exxact Valence chez pi3g, page du 14 septembre 2026 : 95 000 € HT ; 88 000 à 110 500 € HT selon l'OEM), plus 1 600 W × 8 760 h × 3 = 42 048 kWh, soit ≈ 156 800 € HT.
Intégration, exploitation et formation se chiffrent sur devis et n'y figurent pas. Ces montants dépendent de la machine, pas du modèle, et une cellule « Ne tient pas » renvoie au tableau matériel ci-dessus, qui explique pourquoi le modèle ne loge pas.
Le coût par million de tokens n'est calculé que pour DeepSeek V4 Flash 0731, seul modèle pour lequel un débit tiers est publié avec ses conditions sur DGX Spark ; sur DGX Station, aucun débit publié : [À MESURER]. Pour les autres, il n'est pas calculé.
| Modèle | DGX Spark 128 Go (matériel + électricité, 3 ans, HT) | Cluster 2× Spark 256 Go (matériel + électricité, 3 ans, HT) | DGX Station GB300 748 Go (3 ans) | Coût par million de tokens |
|---|---|---|---|---|
| DeepSeek V4 Flash 0731 | ≈ 8 000 € HT (GGUF 3 bits) | ≈ 16 000 € HT | ≈ 156 800 € HT | 9,4 €/M sur DGX Spark en hypothèse médiane (30 tokens/s, 30 % de charge), de 2,4 à 42 €/M selon débit et charge ; [À MESURER] sur DGX Station (calcul et sources) |
| DeepSeek V4 Pro | Ne tient pas | Ne tient pas | Ne tient pas | Non calculé |
| Kimi K3 | Ne tient pas | Ne tient pas | Ne tient pas | Non calculé |
| GLM 5.3 | Ne tient pas | Ne tient pas | ≈ 156 800 € HT (4 bits) | Non calculé |
| Kimi K2.7 Code | Ne tient pas | Ne tient pas | ≈ 156 800 € HT | Non calculé |
| MiniMax M3 | Ne tient pas | ≈ 16 000 € HT (4 bits, marge faible) | ≈ 156 800 € HT (4 bits) | Non calculé |
| Qwen3.8-2.4T-A95B | Ne tient pas | Ne tient pas | Ne tient pas | Non calculé |
| Qwen3.8-27B | ≈ 8 000 € HT | ≈ 16 000 € HT | ≈ 156 800 € HT | Non calculé |
| Llama 3.1 70B Instruct | ≈ 8 000 € HT (4 bits) | ≈ 16 000 € HT | ≈ 156 800 € HT | Non calculé |
Lecture : la machine la moins chère qui serve un modèle de niveau frontière est le cluster de deux DGX Spark avec DeepSeek V4 Flash 0731, et la DGX Station GB300 ouvre GLM 5.3 et Kimi K2.7 Code en plus.
Un DGX Spark seul se limite à DeepSeek V4 Flash 0731 requantifié en 3 bits, à Qwen3.8-27B et à Llama 3.1 70B à 4 bits, ce qui suffit à un poste de développement mais pas à un service partagé.
Comparatif des modèles open weight par licence et souveraineté
Les conditions ci-dessous sont lues dans le fichier LICENSE de chaque dépôt le 1er septembre 2026. Une licence à conditions n'interdit pas un déploiement d'entreprise ; elle impose une mention, un seuil ou un accord préalable qu'il faut connaître avant de signer.
| Modèle | Licence | Conditions particulières | Exécution locale (DGX Station 748 Go) |
|---|---|---|---|
| DeepSeek V4 Flash 0731 | MIT | Aucune | Oui |
| DeepSeek V4 Pro | MIT | Aucune | Non (920 Go à 4 bits) |
| Kimi K3 | Kimi K3 License | Accord séparé avec Moonshot AI pour un opérateur de modèle en service dont le chiffre d'affaires dépasse 20 M$ sur douze mois ; mention « Kimi K3 » au-delà de 100 millions d'utilisateurs mensuels ou 20 M$ de revenu mensuel. | Non (1 561 Go publiés) |
| GLM 5.3 | GLM-5.3 | Licence propre de Z.ai, à relire dans le dépôt ; GLM 5.2, même base, reste publié sous MIT | Oui à 4 bits |
| Kimi K2.7 Code | MIT modifiée | Mention « Kimi K2.7 Code » au-delà de 100 millions d'utilisateurs mensuels ou 20 M$ de revenu mensuel. | Oui |
| MiniMax M3 | MiniMax Community | Usage non commercial libre ; usage commercial soumis à la mention « Built with MiniMax M3 », à une notification à MiniMax, et à une autorisation écrite au-delà de 20 M$ de revenu annuel. | Oui à 4 bits |
| Qwen3.8-2.4T-A95B | Qwen3.8-Max | Mention au-delà de 100 millions d'utilisateurs mensuels ou de 20 M$ de revenu mensuel ; accord séparé pour un opérateur de modèle en service ou d'assistant IA dont le chiffre d'affaires dépasse 50 M$ sur douze mois. | Non (1 380 Go à 4 bits) |
| Qwen3.8-27B | Apache 2.0 | Aucune | Oui |
| Llama 3.1 70B Instruct | Llama 3.1 Community | Mention « Built with Llama » et copie de la licence à la redistribution ; licence spécifique à demander à Meta au-delà de 700 millions d'utilisateurs mensuels. | Oui |
Lecture : pour la souveraineté et la conformité RGPD, HDS ou SecNumCloud, les modèles sous licence permissive et sans condition qui tiennent sur une DGX Station sont DeepSeek V4 Flash 0731 (MIT) et Qwen3.8-27B (Apache 2.0).
GLM 5.3 y tient à 4 bits sous la licence GLM-5.3 de Z.ai, et GLM 5.2, même base sous MIT, reste disponible. Les licences Kimi, MiniMax et Llama restent compatibles avec un déploiement interne d'entreprise, dont les seuils de 100 ou 700 millions d'utilisateurs ne sont pas atteints, mais elles se relisent avant tout usage commercial.
Conclusion : quel modèle open weight pour quel cas d'usage
La conclusion associe à chaque cas d'usage le modèle open weight qui tient sur le matériel visé : DeepSeek V4 Flash 0731 pour le code et les données sensibles, GLM 5.3 pour le contexte long, Kimi K2.7 Code pour l'assistant spécialisé.
| Cas d'usage | Modèle recommandé | Justification |
|---|---|---|
| Agents de code, ingénierie logicielle | DeepSeek V4 Flash 0731 | Terminal Bench 2.1 82,7 %, NL2Repo 54,2 %, DeepSWE 54,4 % (scores publiés par DeepSeek), contexte 1 048 576, tient sur DGX Station et cluster 2× Spark. |
| Raisonnement général, précision | Claude Opus 5.5 (API fermée) | Terrain des modèles propriétaires ; pas de scores publiés sur les mêmes benchmarks, donc pas de comparaison chiffrée. |
| Données sensibles, RGPD, HDS, SecNumCloud | DeepSeek V4 Flash 0731 en local | MIT sans condition, exécution sur site, aucun transfert de données. |
| Chat généraliste avec contexte d'un million de tokens | GLM 5.3 ou DeepSeek V4 Flash 0731 | Les deux tiennent sur DGX Station GB300 ; GLM 5.3 à 4 bits, DeepSeek tel quel. |
| Assistant de code spécialisé | Kimi K2.7 Code | 595 Go publiés qui tiennent tels quels sur DGX Station, 262 144 tokens de contexte, MIT modifiée. |
| Budget serré, faible volume | DeepSeek API V4 Flash 0731 | Pas d'investissement ni de maintenance ; tarif sur la grille de l'éditeur. |
| Modèle ouvert le plus grand | Kimi K3 | 2 800 milliards, 104 actifs, 1 048 576 tokens, vision native ; 1 561 Go publiés, multi-GPU obligatoire. |
| Modèle compact (TPE, poste de travail) | Qwen3.8-27B | 27 milliards denses, 56 Go en BF16, 15,5 Go à 4 bits, Apache 2.0, tient sur un DGX Spark ou une carte unique. |
Références
- DeepSeek V4 Flash 0731, dépôt officiel Hugging Face
- DeepSeek V4 Pro, dépôt officiel Hugging Face
- Kimi K3, dépôt officiel Hugging Face (fiche, config.json, licence)
- GLM 5.3, dépôt officiel Hugging Face et README GLM-5 de Z.ai (744B-A40B)
- Kimi K2.7 Code, dépôt officiel Hugging Face
- MiniMax M3, dépôt officiel Hugging Face
- Qwen3.8-2.4T-A95B, dépôt officiel Hugging Face
- Qwen3.8-27B, dépôt officiel Hugging Face
- Llama 3.1 70B Instruct, dépôt officiel Hugging Face et fiche de modèle Llama 3.1 (Meta, GitHub)
- Artificial Analysis, modèles à poids ouverts (Intelligence Index v4.1.1, consulté le 1er septembre 2026)
- Grille tarifaire de l'API DeepSeek
- Unsloth, documentation DeepSeek V4
- Fiche QDNA : DeepSeek V4
- Fiche QDNA : Kimi K3
- Fiche QDNA : vLLM
- Fiche QDNA : DGX Station
- Fiche QDNA : DGX Spark
Questions fréquentes
Quel est le meilleur modèle open weight pour un déploiement local en 2026 ?
Pour un déploiement à un nœud, DeepSeek V4 Flash 0731 : 284 milliards de paramètres dont 13 actifs, contexte de 1 048 576 tokens, 167 Go de poids publiés en FP4 et FP8, licence MIT. C'est le seul modèle de niveau frontière dont les poids publiés tiennent tels quels sur une DGX Station GB300 et, quantifié, sur un cluster de deux DGX Spark. Sur les benchmarks agentiques que DeepSeek publie (Terminal Bench 2.1 82,7 %, NL2Repo 54,2 %), il devance la version Pro du même éditeur.
Quelle est la différence entre DeepSeek V4 Flash 0731 et V4 Pro ?
V4 Flash 0731 totalise 284 milliards de paramètres dont 13 actifs par token ; V4 Pro en totalise 1 600 dont 49 actifs. Les deux ont un contexte natif de 1 048 576 tokens et une licence MIT. Les poids publiés pèsent 167 Go pour Flash et 865 Go pour Pro : Flash tient sur une DGX Station GB300, Pro non. Sur les benchmarks agentiques publiés par DeepSeek (Terminal Bench 2.1, NL2Repo, DeepSWE, Toolathlon), Flash 0731 dépasse la preview d'avril de Pro ; la révision Pro 0813 du 13 août 2026 publie depuis 87,9 sur Terminal Bench 2.1 (banc Z.ai).
Quel modèle open weight tient sur un DGX Spark 128 Go ?
Sans requantifier, Qwen3.8-27B (56 Go en BF16). À 4 bits, Llama 3.1 70B (environ 40 Go, calcul : 70 milliards × 0,5 octet + 15 % de marge). DeepSeek V4 Flash 0731 n'y tient qu'en GGUF 3 bits (104 Go, version Unsloth), avec 24 Go de marge pour le cache KV. GLM 5.3, Kimi K2.7 Code, MiniMax M3, Kimi K3, DeepSeek V4 Pro et Qwen3.8-2.4T-A95B dépassent 128 Go même à 4 bits.
Quel modèle open weight tient sur un DGX Station GB300 ?
Avec 748 Go de mémoire utilisable : DeepSeek V4 Flash 0731 (167 Go publiés) et Kimi K2.7 Code (595 Go publiés) tels quels ; GLM 5.3 (428 Go à 4 bits) et MiniMax M3 (246 Go à 4 bits) après requantification ; Qwen3.8-27B et Llama 3.1 70B sans difficulté. Kimi K3 (1 561 Go publiés), DeepSeek V4 Pro (920 Go à 4 bits) et Qwen3.8-2.4T-A95B (1 380 Go à 4 bits) ne tiennent pas.
Pourquoi le tableau ne donne-t-il ni score ni tarif d'API ?
Les scores que publient les éditeurs sont mesurés dans des conditions différentes d'un éditeur à l'autre et ne se comparent pas ; l'indice d'Artificial Analysis, indépendant, ne couvrait pas tous les modèles du tableau à la date de consultation (1er septembre 2026). Les tarifs d'API changent sans préavis et se lisent sur la grille de chaque éditeur. Nous préférons une colonne absente à une valeur invérifiable.