Résultats publiés de DeepSeek V4 Flash 0731 (open weight, 2026)
Les résultats de benchmark publiés par les éditeurs pour deux modèles open weight de 2026 : DeepSeek V4 Flash 0731 (284B / 13B actifs, contexte 1M) et GLM 5.2 (744B), agentique et code d'un côté, connaissance et raisonnement de l'autre. Aucune estimation : « non publié » là où l'éditeur ne publie pas la mesure.
Mis à jour le 11 octobre 2026 : coûts en local de DeepSeek V4 Flash 0731 alignés sur les prix de référence du DGX Spark retenus le 8 octobre 2026, soit 2,4 à 42 €/M selon débit et charge et 9,4 €/M dans l'hypothèse médiane.
Mis à jour le 26 septembre 2026 : grille DeepSeek du 26 septembre 2026 (V4 Flash 0731 retiré de l'API le 10 septembre, successeur V4.1 Flash), révision V4 Pro 0813, renvoi vers GLM 5.3 qui succède à GLM 5.2 ; les scores publiés par les éditeurs restent inchangés.
Mis à jour le 2 septembre 2026 : score Terminal Bench 2.1 de GLM 5.2 distingué selon le harnais (81,0 en Terminus-2, 82,7 avec le meilleur harnais rapporté) au lieu d'une égalité avec DeepSeek ; le rapport arXiv 2602.15763 est celui de GLM-5, cité par la fiche GLM 5.2 ; recette de déploiement corrigée (le checkpoint officiel de 167 Go ne tient pas dans un Spark seul).
Méthodologie
Cet article ne rapporte que des scores publiés par les éditeurs sur leurs fiches de modèle (model cards) et rapports officiels. DeepSeek et Zhipu AI (GLM) sont, à notre connaissance, les deux seuls éditeurs à publier ces benchmarks pour les checkpoints exacts couverts ici.
Quand un éditeur ne publie pas une mesure, la case porte « n.p. » (non publié) : aucune valeur n'est estimée, ni recopiée d'un tiers, ni comparée à un modèle fermé dont l'éditeur ne publie pas les mêmes benchmarks. Pour une comparaison inter-modèles homogène et indépendante, nous renvoyons aux panels Artificial Analysis et LiveBench.
Les sources sont : arXiv 2606.19348 (rapport technique DeepSeek V4), fiche Hugging Face DeepSeek V4 Flash 0731, fiche Hugging Face GLM 5.2 et rapport technique GLM-5 (arXiv 2602.15763), que la fiche GLM 5.2 cite. Fiches relues le 2 septembre 2026.
Benchmarks officiels publiés
n.p. = non publié par l'éditeur. Scores issus des model cards / rapports officiels : DeepSeek (Hugging Face), GLM 5.2 (Hugging Face, rapport arXiv 2602.15763). Pour une comparaison inter-modèles indépendante : Artificial Analysis et LiveBench.
| Benchmark | DeepSeek V4 Flash 0731 | GLM 5.2 |
|---|---|---|
| Terminal Bench 2.1 (agentique, code) | 82,7 % | 81,0 % (harnais Terminus-2) ; 82,7 % avec le meilleur harnais rapporté (Claude Code) |
| NL2Repo (langage naturel vers dépôt) | 54,2 % | 48,9 % |
| Cybergym (cybersécurité) | 76,7 % | n.p. |
| DeepSWE (ingénierie logicielle) | 54,4 % | 46,2 % |
| Toolathlon-Verified (appels d'outils) | 70,3 % | n.p. |
| GPQA Diamond (scientifique) | n.p. | 91,2 % |
| Humanity's Last Exam (sans outils) | n.p. | 40,5 % |
Lecture. DeepSeek publie ses résultats sur des benchmarks agentiques et de code (Terminal Bench, NL2Repo, Cybergym, DeepSWE, Toolathlon), là où GLM 5.2 documente surtout la connaissance et le raisonnement scientifique (GPQA Diamond, Humanity's Last Exam).
Sur Terminal Bench 2.1, seul benchmark commun aux deux fiches, GLM 5.2 publie 81,0 avec le harnais Terminus-2 et 82,7 avec le meilleur harnais rapporté (Claude Code), quand DeepSeek publie 82,7 avec son propre harnais : trois conditions différentes, qui interdisent d'y lire une égalité.
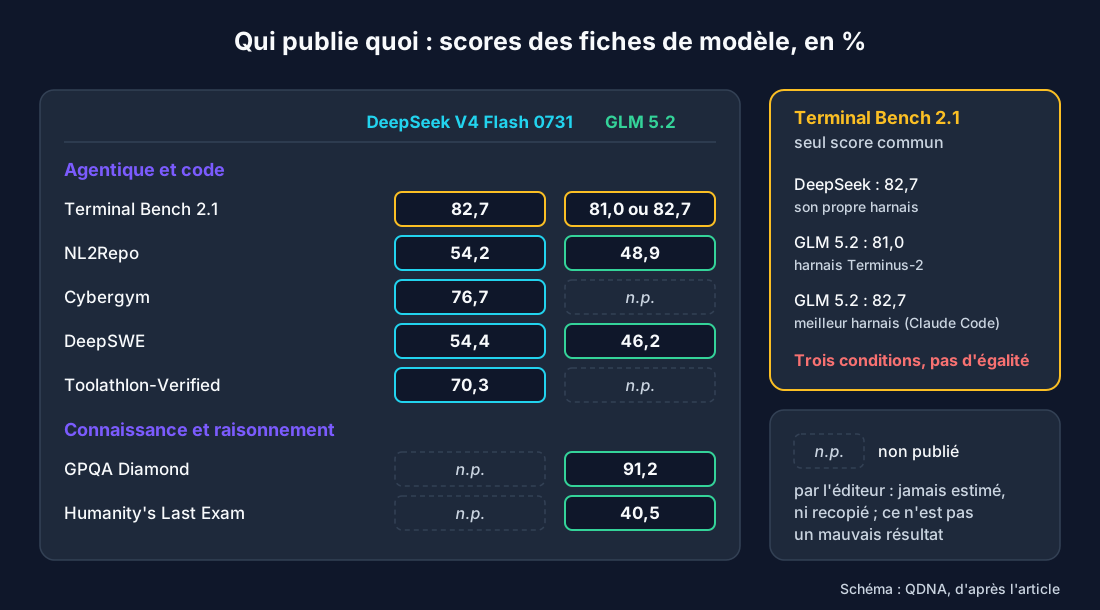
Une case « n.p. » ne signale pas une contre-performance mais l'absence de mesure publiée par l'éditeur ; la combler par une estimation reviendrait à inventer un chiffre. Pour situer ces modèles face à d'autres, ouverts ou fermés, sur une méthodologie unique, consultez Artificial Analysis ou LiveBench.
Recommandations par usage
Lecture. Pour un déploiement souverain sur site, DeepSeek V4 Flash 0731 est le choix par défaut : poids ouverts sous licence MIT, contexte 1M et le jeu de benchmarks agentiques publiés le plus complet. GLM 5.2 complète le tableau sur la connaissance et le raisonnement scientifique.
| Usage | Modèle recommandé | Pourquoi | Coût indicatif |
|---|---|---|---|
| Agents de code, ingénierie logicielle | DeepSeek V4 Flash 0731 | Le jeu de benchmarks agentiques publiés le plus complet (Terminal Bench 2.1, NL2Repo, DeepSWE, Toolathlon, Cybergym), contexte 1M | De 2,4 à 42 €/M en local sur DGX Spark selon débit et taux de charge, 9,4 €/M en hypothèse médiane (calcul et sources) ; 0,375 à 0,75 $/M via l'API pour le successeur V4.1 Flash (heures creuses ou pleines, 26 septembre 2026 ; 0731 retiré de l'API le 10 septembre) |
| Connaissance, raisonnement scientifique | GLM 5.2 | Publie GPQA Diamond 91,2 et Humanity's Last Exam 40,5 | voir Artificial Analysis |
| Raisonnement de pointe, précision maximale | Modèles propriétaires (Claude, GPT, Gemini) | Leurs éditeurs ne publient pas ces benchmarks open weight ; comparaison sur une méthodologie unique | voir Artificial Analysis |
| Souveraineté, RGPD, HDS, SecNumCloud | DeepSeek V4 Flash 0731 en local | Poids ouverts sous licence MIT, exécution sur site, pas de transfert de données hors infrastructure | 2,4 à 42 €/M en local sur DGX Spark selon débit et charge, 9,4 €/M en hypothèse médiane |
| Fine-tuning sur données métier | DeepSeek V4 Flash 0731 (Unsloth) | Poids ouverts, fine-tuning QLoRA avec Unsloth | 2,4 à 42 €/M en local sur DGX Spark selon débit et charge, 9,4 €/M en hypothèse médiane |
Le dimensionnement matériel (GPU, mémoire, débit, utilisateurs concurrents) est traité dans notre guide de déploiement DeepSeek sur DGX Station et cluster Spark.
Licence et souveraineté
Les deux modèles sont distribués sous licence MIT, poids ouverts : exécution entièrement sur site, sans transfert de données hors de l'infrastructure, sans dépendance à une API tierce ni risque de désactivation. C'est la base de la conformité RGPD, HDS et SecNumCloud pour les données sensibles.
| Modèle | Licence | Poids ouverts | Exécution sur site | Fine-tuning |
|---|---|---|---|---|
| DeepSeek V4 Flash 0731 | MIT | Oui | Oui | Oui (Unsloth) |
| GLM 5.2 | MIT | Oui | Oui | Oui (Unsloth) |
Conclusion
Sur les benchmarks que leurs éditeurs publient, DeepSeek V4 Flash 0731 documente le volet agentique et code (Terminal Bench 2.1 82,7, NL2Repo 54,2, DeepSWE 54,4, Toolathlon 70,3, Cybergym 76,7), tandis que GLM 5.2 documente le volet connaissance et raisonnement (GPQA Diamond 91,2, Humanity's Last Exam 40,5).
Les deux sont open weight sous licence MIT, donc déployables sur site. Nous ne les classons pas face aux modèles propriétaires : ces derniers ne publient pas les mêmes mesures, et toute comparaison chiffrée passe par un panel indépendant à méthodologie unique comme Artificial Analysis ou LiveBench.
Références
- DeepSeek V4 Flash 0731, dépôt officiel Hugging Face
- Rapport technique DeepSeek V4 (arXiv 2606.19348)
- Artificial Analysis Intelligence Index v4.1
- LiveBench open weight rankings
- OpenRouter model rankings
- Unsloth, documentation DeepSeek V4
- Fiche QDNA : DeepSeek V4
- Fiche QDNA : vLLM
- Fiche QDNA : DGX Station
- Fiche QDNA : DGX Spark
Questions fréquentes
Quels benchmarks DeepSeek V4 Flash 0731 publie-t-il en 2026 ?
Sur les benchmarks publiés par leur éditeur, DeepSeek V4 Flash 0731 (284B / 13B actifs, contexte 1M, poids FP4+FP8) documente surtout l'agentique et le code : 82,7 sur Terminal Bench 2.1, 54,2 sur NL2Repo, 76,7 sur Cybergym, 54,4 sur DeepSWE et 70,3 sur Toolathlon-Verified. GLM 5.2 (744B) publie 91,2 sur GPQA Diamond et 40,5 sur Humanity's Last Exam. Nous ne classons pas ces modèles face aux modèles fermés, qui ne publient pas ces mêmes benchmarks : pour une comparaison inter-modèles, voir Artificial Analysis et LiveBench.
Quelle est la différence entre DeepSeek V4 Flash 0731 et V4 Pro ?
V4 Flash 0731 est un MoE de 284 milliards de paramètres avec 13 milliards actifs par token, contexte 1M, et il dépasse V4 Pro (1.6T, 49B actifs) sur tous les benchmarks agentiques publiés par DeepSeek (Terminal Bench 2.1, NL2Repo, Cybergym, DeepSWE, Toolathlon). V4 Pro reste en preview et n'a pas reçu de révision 0731.
Que signifie « n.p. » dans le tableau des benchmarks ?
« n.p. » signifie non publié : l'éditeur ne publie pas cette mesure pour le checkpoint exact. Nous ne comblons jamais une case « n.p. » par une estimation ou un score recopié d'un tiers. Pour situer les modèles sur une méthodologie unique et indépendante, consultez Artificial Analysis ou LiveBench.
DeepSeek V4 Flash 0731 tient-il sur un DGX Spark 128 Go ?
Oui. En quantification UD-IQ3_XXS (104 Go), DeepSeek V4 Flash 0731 tient sur un DGX Spark 128 Go en laissant de la place pour le cache KV. Le dimensionnement détaillé (débit, contexte, formats, utilisateurs concurrents) est traité dans notre guide de déploiement DeepSeek sur DGX Station et cluster Spark.
Comment déployer DeepSeek V4 Flash 0731 en local sur DGX Spark ou DGX Station ?
Le checkpoint officiel pèse 167 Go (48 fichiers safetensors relus le 2 septembre 2026) : il ne tient pas dans un DGX Spark seul de 128 Go. Sur une seule machine de 128 Go, utilisez les GGUFs Unsloth Dynamic avec llama.cpp (UD-IQ3_XXS, 104 Go ; UD-Q8_K_XL, 162 Go, annoncé sans perte, exige davantage de mémoire). Sur un cluster 2× Spark reliés par ConnectX-7 200 Gb/s : conteneur NVIDIA NGC vLLM du playbook (tag 26.05-py3 au 2 septembre 2026), vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 --trust-remote-code --kv-cache-dtype fp8 --enable-expert-parallel --tensor-parallel-size 2. Sur une DGX Station GB300 : même commande avec --tensor-parallel-size 1. vLLM 0.25 au minimum pour le module DSpark.