Qwen3.8-Flash-Next sur Mac Studio M5 Ultra : 112 Go de poids, un million de tokens
Alibaba a publié le 26 août 2026 un modèle de 180 milliards de paramètres dont six seulement travaillent à chaque token, et dont trente-six des quarante-huit couches n'accumulent aucun cache. Voici ce qu'il demande à un Mac Studio M5 Ultra de 512 Go, et le débit qu'on peut en attendre.
Mis à jour le 26 septembre 2026 : disponibilité du Mac Studio M5 Ultra relue le 26 septembre 2026 : livré depuis le 22 septembre en 96 et 256 Go, option 512 Go toujours annoncée pour fin octobre, aucune mesure indépendante reproductible publiée ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Ce que ce modèle est vraiment
La fiche officielle annonce 125 milliards de paramètres dont 6 milliards actifs par token, auxquels s'ajoutent 51 milliards d'embeddings n-gram et 4 milliards pour la tête de prédiction multi-token, ce qui porte le fichier à 180 milliards de paramètres au total (179,999 milliards au compteur de Hugging Face).
Ces embeddings ne sont pas une couche de calcul mais une table de correspondance de vingt millions de bigrammes et trigrammes, placée à la deuxième couche, et Qwen la présente comme un axe de mise à l'échelle moins gourmand en calcul qu'un mélange d'experts.
Le config.json du dépôt donne la structure exacte, et c'est elle qui commande tout le dimensionnement : quarante-huit couches, dont trente-six en attention linéaire de type Gated DeltaNet et douze seulement en attention complète, avec deux têtes clé-valeur de dimension 256. Le routage active dix experts sur cinq cent douze à chaque token.
Ce qu'il pèse réellement en MLX
Aucune conversion ne provient de l'organisation mlx-community, qui fait habituellement référence : les versions disponibles sont l'œuvre de contributeurs individuels, ce qui impose de vérifier la provenance avant toute mise en production. Les tailles ci-dessous sont relevées sur les fichiers safetensors publiés, et non estimées.
| Conversion | Poids sur disque | Reste sur 512 Go |
|---|---|---|
| MLX 4 bits (Vontra) | 111,6 Go | 400 Go |
| MLX mixte 4 et 8 bits (pipenetwork) | 106,2 Go | 406 Go |
| MLX 6 bits avec MTP (Vontra oQ6) | 158,1 Go | 354 Go |
| MLX 3 bits avec MTP (Vontra oQ3) | 92,5 Go | 420 Go |
Le rapport entre ces tailles et le nombre de paramètres donne 0,62 octet par paramètre en 4 bits, soit sensiblement plus que les 0,5 octet d'une quantification pure, l'écart venant des échelles de quantification et des couches laissées en précision supérieure. C'est ce chiffre mesuré, et non l'arithmétique naïve, qu'il faut reprendre pour estimer le débit.
Pourquoi le contexte ne coûte presque rien ?
Seules les douze couches en attention complète accumulent un cache clé-valeur, les trente-six autres maintenant un état récurrent de taille fixe. Le calcul se pose directement : deux tenseurs, douze couches, deux têtes clé-valeur, dimension 256, soit 24 Kio par token en FP16 et 12 Kio en FP8.
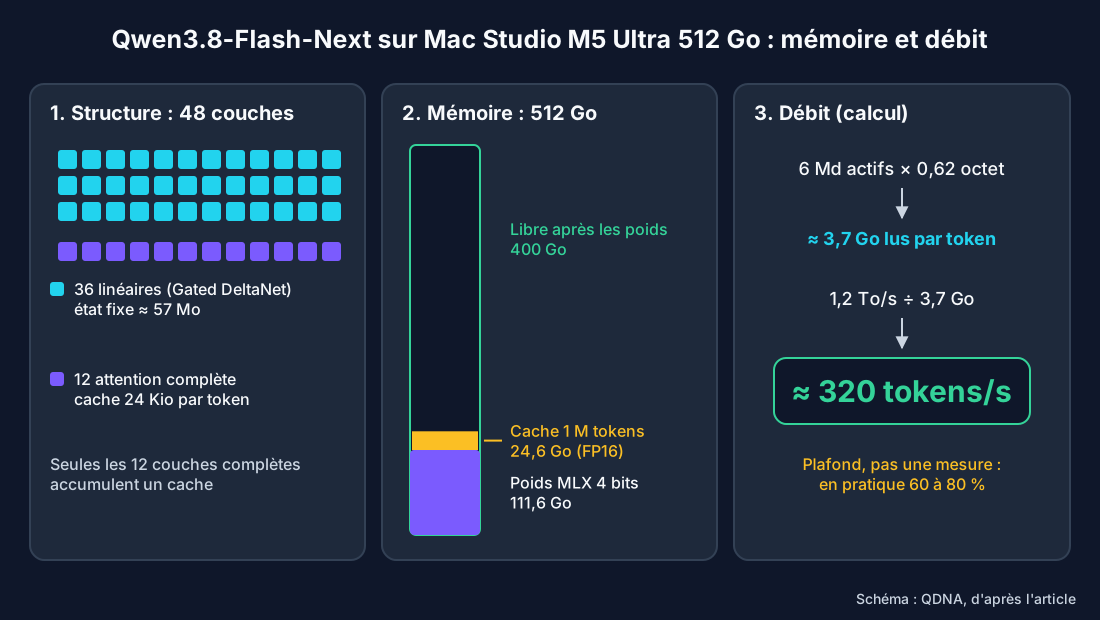
L'état des couches linéaires occupe environ 57 Mo au total, et cette valeur ne bouge pas avec la longueur du contexte, ce qui est précisément l'intérêt de l'attention linéaire. Le tableau suivant en tire les conséquences.
| Contexte | Cache FP16 | Cache FP8 |
|---|---|---|
| 262 144 tokens (natif) | 6,4 Go | 3,2 Go |
| 1 000 000 tokens (YaRN) | 24,6 Go | 12,3 Go |
Avec 400 Go libres après les poids en 4 bits, la mémoire disponible couvrirait plus de seize millions de tokens de cache en FP16. Autrement dit, ce n'est pas la machine qui borne le contexte mais le modèle lui-même, dont la fenêtre native s'arrête à 262 144 tokens et n'atteint le million qu'avec une extension YaRN.
Le débit qu'on peut attendre
La génération relit les poids actifs à chaque token : la vitesse dépend d'abord de la bande passante mémoire, qui atteint 1,2 To/s sur le M5 Ultra. Avec 6 milliards de paramètres actifs à 0,62 octet, chaque token demande de lire environ 3,7 Go, ce qui place le plafond arithmétique autour de 320 tokens par seconde.
Ce nombre est un calcul, pas une mesure, et il faut le lire comme tel. Un plafond de bande passante n'est jamais atteint en pratique, l'occupation réelle se situant plutôt entre soixante et quatre-vingts pour cent selon le moteur et la taille de lot.
La phase de préremplissage obéit par ailleurs à une autre logique, limitée par la puissance de calcul et non par la mémoire, comme le détaille notre article sur le prefill, le decode et le cache KV.
Trois réserves à connaître avant d'y aller
La configuration à 512 Go du Mac Studio M5 Ultra reste annoncée pour la fin octobre 2026, selon la page Apple France relue le 26 septembre. Les modèles à 96 et 256 Go sont livrés depuis le 22 septembre.
Aucune mesure indépendante reproductible n'est publiée à ce jour. C'est pourquoi cet article ne présente que des calculs. La machine d'entrée s'arrête à 96 Go, insuffisants pour ce modèle quelle que soit la quantification. Enfin, le sort des 51 milliards d'embeddings n-gram n'est pas documenté côté MLX.
Qwen les décrit comme propices au déchargement, ce qui laisse penser qu'ils sont consultés par lecture ponctuelle plutôt que parcourus à chaque token, mais aucune source ne le confirme pour cette pile logicielle. Si MLX les maintenait entièrement résidents et les relisait, le plafond de débit tomberait nettement.
Enfin, la licence est la qwen-community-1.0 et non une licence Apache ou MIT, ce qui impose d'en lire les conditions avant tout usage commercial. Notre comparatif des modèles à poids ouverts revient sur ce point, souvent négligé.
Questions fréquentes
Qwen3.8-Flash-Next tient-il sur un Mac Studio M5 Ultra ?
Oui, à condition de viser la configuration 512 Go. La conversion MLX 4 bits pèse 111,6 Go mesurés et laisse 400 Go libres, tandis que la version 6 bits monte à 158,1 Go. La machine d'entrée à 96 Go ne suffit pour aucune de ces conversions.
Combien de contexte peut-on servir ?
Le cache clé-valeur ne coûte que 24 Kio par token en FP16, parce que douze couches sur quarante-huit seulement utilisent l'attention complète. Un contexte natif de 262 144 tokens demande 6,4 Go, et un million de tokens en demande 24,6. La mémoire disponible couvrirait seize millions de tokens : c'est la fenêtre du modèle qui borne, pas la machine.
Quel débit espérer en génération ?
Le plafond arithmétique se situe autour de 320 tokens par seconde, obtenu en divisant les 1,2 To/s du M5 Ultra par les 3,7 Go relus à chaque token. C'est un calcul et non une mesure, et le débit réel se situe généralement entre soixante et quatre-vingts pour cent d'un tel plafond.
Les conversions MLX sont-elles fiables ?
Aucune ne provient de l'organisation mlx-community, qui sert habituellement de référence, et toutes sont l'œuvre de contributeurs individuels. Il faut donc vérifier la provenance, comparer les empreintes et valider la qualité des sorties avant d'engager une mise en production.
Références
- Qwen/Qwen3.8-Flash-Next, fiche officielle du modèle et config.json
- QwenLM/Qwen3.8-Flash-Next, dépôt de référence
- Conversion MLX 4 bits, taille des safetensors relevée
- Conversion MLX mixte 4 et 8 bits (pipenetwork), 106,2 Go relevés le 2 septembre 2026
- Conversion MLX 6 bits avec MTP (Vontra), 158,1 Go et 3 bits avec MTP (Vontra), 92,5 Go