LLM local : quel modèle d'IA open source choisir ? Comparatif 2026
GLM, DeepSeek, Kimi, Mistral, Qwen : les modèles à poids ouverts rivalisent avec les meilleures API et tournent sur votre propre matériel, et voici comment choisir selon votre usage, votre matériel et vos contraintes.
Mis à jour le 18 octobre 2026 : La ligne des modèles à poids ouverts a bougé depuis cette relecture, puisque Meta a publié Muse Spark Open le 15 octobre 2026, NVIDIA son Nemotron 3.5 Super VL le même jour, et DeepSeek sa V4.1 Flash 1017 le 17. Xiaomi, Ling et StepFun ont aussi sorti des modèles ouverts récemment.
Le classement établi ici demeure celui de la date indiquée, et les entrants mentionnés ci-dessus n’y ont pas été mesurés. La base de faits du site porte désormais leurs tarifs et leurs tailles, vérifiés au 18 octobre 2026, tandis que les fiches fournisseurs détaillent la destination des données pour qui veut arbitrer aujourd’hui.
Mis à jour le 16 octobre 2026 : indice Artificial Analysis v4.3.2 relu le 16 octobre 2026. Quatre modèles ouverts entrent au comparatif : Step 5 Preview de StepFun (44, à égalité avec Kimi K3), Ling 3.1 Flash d'InclusionAI (41), Muse Spark Open de Meta (39, publié le 15 octobre 2026) et Nemotron 3.5 Super VL de NVIDIA (26). MiMo-V2.6-Pro (46) et GLM 5.3 Flash (42) prennent leur ligne au tableau, et Nemotron 3 Ultra n'y figure plus avec un contexte d'un million de tokens, sa configuration publiée en déclarant 262 144. Trois captures du calculateur de mémoire montrent quels GPU tiennent un modèle compact et un grand modèle.
Mis à jour le 8 octobre 2026 : indice Artificial Analysis v4.3.2 relu le 8 octobre 2026 (GLM 5.3 à 44,8, Kimi K3 à 43,6, DeepSeek V4.1 Flash à 39,5, DeepSeek V4 Pro 0813 à 36,0).
Mis à jour le 26 septembre 2026 : classement Artificial Analysis relu en version 4.3.2 le 26 septembre 2026 (échelle recalibrée : GLM 5.3 à 45, Kimi K3 à 44, MiMo-V2.6-Pro en tête à 46, Claude Opus 5.5 à 58), Qwen 3.8 comme modèle mono-carte.

Pourquoi choisir un LLM open source en local ?
Un modèle à poids ouverts s'exécute sur votre matériel, sans envoyer vos données à un tiers, la qualité ayant rejoint celle des meilleures interfaces fermées, et le coût par token s'effondre une fois l'installation amortie, tandis que la licence permissive autorise l'usage commercial et l'hébergement souverain. Le cadre général figure dans notre définition de la plateforme IA souveraine.
Comparatif des LLM open source 2026
Les tailles indiquent le total des paramètres, mais les architectures à mélange d'experts n'en activent qu'une fraction par token, ce qui contient le coût de calcul à l'inférence.
| Modèle | Taille | Points forts | Pour qui |
|---|---|---|---|
| MiMo-V2.6-Pro | 1020 Md | Premier modèle ouvert sur l'indice v4.3.2 (46), texte, image, vidéo et audio, contexte 1M, licence MIT | Organisations exigeantes |
| GLM 5.3, 5.3 Flash et 5.2 | 744 et 320 Md | Qualité maximale (GLM 5.3 à 45 sur l'indice v4.3.2, deuxième modèle ouvert ; 5.3 Flash à 42 avec 18 Md actifs), raisonnement, code | Organisations exigeantes |
| Step 5 Preview | 600 Md | 44 sur l'indice v4.3.2, 27 Md actifs, texte, image et vidéo, contexte 1M | Agents multimodaux |
| Kimi K3 | 2800 Md | Niveau frontière (44), contexte 1M, vision | Agents à grande échelle |
| Ling 3.1 Flash | 560 Md | 41 sur l'indice v4.3.2, 25 Md actifs, raisonnement hybride, licence MIT | Agents de code au long cours |
| DeepSeek V4 | 1600 Md | Rapport prix-performance, Pro et Flash (V4.1 Flash à 39) | Socle polyvalent |
| Muse Spark Open | 816 Md | 39 sur l'indice v4.3.2, 42 Md actifs, licence Muse, accès validé par Meta | Usage généraliste |
| Kimi K2.7 Code | 1000 Md | Agentique, appels d’outils, MCP | Agents de développement |
| Nemotron 3 Ultra et 3.5 Super VL | 550 et 120 Md | NVFP4, écosystème NVIDIA, image et vidéo pour 3.5 Super VL | Alignés NVIDIA |
| MiniMax M3 | 428 Md | Multimodal, contexte long, économique | Documents et image |
| Mistral | Poids ouverts | Souverain FR et UE, code et raisonnement | Souveraineté européenne |
| Qwen 3.8 et Gemma 4 | 4 à 31 Md | Compact, une seule carte | TPE et périphérie |
Quel LLM open source selon l’usage ?
Pour le raisonnement et la génération de code, MiMo-V2.6-Pro (46), GLM 5.3 (45), Step 5 Preview et Kimi K3 (44) sont en tête sur l'indice Artificial Analysis v4.3.2. Suivent GLM 5.3 Flash (42), Ling 3.1 Flash (41), DeepSeek V4.1 Flash et Muse Spark Open (39), puis DeepSeek V4 Pro (36), tandis que Kimi K2.7 Code apporte la stabilité aux agents autonomes qui enchaînent des appels d'outils.
Pour le contexte long et les documents volumineux, Kimi K3, MiMo-V2.6-Pro, Step 5 Preview et MiniMax M3 offrent un million de tokens, et Kimi K3 se mesure aux API fermées puisque l'indice Artificial Analysis v4.3.2 lui donne 44 (indice v4.3.2 du 8 octobre 2026 : 43,6, derrière GLM 5.3 à 44,8), contre 58 pour Claude Opus 5.5 et 53 pour Claude Fable 5.1 comme pour GPT-6 Astra.
Ses poids sont sous licence Kimi K3. Ses 2 800 milliards de paramètres occupent environ 1,4 To à 4 bits par paramètre : ce modèle relève de la baie, pas du poste de travail. Muse Spark Open, publié par Meta le 15 octobre 2026, en relève aussi : ses 816 milliards de paramètres, dont 42 actifs, occupent environ 410 Go à 4 bits par paramètre, et ses poids ne se téléchargent qu'après validation de la demande d'accès par Meta. Pour la souveraineté européenne, Mistral reste la référence. Pour une TPE ou un usage périphérique, Qwen 3.8 et Gemma 4 tiennent sur une seule carte.
Choisir selon le matériel et les partenaires
Les grands modèles à mélange d'experts demandent un serveur GPU, par exemple un serveur RTX PRO 6000 ou une baie H200, quand les modèles compacts tournent sur un poste DGX Spark ou un Mac Studio.
Pour vérifier qu'un modèle tient sur une machine donnée, notre calculateur de mémoire VRAM additionne les poids, le cache clé-valeur et l'état des couches récurrentes, puis vérifie machine par machine la mémoire de chaque GPU, le débit par utilisateur et le délai du premier jeton. Les captures ci-dessous en sont tirées : ce sont des calculs, pas des mesures, et chaque légende renvoie au scénario dans le calculateur.
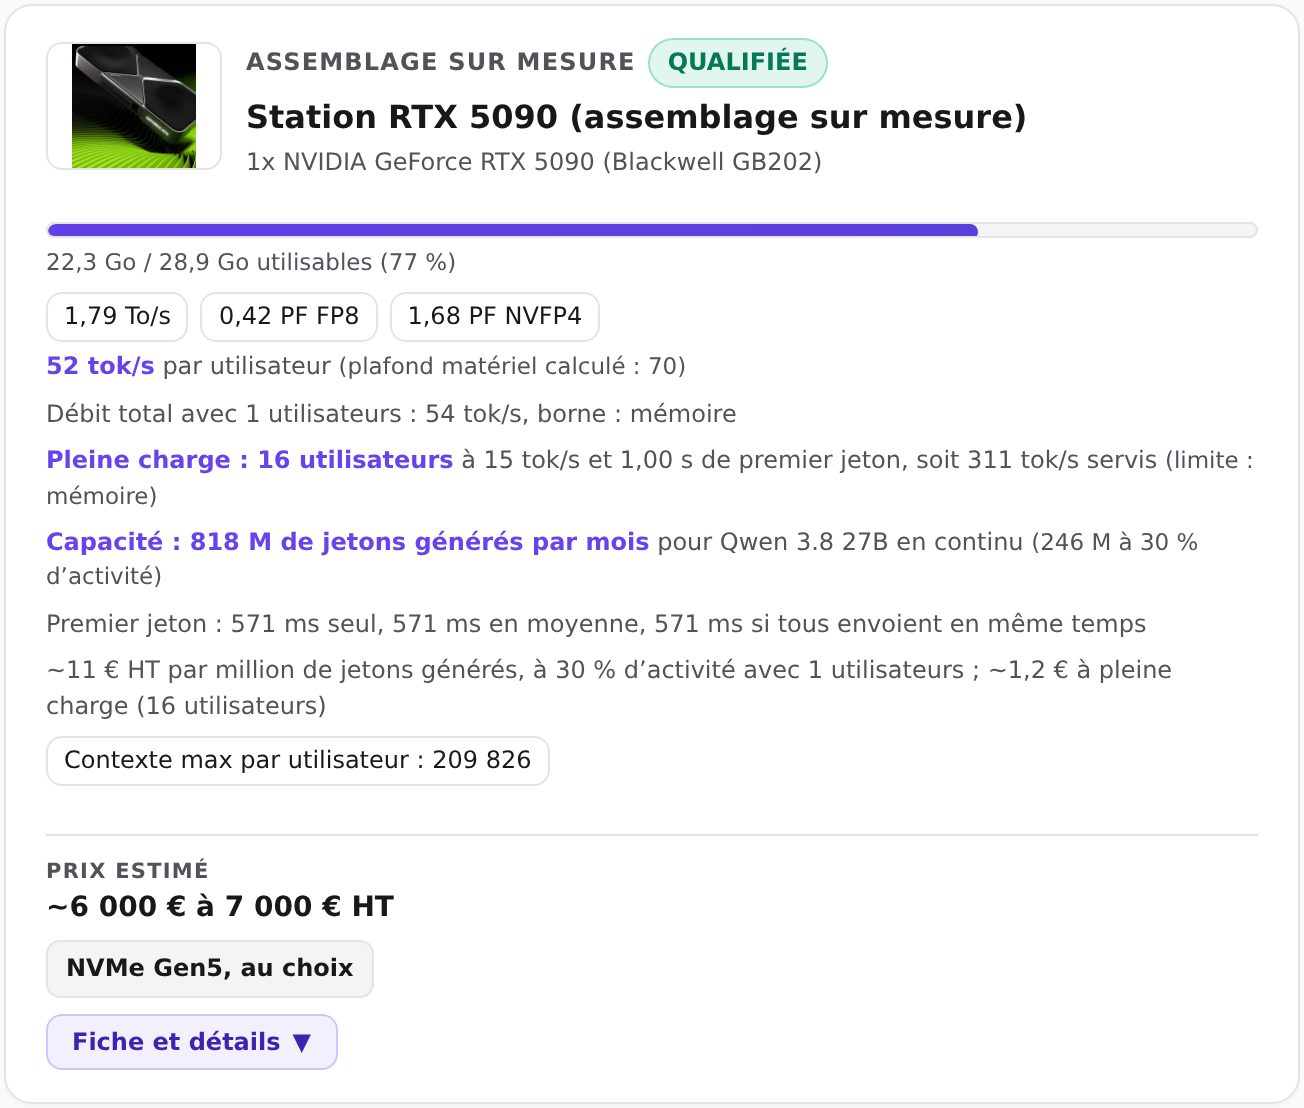
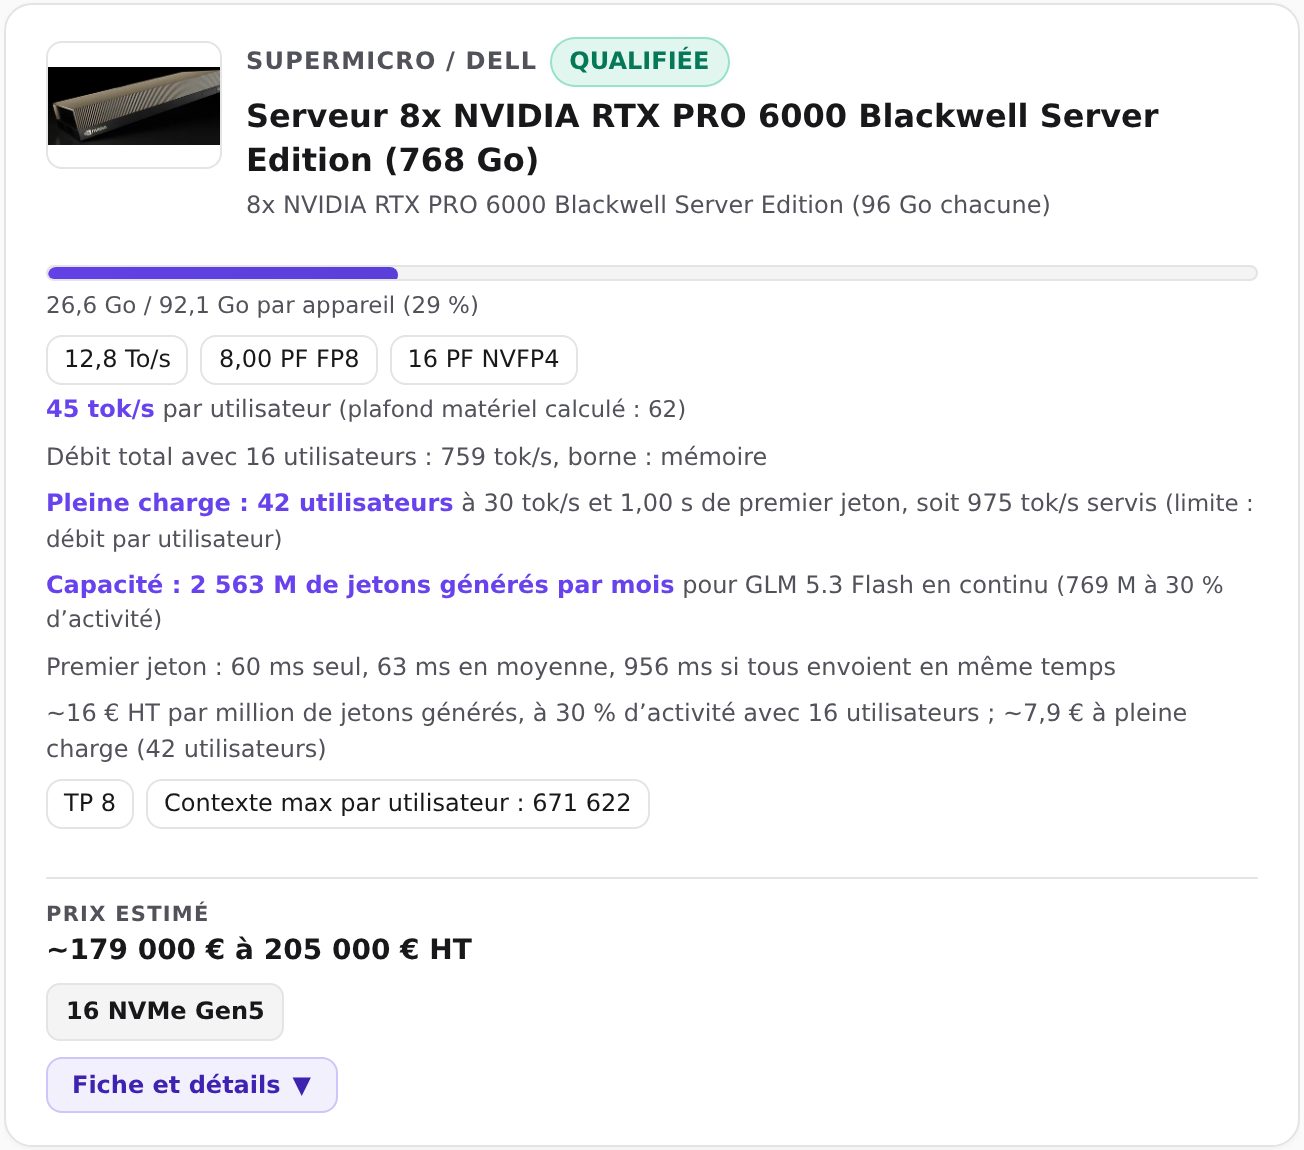
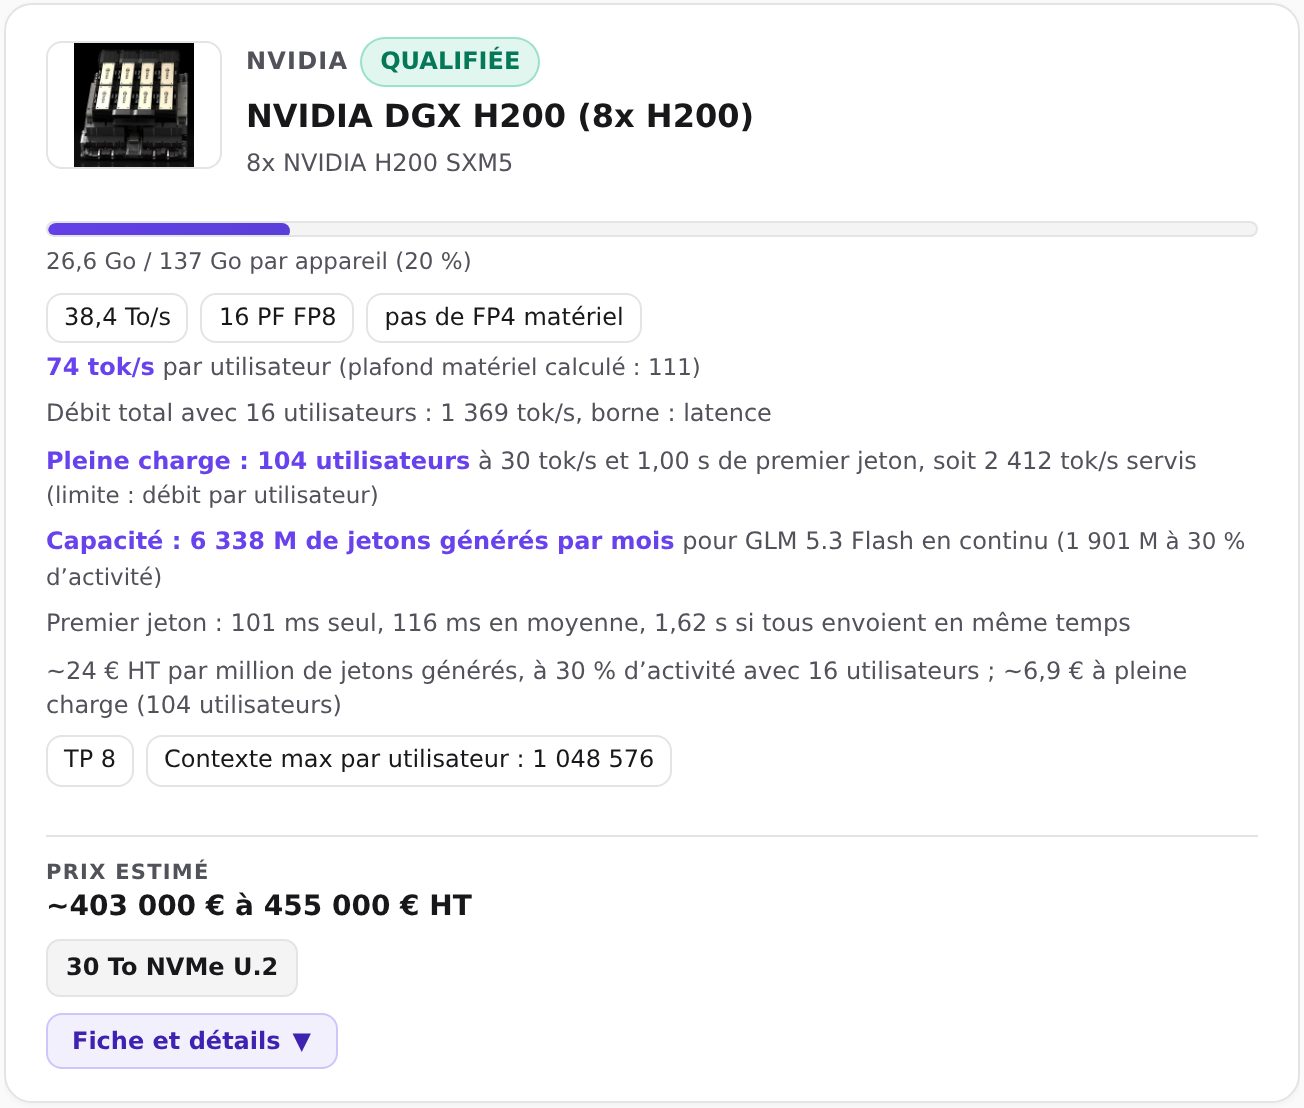
Le calcul repose sur les GPU NVIDIA, et les serveurs sont certifiés chez HPE, Dell, Supermicro, Lenovo, ASUS et Gigabyte, ce qui garantit le support et la garantie constructeur. Le détail des paliers, du poste de travail à la baie, figure dans nos fiches matériel.
Se fournir en modèles : Hugging Face, NVFP4, Unsloth
Les poids se téléchargent sur Hugging Face, point de distribution des modèles ouverts : chaque éditeur publie sous son organisation officielle, zai-org pour GLM, deepseek-ai, moonshotai pour Kimi, mistralai, Qwen, stepfun-ai, inclusionAI pour Ling, XiaomiMiMo, ou meta-models pour Muse Spark Open, dont l'accès passe par un formulaire validé par Meta. La fiche précise la licence, le format des poids, safetensors en général, et les instructions de service. L'outil huggingface-cli rapatrie les fichiers directement sur le serveur d'inférence.
Pour les GPU Blackwell, NVIDIA publie des versions déjà quantifiées au format NVFP4, un format 4 bits dont le gain se lit sur la taille des dépôts : nvidia/Qwen3.6-35B-A3B-NVFP4 pèse 23,4 Go contre 71,9 Go pour les poids BF16 d'origine, soit un facteur 3,1.
nvidia/DeepSeek-V4-Flash-NVFP4 pèse 168 Go contre 167 Go pour le point de contrôle officiel, déjà publié en FP8 et MXFP4 (tailles des safetensors relevées le 2 septembre 2026). Ces dépôts, comme nvidia/DeepSeek-V4-Pro-NVFP4, se servent tels quels avec vLLM ou TensorRT-LLM, sans étape de calibration à votre charge.
Un serveur RTX PRO 6000 ou une baie B200 exécute ce calcul FP4 en natif. Unsloth complète le circuit sur deux fronts : ses conversions GGUF à quantification dynamique règlent la compression couche par couche, ce qui préserve la qualité des modèles servis par llama.cpp sur un poste de travail.
Le projet publie aussi ses versions NVFP4, comme unsloth/Qwen3.6-27B-NVFP4, 23,4 Go contre 55,6 Go en BF16. Une carte de 24 Go n'offre qu'un contexte court. La même bibliothèque assure l'ajustement fin QLoRA sur une seule carte : le modèle se spécialise sur vos données, qui restent chez vous. Détails dans notre fiche Unsloth.


Licence et souveraineté
Poids ouverts ne signifie pas toujours open source au sens strict. Vérifiez la licence, souvent MIT, Apache ou permissive, avant un usage commercial, sachant que l'exécution en local garantit que les données ne quittent pas l'entreprise, ce qui facilite la conformité au RGPD et l'hébergement de données de santé HDS. Les conditions varient d'un modèle à l'autre : Ling 3.1 Flash et MiMo-V2.6-Pro sont sous licence MIT, quand Muse Spark Open impose la mention « Built with Muse Spark Open » et un accord séparé avec Meta pour un service de modèles au-delà de 20 millions de dollars de revenu sur douze mois, un seuil que l'on retrouve dans la licence de Kimi K3.
Comment LiteLLM rend les modèles interchangeables via une passerelle ?
Ces modèles s'unifient derrière une seule interface avec LiteLLM. Changer de modèle tient en une ligne de configuration, sans réécrire le code applicatif. La suite pratique se trouve dans notre guide pour installer un LLM local en entreprise.
Questions fréquentes
Quel est le meilleur LLM open source en 2026 ?
MiMo-V2.6-Pro (46) et GLM 5.3 (45) mènent les modèles ouverts sur l'indice Artificial Analysis (version 4.3.2 consultée le 16 octobre 2026), devant Step 5 Preview et Kimi K3 (44), contre 58 pour Claude Opus 5.5 ; les poids de Kimi K3 sont publiés sur Hugging Face depuis le 16 juillet 2026. Pour un meilleur rapport coût-performance, DeepSeek V4 offre un niveau frontière à coût réduit.
Un modèle d'IA open source peut-il tourner en local ?
Oui. Servi par vLLM sur serveur GPU ou par llama.cpp quantifié sur un poste, un modèle à poids ouverts s'exécute entièrement sur votre infrastructure, sans dépendance externe.
Quel modèle open source pour coder en local ?
Kimi K2.7 Code pour la stabilité agentique et les appels d'outils, GLM 5.3 ou DeepSeek V4 pour la qualité de génération. Codestral de Mistral est l'option souveraine européenne.
Sur quel matériel faire tourner un LLM open source ?
Un poste DGX Spark ou Mac Studio pour les modèles compacts, un serveur RTX PRO 6000 ou une baie H200 pour les grands modèles. Les serveurs sont certifiés chez HPE, Dell, Supermicro et Lenovo sur base GPU NVIDIA.
Où télécharger un LLM open source ?
Sur Hugging Face, depuis l'organisation officielle de l'éditeur. Les versions NVFP4 publiées par NVIDIA et les GGUF d'Unsloth y sont prêtes à servir : la première pour un serveur Blackwell sous vLLM, la seconde pour un poste sous llama.cpp.
Un LLM open source vaut-il une API fermée comme ChatGPT ?
Sur la qualité, les meilleurs modèles ouverts rejoignent les API fermées en raisonnement et en code. La différence tient au contrôle : en local, les données restent chez vous et le coût par token s'effondre une fois le matériel amorti, là où une API facture chaque appel et traite vos données à l'extérieur. Le calcul détaillé figure dans notre comparaison sur site ou API.
Références
- Artificial Analysis, classement des modèles, indice d'intelligence v4.3.2 (consulté le 16 octobre 2026)
- Artificial Analysis, modèles à poids ouverts, indice v4.3.2 (consulté le 16 octobre 2026)
- Xiaomi, fiche de MiMo-V2.6-Pro : 1,02 billion de paramètres, 42 milliards actifs, licence MIT
- StepFun, fiche de Step 5 Preview : 600 milliards de paramètres, 27 milliards actifs, licence StepFun
- InclusionAI, fiche de Ling 3.1 Flash : 560 milliards de paramètres, 25 milliards actifs, licence MIT
- Meta, fiche de Muse Spark Open et licence Muse, accès sur demande
- NVIDIA, fiche de Nemotron 3.5 Super VL : 120 milliards de paramètres, 12 milliards actifs, licence OpenMDW
- Open LLM Leaderboard, Hugging Face
- Checkpoints NVFP4 officiels, organisation NVIDIA sur Hugging Face
- Documentation Unsloth, quantification dynamique et ajustement fin
- moonshotai/Kimi-K3, fiche du modèle : licence, poids MXFP4 et taille des fichiers