Quel serveur pour l'IA ? Guide et prix par gamme (2026)
Le prix d'un serveur pour l'IA dépend de la gamme, du nombre de cartes et de la mémoire, et en 2026 la pénurie de mémoire tire l'ensemble vers le haut. Voici des fourchettes indicatives par segment.
Mis à jour le 18 octobre 2026 : La ligne frontière des interfaces payantes a changé depuis cette relecture, OpenAI ayant porté la gamme GPT-6 au premier plan, Anthropic publié Opus 5.5 puis Sonnet 5.5, Google son Gemini 4 Argon et Meta ses modèles Muse. Les seuils de bascule calculés ici reposent toutefois sur la grille DeepSeek, demeurée inchangée.
Un point mérite attention pour toute projection au-delà de novembre, car Gemini 4 Argon est facturé 2 et 10 dollars par million jusqu’au 30 novembre 2026, puis le double à compter du 1er décembre. Une comparaison de coûts établie aujourd’hui ne vaudra donc plus pour l’an prochain sur ce modèle précis.
Mis à jour le 8 octobre 2026 : prix de référence portés à 7 000 € HT pour le DGX Spark et à 150 000 € HT pour la DGX Station ; coûts journaliers, mensuels et par million de tokens recalculés.
Mis à jour le 2 octobre 2026 : fourchettes et coûts réalignés sur leurs sources (DGX Station de 88 000 à 110 500 € HT selon le relevé pi3g du 14 septembre, électricité à 0,1624 €/kWh HT), références dédoublonnées.
Mis à jour le 26 septembre 2026 : prix du DGX Spark relevé chez un revendeur professionnel français (LDLC.pro, 5 083 € HT) au lieu du comparateur idealo, fourchette DGX Station de pi3g du 14 septembre, taux BCE du 25 septembre, grilles Anthropic (Opus 5.5), OpenAI (GPT-6 Astra et Sol) et DeepSeek (V4.1 Flash, V4 Flash 0731 retiré de l'API le 10 septembre) du 26 septembre 2026 ; coûts par million recalculés.

Qu’est-ce qui fixe le prix d’un serveur IA ?
Trois facteurs dominent : le nombre et le type de cartes graphiques, la quantité de mémoire, et le format du serveur, la mémoire pesant plus que jamais dans le total. Le calcul complet, matériel contre paiement au token, figure dans notre article coût sur site contre API.
La mémoire sera-t-elle le moteur des prix en 2026 ?
Les fabricants ont réorienté leur capacité vers la mémoire à haute bande passante destinée aux accélérateurs d'IA, qui rapporte davantage par plaque que la mémoire classique. Il en résulte une rareté de la mémoire vive ordinaire.
Sur un an, les prix de la mémoire serveur ont fortement augmenté, et Dell a annoncé à ses clients des hausses d'au moins 15 à 20 % dès la mi-décembre 2025, Lenovo faisant expirer toutes ses offres de prix au 1er janvier 2026 (TrendForce, 5 décembre 2025).
Un poste comme le DGX Spark a vu son prix passer d'environ quatre mille à près de quatre mille sept cents dollars, uniquement en raison du coût de la mémoire. La détente n'est pas attendue avant plusieurs années.
Quelles sont les fourchettes de prix par gamme ?
Les fourchettes de prix par gamme ci-dessous situent les ordres de grandeur en 2026, taxes et intégration en sus, et ils sont larges à dessein, car la configuration et la mémoire font varier le total du simple au double.
| Gamme | Pour qui | Fourchette indicative |
|---|---|---|
| Poste DGX Spark (128 Go) | TPE, poste souverain | 7 000 € HT, prix retenu en octobre 2026 après la hausse constatée (relevé LDLC.pro du 26 septembre 2026 : 5 083 € HT, PNY DGX Spark, livraison sous 15 jours), soit 8 400 € TTC ; 5 290 € HT chez Nelpx, en stock ; NVIDIA affiche 4 699 $ et une rupture sur sa boutique américaine |
| Mac Studio M5 Ultra (96 Go de base, jusqu'à 512 Go à 1,2 To/s) | TPE, option silencieuse | à partir de 6 599 € TTC pour la M5 Ultra 96 Go (Apple Store France, relevé du 26 septembre 2026, livrée depuis le 22 septembre) ; l'option 512 Go, toujours annoncée pour fin octobre, n'a pas de prix publié |
| Workstation DGX Station (GB300) | PME sans salle serveur | 150 000 € HT, soit 180 000 € TTC, valeur retenue depuis octobre 2026 dans tous les calculs du site ; relevés antérieurs : de 88 000 à 110 500 € HT selon l'OEM, soit 105 600 à 132 600 € TTC (pi3g, page du 14 septembre 2026 ; Dell à 173 000 € HT hors fourchette), dont 95 000 € HT pour la configuration Exxact Valence ; 99 999 $ HT chez SHI et 98 000 £ HT chez Scan UK pour l'ASUS ET900N G3 |
| Serveur RTX PRO 6000 (2 à 8 GPU) | PME, cheval de bataille | sur devis : aucun constructeur ne publie de prix pour un châssis à 8 cartes ; repère, carte seule 16 000 $ HT sur la place de marché NVIDIA au 1er septembre 2026 (relevé thundercompute, source secondaire) ; 17 709,95 € TTC, soit 14 758 € HT, en édition Max-Q chez LDLC le 26 septembre 2026 |
| Serveur H200 (8 GPU SXM) | Grande entreprise | environ 451 000 € HT : 387 785 £ HT chez CTO Servers (8 GPU H200 141 Go, deux Xeon Gold 6538Y+), relevé du 2 septembre 2026 au taux BCE du 25 septembre 2026, 1 € = 0,860 £ ; un seul vendeur, devis à confirmer |
| Baie GB300 NVL72 | Cloud IA souverain | sur devis ; estimations d'analystes de 3,7 à 6,5 M$ (Loop Capital, Tom's Hardware, rapportées le 16 août 2026), qui ne sont pas des prix |
Ces prix sont indicatifs et non contractuels, estimés pour 2026 hors remises, hébergement et intégration, un chiffrage précis dépendant de la configuration retenue.
Appliance clé en main ou matériel identifiable ?
À côté du matériel de référence listé plus haut se tient une seconde catégorie, l'appliance d'IA privée vendue comme une boîte scellée avec sa pile logicielle. Ces fournisseurs ne publient pas de tarif : Zanus AI, l'un des noms connus du segment, affiche trois gammes sur son propre site avec un bouton de demande de devis à la place du prix.
Des sites d'estimation tiers comblent le vide, et leurs chiffres pour une même gamme varient de près du simple au triple, ce qui indique assez ce qu'ils valent. Les fourchettes de cette page suivent la démarche inverse : adossées à du matériel identifiable, elles se vérifient ligne à ligne face à un devis, tant de cartes, tant de mémoire, ce châssis.
Un prix d'appliance qui ne se décompose pas ne se compare pas, et c'est la seule raison pour laquelle nous publions des fourchettes larges plutôt qu'un chiffre unique rassurant.
Les constructeurs de référence
Les constructeurs de référence sont NVIDIA pour les cartes graphiques et HPE, Dell, Supermicro, Lenovo, ASUS et Gigabyte pour les serveurs certifiés, qui apportent le support et la garantie constructeur attendus en entreprise. QDNA n'en revend aucun.
Dell et Lenovo ont d'ailleurs relevé leurs tarifs serveurs dès le début de la pénurie. QDNA vous conseille dans le choix de ce matériel, du poste de travail à la baie, et les paliers détaillés figurent dans nos fiches matériel.
Faut-il acheter, colocaliser ou louer un serveur IA ?
Trois voies coexistent : l'achat immobilise un capital mais amortit le coût sur plusieurs années, avec un coût par token proche de zéro, quand la colocation infogérée dans un data center souverain français évite l'achat d'un local en gardant la maîtrise juridique.
La location de capacité convient aux pics ou à une validation, avant un investissement. Le point de bascule des coûts est détaillé dans l'article coût sur site contre API, avec ses hypothèses datées.
L'IA se déplace-t-elle vraiment vers le local ?
Le marché déplace bien l'IA vers le local. Une enquête publiée par Cloudian en mars 2026 auprès de 203 décideurs informatiques établit que 93 % des entreprises rapatrient déjà des charges d'IA hors du cloud public, sont en train de le faire ou l'évaluent activement, et que 79 % en ont déjà déplacé.
La même année, l'observatoire Private Cloud de Broadcom, enquête auprès de 1 800 responsables informatiques dans huit pays, relève que 83 % des responsables envisagent un rapatriement, contre 69 % un an plus tôt. La question du prix sur site prend un sens concret à mesure que ces charges reviennent. Les motifs se recoupent d'une étude à l'autre.
L'enquête Cloudera menée en 2024 auprès de six cents responsables informatiques place la sécurité et la conformité en tête des freins (74 %), devant le manque de compétences pour gérer les outils (38 %) et leur coût (26 %). Le contrôle des données propres, la prévisibilité de la facture et la souveraineté juridique reviennent comme les trois moteurs de ce mouvement.
Sur la durée, l'arbitrage financier suit la même pente. Pour une charge soutenue, un serveur acheté et amorti garde un coût par token bien inférieur à une facturation à l'usage, et le coût total de possession sur trois ans peut passer sous une facturation cloud équivalente, ce que le calcul ci-dessous permet de vérifier plutôt que de supposer.
Ce constat ne condamne pas l'hébergement, qui reste pertinent pour les pics et les phases de validation, dans une approche hybride. Il éclaire pourquoi le prix d'un serveur, rapporté à l'usage réel, se lit comme un investissement et non comme une dépense.
Bien dimensionner avant d'acheter
La taille du modèle et le nombre d'utilisateurs fixent la gamme, puisqu'un modèle compact tient sur un poste quand un grand modèle demande un serveur. Le guide pratique se trouve dans installer un LLM local. Dans un marché de mémoire tendu, un dimensionnement juste évite de surpayer une configuration surdimensionnée.
Comment comparer le coût réel au token ?
Le prix d'achat ne dit pas tout. Ce qui compte est le coût par token, qui dépend du débit du matériel sur un modèle donné. Le comparateur ouvert InferenceX de SemiAnalysis publie des mesures reproductibles et auditables : latence, débit en tokens par seconde et coût implicite par token.
Il oppose les accélérateurs par paires, du H100 et du H200 aux Blackwell B200, B300, GB200 NVL72 et GB300 NVL72 et à la RTX PRO 6000, face aux cartes AMD MI300X, MI325X et MI355X, sur une même charge et une même cible d'interactivité.
Les mesures couvrent une dizaine de modèles ouverts représentatifs, dont DeepSeek V4 Pro, Kimi K3 et K2.7, GLM 5.3, MiniMax M3, Qwen 3.8 Flash Next, gpt-oss et Llama (liste relue le 2 septembre 2026).
La lecture utile pour un acheteur tient en une règle que la fiche technique ne montre jamais seule : le coût au token dépend du débit obtenu sur le modèle visé, si bien que le matériel se choisit d'après la charge réelle plutôt que d'après le prix affiché.
Un accélérateur plus cher qui délivre davantage de tokens par seconde revient fréquemment moins cher au token, dès lors que la comparaison par paires vérifie cette économie carte contre carte, sur le modèle précis que l'organisation compte servir en production.
Coût au million de tokens : ce qui se calcule et ce qui reste à mesurer
Le coût au token dépend du modèle servi et du débit obtenu, et il ne se devine pas : il se calcule à partir de quatre hypothèses nommées, prix du matériel hors taxes amorti sur 1 095 jours, puissance électrique, tarif du kilowattheure et débit agrégé publié par un tiers pour le modèle visé.
Le tableau ne retient donc que les machines pour lesquelles un tel débit existe pour DeepSeek V4 Flash, et le calcul complet, formule, hypothèses, sources et détail numérique, figure dans notre comparatif DeepSeek V4 Flash 0731 face aux API.
| Solution | Coût journalier | Débit agrégé (source tierce) | 10 % de charge | 30 % de charge | 60 % de charge |
|---|---|---|---|---|---|
| Poste DGX Spark | 7,33 € (7 000 € HT sur 3 ans, 240 W, 0,1624 €/kWh) | 30 tokens/s, DeepSeek V4 Flash en GGUF 2 bits, forum NVIDIA, 15 juillet 2026 | 28,3 €/1M | 9,42 €/1M | 4,71 €/1M |
| Cluster 2× DGX Spark | 14,66 € (14 000 € HT, 480 W) | 210,8 tokens/s, DeepSeek V4 Flash 0731 FP8, vLLM en parallélisme tensoriel 2, Classmethod, 10 août 2026 | 8,05 €/1M | 2,68 €/1M | 1,34 €/1M |
| Workstation DGX Station | 143,22 € (150 000 € HT, 1 600 W) | [À MESURER] : 159 tokens/s d'une capture client sans conditions (pi3g, 4 juillet 2026) | 104,3 €/1M | 34,8 €/1M | 17,4 €/1M |
| Serveur RTX PRO 6000, serveur H200, baie GB300 NVL72 | prix ci-dessus (H200 environ 451 000 € HT ; les deux autres sur devis) | [À MESURER] : pas de débit publié pour ce modèle avec ses conditions | non calculé | non calculé | non calculé |
Détail de la première ligne : 7 000 / 1 095 = 6,39 € d'amortissement par jour, plus 0,24 kW × 24 h × 0,1624 €/kWh = 0,94 € d'électricité, soit 7,33 € par jour ; à 30 tokens/s et 30 % de charge, cela fait 30 × 86 400 × 0,30 = 777 600 tokens par jour, d'où 7,33 / 0,778 = 9,42 € par million.
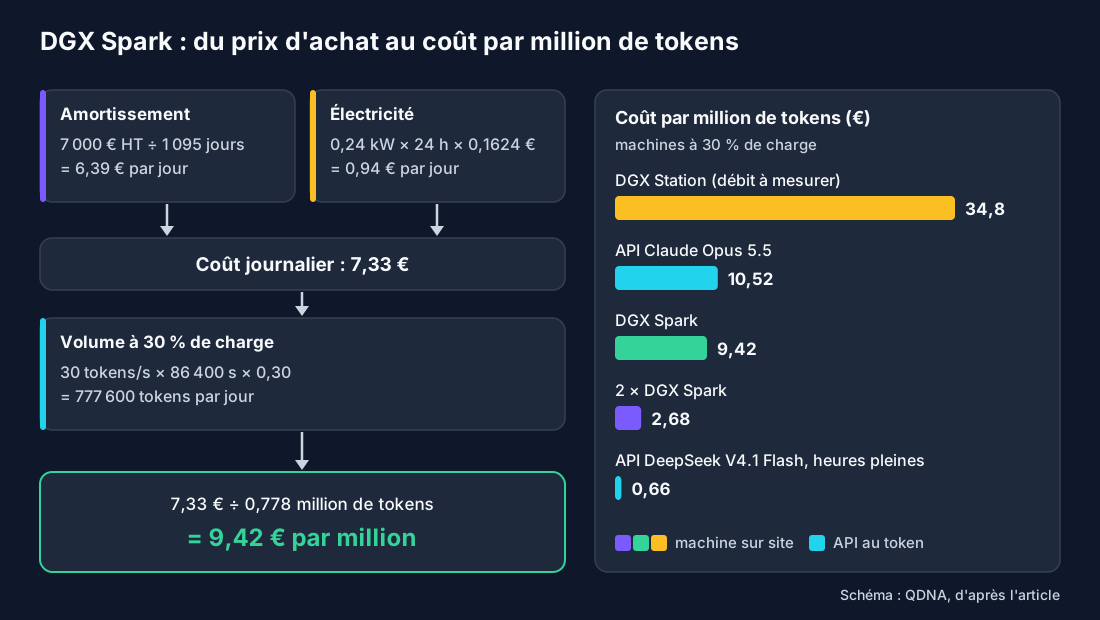
La grille DeepSeek facturait ce même modèle 0,44 à 0,88 $ par million avant de le retirer de son API le 10 septembre 2026, et facture son successeur V4.1 Flash 1017 0,375 à 0,75 $ par million (grille relue le 18 octobre 2026) ; Claude Opus 5.5 coûte 12 $ par million.
Un poste local passe donc sous les API fermées dès quelques centaines de milliers de tokens par jour, mais ne passe plus sous la grille de l'éditeur, même en cluster chargé à 100 % (0,80 € par million contre 0,66 € en heures pleines). Le débit par carte se vérifie sur le comparateur InferenceX de SemiAnalysis.
Simuler le TCO : à partir de quel volume un serveur local devient-il rentable ?
Simuler le TCO d'un serveur d'IA permet d'identifier précisément le seuil d'amortissement à partir duquel l'infrastructure locale devient plus rentable que la consommation d'API cloud. Ce point de bascule dépend du nombre d'utilisateurs actifs au quotidien et de la typologie des requêtes générées.
Estimation rapide du seuil d'amortissement (DGX Spark vs API Cloud)
Questions fréquentes
Combien coûte un serveur IA en 2026 ?
D'un poste à quelques milliers d'euros à une baie à plusieurs millions, selon la gamme. Un serveur de PME avec plusieurs cartes se situe entre plusieurs dizaines et plusieurs centaines de milliers d’euros selon la mémoire. Les montants sont indicatifs et tirés vers le haut par la mémoire.
Pourquoi les serveurs IA sont-ils si chers en 2026 ?
Les fabricants ont réorienté la capacité vers la mémoire à haute bande passante pour l'IA, ce qui raréfie la mémoire classique. Les prix de la mémoire serveur ont fortement augmenté et plusieurs constructeurs ont relevé leurs tarifs.
Quel serveur IA pour une PME ?
Un serveur équipé de cartes RTX PRO 6000, de deux à huit selon le besoin, couvre la plupart des usages d'une PME. Aucun constructeur ne publie de prix pour un châssis à huit cartes : il se chiffre sur devis, la carte seule étant relevée à 16 000 $ HT sur la place de marché NVIDIA au 1er septembre 2026.
Faut-il acheter ou louer un serveur IA ?
L'achat amortit le coût sur plusieurs années avec un coût par token faible. La location convient aux pics et aux validations. La colocation souveraine évite l'achat d'un local tout en gardant la maîtrise juridique.
Quel est le coût total de possession d'un serveur IA ?
Le prix d'achat ne représente qu'une part du coût. Il faut y ajouter l'électricité, qui dépend de la consommation des cartes et du refroidissement, l'amortissement sur trois à cinq ans, la maintenance et l'hébergement. Sur la durée, un serveur amorti garde un coût par token bien inférieur à celui d'une API facturée à l'usage.
Le marché rapatrie-t-il l'IA hors du cloud ?
La tendance est mesurée. Une enquête Cloudian de 2026 relève que 93 % des entreprises rapatrient des charges d'IA hors du cloud public ou l'évaluent, et l'observatoire Private Cloud de Broadcom passe de 69 à 83 % en un an. Le contrôle des données, la prévisibilité des coûts et la souveraineté motivent ce mouvement, sans exclure une part d'hébergement pour les pics.
À partir de quel volume un serveur local est-il plus rentable que les API ?
Dès environ 50 à 100 utilisateurs actifs (ou 50 millions de tokens par mois), un serveur local amorti sur 3 ans (environ 223 € HT/mois pour un DGX Spark avec électricité) coûte moins cher que les factures cumulées d'API payées au token.
Références
- DGX Spark, édition PNY, chez LDLC.pro (relevé du 26 septembre 2026)
- DGX Spark price increase, Tom's Hardware
- RTX PRO 6000 pricing, Tom's Hardware
- HBM3E price hike 2026, TrendForce
- Comparateur d'inférence InferenceX, SemiAnalysis
- Décomposition du coût d'un serveur IA, SemiAnalysis
- Enterprise AI Infrastructure Survey 2026, Cloudian
- Private Cloud Outlook 2026, Broadcom
- State of Enterprise AI 2024, Cloudera
- Hausses Dell de 15 à 20 % et expiration des devis Lenovo, TrendForce (5 décembre 2025)
- DGX Station GB300, prix par OEM hors TVA, pi3g (page du 14 septembre 2026)
- Mac Studio M5 Ultra, Apple Store France (relevé du 26 septembre 2026)
- Fiche technique DGX Spark, alimentation 240 W, NVIDIA
- Fiche technique DGX Station, 1 600 W, NVIDIA
- Délibération CRE n° 2026-147 du 15 juillet 2026, tarifs réglementés au 1er août 2026
- Débit de DeepSeek V4 Flash sur un DGX Spark, forum NVIDIA (15 juillet 2026)
- Débit de DeepSeek V4 Flash 0731 sur deux DGX Spark, Classmethod (10 août 2026)