Scénario chiffré : DeepSeek V4 sur DGX Station pour une PME de 80 personnes
Ce que coûterait et rendrait DeepSeek V4 Flash 0731 sur DGX Station GB300 pour une PME de 80 personnes : un scénario de dimensionnement construit sur des hypothèses explicites, pas le retour d'un client. Débits estimés, coût total de possession sur 3 ans et seuil de rentabilité face aux API.
Mis à jour le 8 octobre 2026 : prix de référence portés à 150 000 € HT pour la DGX Station et à 7 000 € HT pour le DGX Spark ; le coût total de possession, le coût journalier, le coût par million de tokens, les seuils de rentabilité et le coût du cluster 2× DGX Spark sont recalculés. Correction du même jour : l'écart avec la facture cloud soustrayait 23 300 €, montant que l'article ne dérivait pas ; il repose désormais sur la facture recalculée, 150 M tokens × 10,52 €/M × 12 = 18 936 € par an, soit 56 340 € de plus par an pour le local (51 606 € avec 25 % de croissance), et cette croissance donne ~23 700 €/an.
Mis à jour le 26 septembre 2026 : tarifs API réalignés sur les grilles du 26 septembre 2026 (Claude Opus 5.5 à 4 et 20 $, GPT-6 Astra et Sol, DeepSeek V4.1 Flash qui remplace V4 Flash 0731 dans l'API depuis le 10 septembre), taux BCE du 25 septembre, prix du DGX Spark relevé chez LDLC.pro, page pi3g du 14 septembre ; la facture cloud de référence et les seuils de rentabilité sont recalculés.
Mis à jour le 2 septembre 2026 : cet article, publié comme « étude de cas », est requalifié en scénario chiffré. Aucun client ne se cache derrière : la PME, ses volumes et son ancien fournisseur sont des hypothèses de travail. Les débits qui ne viennent pas de notre section mesures sont marqués « estimé, à mesurer » ; le tarif de l'API DeepSeek et la formule du seuil de rentabilité sont mis à jour. Relecture du même jour : la facture cloud supposée (8 000 €/mois) est recalculée au tarif Anthropic (1 950 €/mois), ce qui inverse la conclusion économique ; le tarif GPT-5.5 est repris de la grille OpenAI ; les débits, latences et nombres d'utilisateurs « estimés » sans formule sont remplacés par « à mesurer » ; le coût par million est donné par sa formule. Harmonisation du même jour : le prix de la DGX Station (95 000 € HT chez pi3g, page du 14 septembre 2026) et le tarif de l'électricité (0,1624 €/kWh HT, Tarif Bleu professionnel) sont alignés sur les hypothèses communes du site, à la place des 120 000 € et des 30 centimes par kWh posés comme hypothèses prudentes ; le TCO et les seuils sont recalculés.
Quelles hypothèses sous-tendent le scénario ?
On suppose une PME éditrice de logiciels de logistique, 80 collaborateurs en France sur deux sites. Son service client traite ~500 tickets par jour via une interface de chat interne, et sa documentation technique compte ~50 000 pages (manuels produits, procédures internes, base de connaissances).
On suppose un usage antérieur de Claude Opus 4.5 via l'API Anthropic pour ~150 M tokens/mois (chat + RAG), facturé ~1 580 €/mois (~18 900 €/an) au tarif Anthropic de Claude Opus 5.5 du 26 septembre 2026, 4 $ en entrée et 20 $ en sortie par million mixés 50/50, soit 10,52 €/M.
C'est une hypothèse de travail, pas une facture, et la version du 2 août supposait 8 000 €/mois, montant qu'aucune grille ne justifie. Une croissance de 25 % porterait ce coût à ~23 700 €/an (18 936 € × 1,25 = 23 670 €), sans compter les limites de débit en période de pointe.
Le scénario retient un modèle ouvert sur du matériel dédié pour trois raisons : réduire le coût par token, éliminer le rate-limit éditeur, et garder les données sur site (RGPD by design, pas de transfert vers un sous-traitant hors Union).
La configuration déployée
La configuration déployée dans ce scénario associe une DGX Station GB300 à DeepSeek V4 Flash 0731 quantifié, servi par vLLM derrière la passerelle LiteLLM, chaque choix étant justifié dans le tableau.
| Composant | Choix retenu | Justification |
|---|---|---|
| Matériel | DGX Station GB300 (252 Go HBM3e + 496 Go LPDDR5X, pool cohérent 748 Go via NVLink-C2C) | Permet le 1M contexte natif et la performance pour 50-80 tok/s en UD-IQ3_XXS |
| Modèle | DeepSeek V4 Flash 0731 en UD-IQ3_XXS (104 Go) | Recommandation Unsloth pour les machines de 128 Go ; seule UD-Q8_K_XL (162 Go) est annoncée sans perte par Unsloth, UD-IQ3_XXS n'a pas de mesure de qualité publiée ; sur 748 Go, le checkpoint officiel de 167 Go tiendrait sans quantification |
| Runtime | vLLM 0.25+ sur container NGC aarch64 | Support officiel de DSpark et de V4 Flash 0731, pas de build manuel requis |
| Orchestration | LiteLLM comme passerelle unique, routeur sémantique QDNA | Clés virtuelles par utilisateur, quotas par équipe, journalisation interne |
| RAG | LlamaIndex + Qdrant (vector DB) sur les 50 000 pages de documentation | Recherche hybride (vectorielle + lexicale) pour une couverture optimale |
| Frontend | Interface de chat interne (React) via l'API compatible OpenAI de vLLM | Pas de changement d'habitude pour les utilisateurs |
Quels sont les débits et latences estimés, à mesurer ?
Aucun couple DeepSeek V4 Flash 0731 / DGX Station GB300 ne figure dans notre section mesures : les valeurs ci-dessous sont des estimations déduites de la bande passante mémoire et du dimensionnement du cache KV, à confirmer par une mesure reproductible. Les nombres d'utilisateurs simultanés sont des calculs de mémoire, pas des observations.
| Métrique | Valeur estimée [À MESURER] | Hypothèses |
|---|---|---|
| Décode single-user (UD-IQ3_XXS) | [À MESURER] | Plafond calculé, jamais atteint : bande passante / octets relus par token = 7,1 To/s / (13 milliards de paramètres actifs × 0,37 octet en UD-IQ3_XXS, soit 4,8 Go) ≈ 1 500 tokens/s à un flux ; la version du 2 août publiait 68 tok/s sans formule |
| Décode charge modérée (10 utilisateurs) | [À MESURER] | Seul repère publié : 160 à 190 tok/s agrégés à six flux sur un cluster 2× DGX Spark (MiaAI-Lab, 14 août 2026), machine différente |
| Préremplissage 1M contexte | [À MESURER] | La version du 2 août publiait 2,6 s en FP8 et 10,4 s en BF16 sans formule |
| Utilisateurs concurrents ctx 8K | à calculer | = mémoire laissée au cache KV / (octets par token × 8 192) ; les octets par token de l'attention compressée de V4 ne sont pas publiés par DeepSeek, et les « 43 Ko/token » de la version du 2 août n'avaient pas de source |
| Utilisateurs concurrents ctx 1M | 14 | UD-IQ3_XXS, contexte 1M tokens par utilisateur, KV cache FP8 |
| Latences P50 et P99 | [À MESURER] | La version du 2 août publiait 30 et 150 ms sans mesure |
Coût total de possession (TCO) sur 3 ans
Le coût total de possession sur trois ans additionne l'acquisition de la station, l'intégration, l'électricité au Tarif Bleu, la maintenance et la formation, soit 225 828 € détaillés année par année.
| Poste | Coût année 1 | Coût année 2 | Coût année 3 | Total 3 ans |
|---|---|---|---|---|
| DGX Station GB300 (acquisition au prix retenu en octobre 2026, hors TVA ; relevé précédent chez pi3g le 14 septembre 2026 : 95 000 € HT, de 88 000 à 110 500 € HT selon l'OEM) | 150 000 € | 0 € | 0 € | 150 000 € |
| Intégration (installation, configuration, tests) | 15 000 € | 5 000 € | 5 000 € | 25 000 € |
| Électricité (1 600 W, puissance nominale de la fiche NVIDIA en hypothèse haute, × 24 h × 365 j = 14 016 kWh × 0,1624 €/kWh HT, Tarif Bleu professionnel EDF option Base, grille du 1er août 2026) | 2 276 € | 2 276 € | 2 276 € | 6 828 € |
| Maintenance (support NVIDIA, mises à jour, pièces détachées) | 8 000 € | 8 000 € | 8 000 € | 24 000 € |
| Formation (équipe interne, documentation, ateliers) | 10 000 € | 5 000 € | 5 000 € | 20 000 € |
| Total | 185 276 € | 20 276 € | 20 276 € | 225 828 € |
ROI calculé
Le scénario suppose ~150 M tokens/mois (chat + RAG), soit ~5 M tokens/jour. Facture cloud recalculée : ~1 578 €/mois, soit 18 936 €/an arrondis à ~18 900 € (150 M × 10,52 €/M × 12). Coût local amorti sur 3 ans : 75 276 €/an (TCO 225 828 € / 3), soit 206 € par jour (225 828 € / 1 095 jours).
Seuil de rentabilité, formule visible : tokens par jour = coût local journalier (206 €) / prix API par million de tokens, à 1 € = 1,1403 $ (BCE, 25 septembre 2026). Face à Claude Opus 5.5 à 12 $/M (10,52 €/M) : 19,6 M tokens/jour.
Face à GPT-6 Astra à 30 $/M (10 $ en entrée, 50 $ en sortie, grille OpenAI du 26 septembre 2026 ; 26,31 €/M) : 7,8 M tokens/jour ; face à GPT-6 Sol à 6 $/M (2 $ et 10 $ ; 5,26 €/M) : 39,2 M tokens/jour.
Face à l'API DeepSeek (grille relevée le 26 septembre 2026, entrée 0,15 $ et sortie 0,60 $ par million en heures creuses, mixées 50/50, soit 0,375 $/M ou 0,33 €/M ; le double en heures pleines) : 625 M tokens/jour en heures creuses, 312 M en heures pleines.
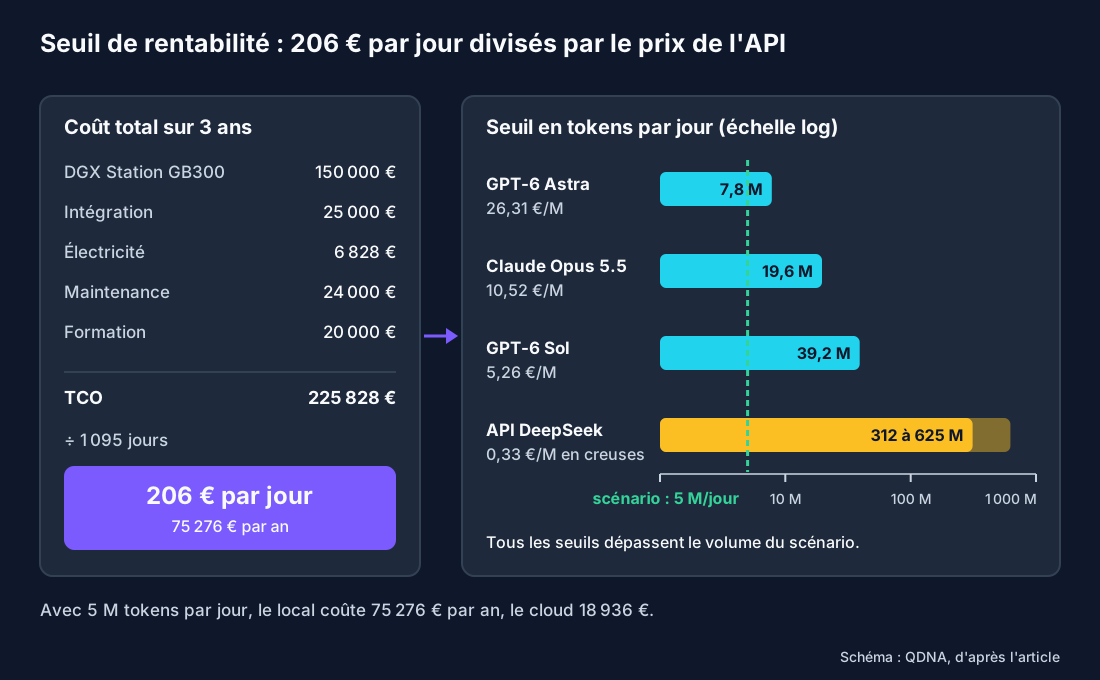
Le modèle deepseek-flash est servi par V4.1 Flash depuis le 10 septembre 2026. Avec les 5 M tokens/jour supposés, aucun de ces seuils n'est atteint, ce qui confirme que le choix du local ne se justifie pas ici par le prix du token, mais par les garanties que la section suivante détaille.
Face à la facture cloud recalculée, le local coûte 75 276 − 18 936 = 56 340 € de plus par an, et encore 75 276 − 23 670 = 51 606 € avec 25 % de croissance ; la version du 2 août, avec une facture cloud de 96 000 € qu'aucune grille ne justifiait, concluait à une économie.
Le scénario ne se justifie donc pas par le coût : ses arguments sont la souveraineté des données (aucun transfert hors site), l'absence de limite de débit imposée par un éditeur et la possibilité d'affiner le modèle sur des données internes.
Points de vigilance
Quatre points de vigilance conditionnent la réussite du déploiement : la marge mémoire du runtime, le déchargement CPU des grands modèles, le calibrage du cache KV en FP8 et la mémoire réelle de la station.
- Sous-estimer l'overhead runtime : laisser au moins 3 Go de marge pour le runtime vLLM, les buffers CUDA, et le système. Sur DGX Spark 128 Go, il ne reste que 21 Go de KV cache après le modèle UD-IQ3_XXS (104 Go) + overhead (3 Go).
- Activer --cpu-offload-gb pour les grands modèles : pour les modèles qui dépassent la mémoire unifiée (comme le 167 Go natif sur DGX Spark 128 Go), l'offload CPU est obligatoire mais coûte en latence.
- Calibrer le KV cache FP8 : la compression FP8 du KV cache divise la mémoire par 2 mais conserve une précision acceptable pour la plupart des cas d'usage. Pour les cas critiques (raisonnement long, code complexe), préférer BF16.
- Ne pas oublier le downgrade B300 : la DGX Station GB300 livre 252 Go HBM3e @ 7,1 To/s au lieu des 288 Go @ 8 To/s annoncés à GTC 2025. Le downgrade est dû à l'usage de B300 salvés avec 7/8 stacks HBM3e. Source : ServeTheHome (GTC 2026).
- Planifier les mises à jour : DGX OS requiert des redémarrages planifiés au rythme des mises à jour de sécurité NVIDIA ; prévoir une fenêtre de maintenance.
- Former l'équipe interne : le scénario budgète 10 000 € et deux semaines pour former 10 personnes (5 dev, 3 ops, 2 data), condition d'une exploitation autonome.
Conclusion
Dans ce scénario, DeepSeek V4 Flash 0731 sur DGX Station GB300 tient techniquement (167 Go de poids publiés pour 748 Go de mémoire, contexte d'un million de tokens) avec des débits qui restent à mesurer.
Économiquement, il coûte 75 276 € par an amortis contre une facture cloud de 18 936 €, soit 56 340 € de plus par an, au tarif Anthropic de Claude Opus 5.5 du 26 septembre 2026, loin des seuils de rentabilité au volume retenu. Ce qui le justifie est la souveraineté des données (aucun transfert hors site), l'absence de limite de débit éditeur et la stabilité d'une version figée.
L'étape suivante d'un tel scénario serait un cluster 2× DGX Spark (14 000 € HT de machines, 2 × 7 000 € HT au prix retenu en octobre 2026) pour la redondance, dimensionné dans notre guide DeepSeek V4 Flash sur DGX Station et cluster 2× Spark.
Références
- DeepSeek V4 Flash 0731, dépôt officiel Hugging Face
- Rapport technique DeepSeek V4 (arXiv 2606.19348)
- Unsloth, documentation DeepSeek V4
- NVIDIA, blog DGX Spark performance
- ServeTheHome, DGX Station GTC 2026
- Fiche QDNA : DGX Station
- Fiche QDNA : vLLM
- Fiche QDNA : DeepSeek V4
Questions fréquentes
Combien coûte un déploiement DeepSeek V4 Flash 0731 sur DGX Station pour une PME ?
Dans ce scénario, le coût total de possession sur 3 ans est de 225 828 € : 150 000 € HT pour la DGX Station GB300 (prix retenu en octobre 2026), 25 000 € d'intégration, 6 828 € d'électricité (1 600 W × 24 h × 365 j × 0,1624 €/kWh HT, soit 2 276 € par an), 24 000 € de maintenance et 20 000 € de formation, soit 75 276 € par an ou 206 € par jour. Divisé par les 5 M tokens par jour du scénario, cela fait 41,2 € par million de tokens ; 20 €/M supposeraient 10,3 M tokens par jour, débit non mesuré.
Quel est le temps de réponse réel d'un déploiement DeepSeek V4 Flash 0731 sur DGX Station ?
Il n'est pas mesuré : aucun couple DeepSeek V4 Flash / DGX Station ne figure encore dans notre section mesures, et les 68 tok/s, 2,6 secondes de préremplissage et 14,6 ms par token de la version du 2 août ne reposaient sur aucune formule visible. Le seul plafond calculable, 7,1 To/s divisés par les 4,8 Go relus par token en UD-IQ3_XXS, donne environ 1 500 tokens/s à un flux, valeur théorique jamais atteinte en pratique.
Comment une PME peut-elle justifier l'investissement dans un DGX Station GB300 ?
Par la souveraineté des données, l'absence de limite de débit éditeur et la capacité à affiner le modèle sur des données métier, plus que par le coût : avec un coût local de 206 € par jour (TCO 225 828 € sur 1 095 jours), le seuil de rentabilité est de 19,6 M tokens/jour face à Claude Opus 5.5 (12 $/M, 10,52 €/M) et de 312 à 625 M tokens/jour face à l'API DeepSeek V4.1 Flash (grille du 26 septembre 2026), bien au-dessus des 5 M tokens/jour du scénario.
Quels sont les pièges à éviter lors d'un déploiement DeepSeek V4 Flash 0731 sur DGX Station ?
Les principaux pièges sont : sous-estimer l'overhead runtime (3 Go minimum), ne pas activer --cpu-offload-gb pour les modèles > 128 Go, négliger la calibration du KV cache FP8, et oublier le downgrade B300 (252 Go / 7,1 To/s au lieu de 288 Go / 8 To/s annoncés). Voir la section « Points de vigilance ».
Comment mesurer le ROI d'un déploiement DeepSeek V4 Flash 0731 sur DGX Station ?
Calculer le coût total de possession (TCO) sur 3 ans : acquisition + électricité + intégration + maintenance + formation, le diviser par 1 095 jours, puis diviser ce coût journalier par le prix API par million de tokens (entrée et sortie mixées, heures creuses et pleines pour DeepSeek) : le quotient est le volume quotidien à partir duquel le local coûte moins cher. Ajouter la valeur de la souveraineté (pas de transfert de données, pas de rate-limit, pas de risque de désactivation).