RAG en entreprise : brancher l'IA sur vos documents
La génération augmentée par la recherche relie un modèle de langage à vos documents internes, et elle répond sur vos données, sans les envoyer à un tiers et sans réentraîner le modèle.
Mis à jour le 26 septembre 2026 : Passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).

Qu'est-ce que le RAG et pourquoi en entreprise
Un modèle de langage ne connaît pas vos contrats, vos procédures ni votre base de connaissances, et le réentraîner sur ces documents coûte cher et se démode à chaque mise à jour de la base documentaire.
La génération augmentée par la recherche résout le problème autrement : elle retrouve les passages utiles au moment de la question et les place dans le contexte du modèle, qui répond en s'appuyant sur eux, si bien que les données restent à leur place, et une source change sans réentraînement.
Le cadre général figure dans notre définition de la plateforme IA souveraine.
Comment fonctionne le pipeline RAG de 2026, étape par étape ?
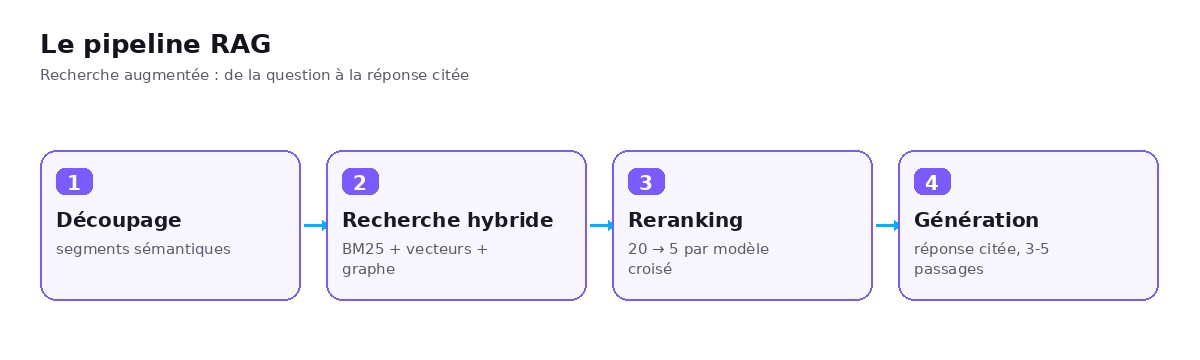
L'architecture d'un simple index vectoriel avec recherche par similarité, courante en 2023, échoue sur les corpus réels. Le pipeline actuel se compose de deux flux : une indexation hors ligne qui prépare les documents, et une chaîne en ligne qui traite chaque question.
| Étape | Rôle |
|---|---|
| Découpage sémantique | Segmenter au changement de sens plutôt qu'à taille fixe, pour des passages qui se suffisent |
| Recherche hybride | Combiner mots-clés (BM25) et vecteurs, fusionnés par rang réciproque, avec parfois une couche graphe |
| Reranking | Un modèle croisé réévalue les 20 candidats et retient les 5 meilleurs |
| Génération citée | Le modèle répond à partir de 3 à 5 passages, avec les sources |
Comment découper les documents pour le RAG ?
Le découpage en blocs de taille fixe démarre vite et plafonne aussitôt, quand le découpage sémantique segmente là où le sens change, en comparant les phrases voisines, l'objectif restant la cohérence : chaque passage doit répondre à une question par lui-même.
Avec le choix du modèle d'embedding, le découpage est le levier qui pèse le plus sur la qualité, et il échoue en silence sans banc d'évaluation dès la première semaine, quand le corpus s'enrichit sans que personne ne mesure le rappel.
Recherche hybride et reranking
La recherche purement vectorielle rate les correspondances exactes, la recherche par mots-clés rate la proximité de sens, si bien qu'en 2026 l'architecture par défaut associe les deux, fusionnés par rang réciproque. Le reranking fait ensuite la différence : un modèle croisé évalue conjointement la question et chaque passage, ce qui distingue le passage réellement pertinent du passage simplement proche.
La règle pratique tient en une ligne : récupérer vingt candidats, en garder cinq, en envoyer trois à cinq au modèle. C'est la mémoire à trois couches de QDNA : un rappel hybride fusionne le vectoriel (Qdrant) et le graphe (FalkorDB), puis un reranker re-classe les résultats.
RAG ou réglage fin : que choisir ?
Les deux approches se complètent, puisque le RAG contrôle ce que le modèle sait et le réglage fin façonne sa manière de répondre. Le RAG convient aux connaissances qui changent, aux sources citables et au contrôle d'accès, quand le réglage fin convient au ton, au format et aux tâches répétées, et une plateforme sérieuse combine souvent les deux.
Comment le RAG applique-t-il le contrôle d'accès au moment de la recherche ?
Dès qu'un système touche à des connaissances ou à des données réglementées, il lui faut des contrôles qui passent à l'échelle. Le RAG doit respecter les permissions au moment de la recherche, pas après la génération. Un utilisateur ne voit dans le contexte que les passages auxquels il a droit.
Le routeur sémantique ajoute une couche : il distingue le contenu confidentiel du contenu public et garde le sensible sur un modèle local. Deux angles morts guettent au-delà de l'hallucination : le contexte périmé produit une réponse juste mais dépassée, que les équipes repèrent mal.
Sans observabilité, un défaut de recherche reste invisible : si vous ne voyez pas ce que la recherche a renvoyé, vous ne pouvez pas le corriger, et un cadre d'évaluation de type RAGAS mesure la qualité en continu.
Comment servir le RAG en local ?
L'ensemble tourne sur votre infrastructure. vLLM sert le modèle avec le cache clé-valeur, et LiteLLM unifie l'accès en appliquant les quotas. La base vectorielle comme le graphe restent locaux. La suite pratique se trouve dans notre guide pour installer un LLM local, et l'usage conversationnel dans l'article chatbot d'entreprise.
Ce guide pose le pipeline. Pour ce qui sépare une démonstration d'un système qui tient en production : découpage qui garde le contexte, filtre d'habilitation dans la requête, décomposition, mesure du rappel. Voir les patterns RAG avancés.
Questions fréquentes
Qu'est-ce que le RAG ?
La génération augmentée par la recherche relie un modèle de langage à une base documentaire. Elle retrouve les passages pertinents au moment de la question et les fournit au modèle, qui répond en s'appuyant sur eux, avec les sources.
RAG ou réglage fin, que choisir ?
Les deux se complètent. Le RAG contrôle ce que le modèle sait et convient aux connaissances qui changent ; le réglage fin façonne le ton et le format. Une plateforme combine souvent les deux.
Le RAG peut-il tourner en local et en entreprise ?
Oui. Le modèle, la base vectorielle, le graphe, l'embedder et le reranker s'exécutent sur votre infrastructure. Les documents ne quittent pas l'entreprise, ce qui facilite la conformité.
Pourquoi un simple index vectoriel ne suffit-il pas ?
La recherche par similarité seule échoue souvent sur un corpus réel. Le pipeline de 2026 ajoute une recherche hybride mots-clés plus vecteurs, un reranking par modèle croisé et un contrôle d'accès à la recherche.
Pourquoi un projet RAG échoue-t-il en production ?
L'échec vient rarement du modèle. Il vient d'un corpus mal découpé, d'une recherche qui remonte des passages hors sujet et d'une absence de mesure. Un pipeline fiable évalue la pertinence des réponses en continu, corrige le découpage et le reranking, et trace chaque source citée.