De votre serveur GPU à un service LLM en production : la méthode en sept phases
Un serveur GPU ne devient un service exploitable qu'au prix d'une méthode, et voici sept phases, chacune avec un livrable et un critère de sortie mesurable.
Mis à jour le 8 octobre 2026 : poste DGX Spark porté à 7 000 € HT, le prix retenu après la hausse constatée ; le relevé LDLC.pro du 26 septembre 2026 reste cité.
Mis à jour le 26 septembre 2026 : fourchettes de prix réalignées sur les relevés du 26 septembre 2026 (DGX Spark PNY chez LDLC.pro, RTX PRO 6000 Max-Q chez LDLC, taux BCE du 25 septembre pour le serveur H200) ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Mis à jour le 2 septembre 2026 : les gains d'inférence sont rattachés à leur source (annonce vLLM de juin 2023, article PagedAttention, article fondateur du décodage spéculatif) ou ramenés à une mesure à faire ; l'exemple LoRA est donné avec son calcul ; les fourchettes de prix RTX PRO 6000 et H200 sont signalées comme non adossées à un relevé marchand.
L'objectif est-il un service d'inférence standard plutôt qu'une simple démonstration ?
Disposer d'un serveur graphique ne suffit pas, car la cible est un service d'inférence exposé par une interface standard, utilisable sans réécriture par vos applications existantes, avec des modèles à poids ouverts qui s'exécutent chez vous et une équipe capable de l'exploiter seule. La méthode transforme une machine en plateforme reproductible.
Phase 0 : cadrage et prérequis
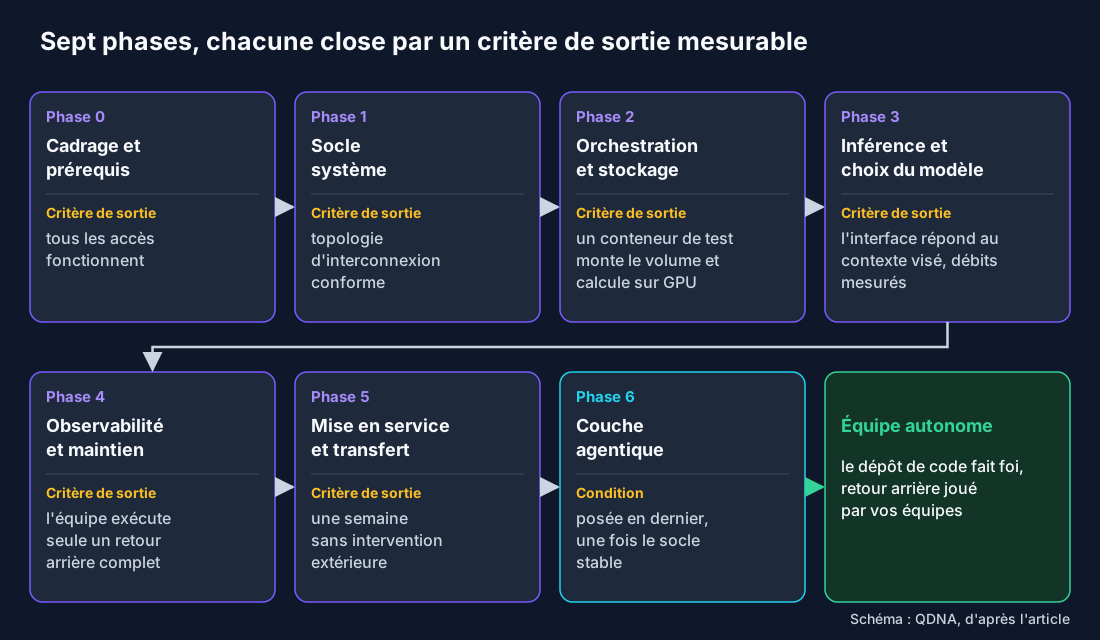
On lève les blocages organisationnels avant le premier atelier technique : alimentation vérifiée en charge et non à vide, réseau et accès distants, comptes d'administration, licences et tokens nécessaires, et surtout deux ou trois cas d'usage prioritaires qui guideront le choix du modèle. Livrable : un dossier de prérequis signé. Critère de sortie : tous les accès fonctionnent.
Phase 1 : socle système
On valide l'existant et on amène le système d'exploitation à l'état requis, sans réinstallation si l'audit le permet, le point sensible étant l'interconnexion entre cartes graphiques, puisqu'un lien mal détecté provoque un repli silencieux et un débit divisé sur toute la vie de la plateforme, ce qui impose de le vérifier une fois, proprement.
Livrable : un rapport d'audit et une procédure rejouable. Critère de sortie : topologie d'interconnexion conforme.
Phase 2 : orchestration et stockage
Le serveur rejoint un orchestrateur de conteneurs comme nœud dédié à l'inférence, et le stockage des modèles y est le point critique : un modèle de plusieurs dizaines de gigaoctets doit résider sur un volume persistant, faute de quoi chaque redémarrage imposerait un nouveau téléchargement, tandis qu'un registre d'images interne rend la plateforme indépendante d'Internet au redémarrage.
Livrable : des manifestes versionnés. Critère de sortie : un conteneur de test monte le volume et exécute un calcul sur carte graphique.
Comment l'inférence et le choix du modèle se déroulent-ils en phase 3 ?
On sert le modèle avec un moteur d'inférence à haut débit qui expose une interface standard. Le choix du modèle se fait en atelier, à partir des cas d'usage : taille, contexte, latence. Les réglages clés couvrent la répartition du modèle entre les cartes, l'extension du contexte, le cache en basse précision et la réutilisation des débuts de conversation.
Livrable : la définition versionnée du service. Critère de sortie : l'interface répond au contexte visé, les débits sont mesurés.
Les mesures d'inférence sont bruitées. On active la génération complète, on répète au moins trois fois, on retient la médiane, et on ne mesure jamais à froid : les premiers lots compilent des routines à la volée.
Comment garantir l'observabilité et le maintien en condition en phase 4 ?
On exploite la plateforme sans dépendre de personne. Des tableaux de bord donnent l'état d'un coup d'œil, le dépôt de code fait foi, et la procédure de retour arrière est jouée en atelier, pas seulement documentée. Livrable : un guide d'exploitation. Critère de sortie : l'équipe exécute seule un retour arrière complet.
Comment se déroule la mise en service et le transfert de compétences en phase 5 ?
L'interface est exposée aux applications, une passerelle gère l'authentification et les quotas, et les premiers cas d'usage passent en production. Le transfert de compétences se fait par des ateliers d'exploitation et des scénarios d'incident joués. Livrable : un premier cas d'usage en production. Critère de sortie : une semaine d'exploitation sans intervention extérieure.
Phase 6 : la couche agentique
Une interface qui produit du texte ne transforme pas une organisation, car la valeur vient des agents outillés, dotés d'une mémoire persistante et de procédures réutilisables, et cette couche se pose en dernier, une fois le socle stable. Ce passage du chat assisté à l'agentique est détaillé dans un article dédié.
Quels leviers optimisent l’inférence d’un LLM ?
Un même serveur sert bien plus d'utilisateurs dès que le moteur d'inférence est réglé, les leviers se cumulant et se mesurant un à un.
- Le moteur vLLM multiplie le débit jusqu'à vingt-quatre fois par rapport à Hugging Face Transformers, sur les mêmes cartes (annonce vLLM du 20 juin 2023, mesure de l'éditeur du moteur).
- L'attention paginée fait tomber le gaspillage de mémoire du cache de 60 à 80 % à moins de 4 % (article PagedAttention, 2023, même source).
- La quantification en précision réduite divise la mémoire des poids par deux à chaque palier (BF16 vers FP8, FP8 vers FP4) ; le gain de débit et la perte de qualité qui en résultent dépendent du modèle et du matériel, et se mesurent sur la charge.
- Le décodage spéculatif abaisse la latence d'un facteur deux à trois dans l'article fondateur (Leviathan, Kalman et Matias, 2023), le gain réel dépendant du taux d'acceptation des brouillons sur votre charge.
- Un modèle de base et plusieurs adaptateurs spécialisés tiennent sur une seule carte, là où des modèles séparés en réclameraient trois ou quatre. Exemple chiffré : un modèle de huit milliards de paramètres en BF16 pèse seize gigaoctets ; quatre variantes spécialisées séparées pèseraient soixante-quatre gigaoctets, quand le socle et quatre adaptateurs LoRA de quelques centaines de mégaoctets tiennent dans dix-sept.
Ces réglages appartiennent à la phase d'inférence, où ils se valident par la mesure, jamais par la supposition, et gardent la charge sur une infrastructure hébergée en Europe.
Quels sont les ordres de grandeur par gamme ?
Le budget dépend de la gamme et de la mémoire, et en 2026 la pénurie de mémoire tire les prix vers le haut. Voici des fourchettes indicatives, détaillées dans notre guide des prix d'un serveur IA.
| Gamme | Pour qui | Fourchette indicative |
|---|---|---|
| Poste DGX Spark | TPE | 7 000 € HT (8 400 € TTC), prix retenu en octobre 2026 après la hausse constatée (relevé LDLC.pro du 26 septembre 2026 : 5 083 € HT, PNY DGX Spark livré sous 15 jours) ; 5 290 € HT chez Nelpx, en stock |
| Serveur RTX PRO 6000 (2 à 8 GPU) | PME | sur devis ; carte seule 16 000 $ HT sur la place de marché NVIDIA au 1er septembre 2026 (relevé thundercompute, source secondaire) ; 17 709,95 € TTC, soit 14 758 € HT, en édition Max-Q chez LDLC le 26 septembre 2026 |
| Serveur H200 (8 GPU) | Grande entreprise | environ 451 000 € HT (387 785 £ HT chez CTO Servers, relevé du 2 septembre 2026, un seul vendeur, converti au taux BCE du 25 septembre 2026) |
| Aucun constructeur ne publie de prix pour un châssis RTX PRO 6000 à huit cartes ; le prix H200 repose sur un seul revendeur : les deux restent à confirmer par devis (valeurs alignées sur nos fiches matériel et le guide des prix). | ||
Ces prix sont indicatifs et non contractuels, hors remises et intégration.
Questions fréquentes
Combien de phases au total ?
Sept, du cadrage à la couche agentique, avec un livrable et un critère de sortie mesurable par phase.
Comment éviter de dépendre du prestataire à la fin ?
La validation repose sur des critères vérifiables, le dépôt de code fait foi et le retour arrière est joué par vos équipes.
Quand introduire les agents ?
En dernier, une fois l'inférence servie et l'exploitation maîtrisée. Les agents s'appuient sur ce socle.