GLM-5.3-Flash sur Mac Studio M5 Ultra : 320 milliards de paramètres dans 512 Go
Un modèle de 320 milliards de paramètres tient sur une machine de bureau, en 8 bits et sans compromis de quantification, parce que trente-quatre de ses quarante-cinq couches n'accumulent aucun cache. Voici le dimensionnement, le contexte réellement servi et le débit calculé.
Une architecture faite pour le contexte long
La fiche publiée par Z.ai annonce 320 milliards de paramètres au total pour 18 milliards actifs par token, sous licence MIT, ce qui reste rare à cette échelle et autorise l'usage commercial comme la redistribution.
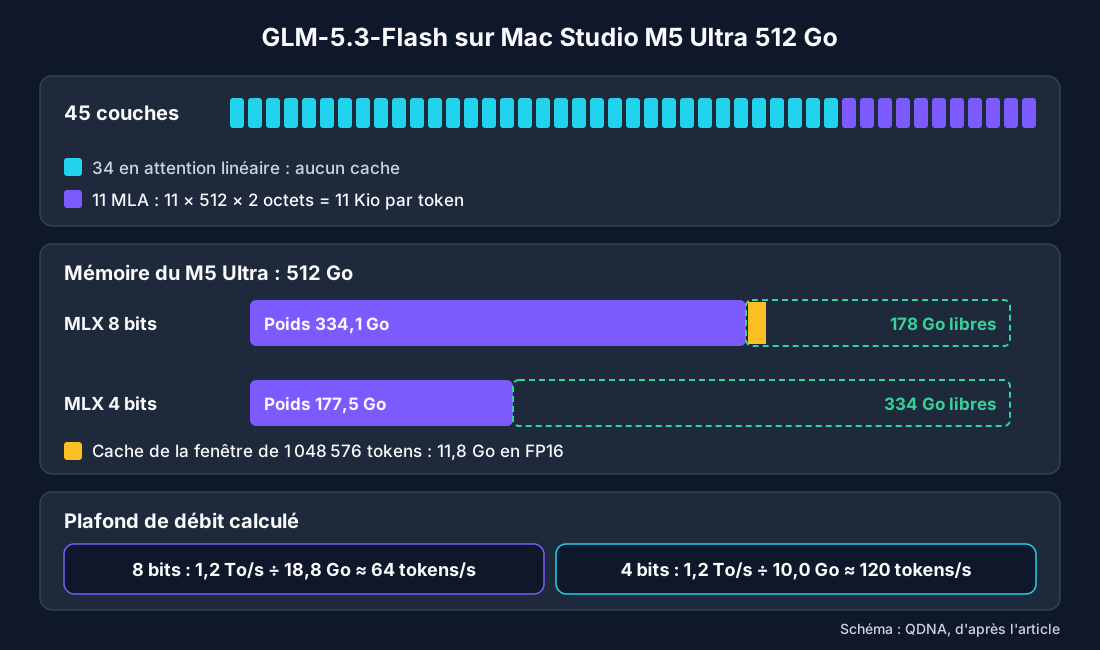
Le config.json précise le reste : quarante-cinq couches, dont trente-quatre en attention linéaire et onze en attention creuse de type MLA, avec un routage vers huit experts sur deux cent quatre-vingt-huit plus un expert partagé. Le point décisif pour le dimensionnement tient dans la valeur kv_lora_rank, fixée à 512.
L'attention latente ne stocke pas des clés et des valeurs séparées mais un unique vecteur compressé par couche et par token, ce qui réduit le cache d'un ordre de grandeur par rapport à une attention classique. La fenêtre déclarée dans la configuration atteint 1 048 576 tokens.
Ce qu'il pèse en MLX
Comme pour les autres modèles de cette taille, aucune conversion ne provient de l'organisation mlx-community, et les versions disponibles sont publiées par des contributeurs individuels. Les tailles ci-dessous sont relevées sur les fichiers publiés.
| Conversion | Poids sur disque | Reste sur 512 Go |
|---|---|---|
| MLX 8 bits | 334,1 Go | 178 Go |
| MLX 4 bits | 177,5 Go | 334 Go |
La version 8 bits reproduit fidèlement le format FP8 natif des poids d'origine, ce qui en fait la référence de qualité, et elle laisse encore 178 Go pour le cache et le système. La version 4 bits divise l'empreinte par deux et double le débit théorique, au prix d'une dégradation qu'il faut mesurer sur vos propres tâches plutôt que supposer.
Combien de contexte tient réellement
Onze couches seulement portent un cache, et chacune ne stocke qu'un latent de 512 valeurs par token, ce qui donne 11 × 512 × 2 octets = 11 264 octets, soit 11 Kio par token en FP16 et 5,5 Kio en FP8, hors clés de l'indexeur DSA (128 octets par couche, soit 1,4 Kio de plus).
Rapporté à la fenêtre déclarée, le résultat surprend.
Mis à jour le 26 septembre 2026 : disponibilité du Mac Studio M5 Ultra relue le 26 septembre 2026 : livré depuis le 22 septembre en 96 et 256 Go, option 512 Go toujours annoncée pour fin octobre, aucune mesure indépendante reproductible publiée.
Mis à jour le 2 septembre 2026 : valeurs relues contre le config.json du dépôt zai-org/GLM-5.3-Flash (45 couches, 34 linéaires, 11 DSA, kv_lora_rank 512, 288 experts routés plus un partagé, fenêtre 1 048 576) et les safetensors des conversions citées (334,1 et 177,5 Go). Aucune valeur n'a changé, la formule du cache est désormais écrite.
| Contexte | Cache FP16 | Cache FP8 |
|---|---|---|
| 262 144 tokens | 3,0 Go | 1,5 Go |
| 1 048 576 tokens (fenêtre déclarée) | 11,8 Go | 5,9 Go |
Même en 8 bits, où les poids consomment déjà 334 Go, les 178 Go restants couvriraient près de seize millions de tokens de cache en FP16. La fenêtre du modèle est donc atteinte très avant la limite de la machine, ce qui renverse l'intuition héritée des architectures à attention complète, où le contexte long se payait en dizaines de gigaoctets.
Le débit qu'on peut attendre
Le calcul suit la même règle que pour tout modèle à mélange d'experts, puisque seuls les paramètres actifs sont relus à chaque token. Les tailles mesurées donnent 1,044 octet par paramètre en 8 bits et 0,555 en 4 bits, ce qui conduit aux deux plafonds ci-dessous.
| Conversion | Lecture par token | Plafond arithmétique |
|---|---|---|
| MLX 8 bits | 18,8 Go | ~64 tokens/s |
| MLX 4 bits | 10,0 Go | ~120 tokens/s |
Ces valeurs divisent la bande passante de 1,2 To/s du M5 Ultra par le volume relu, et il s'agit donc de calculs et non de relevés. Le débit observé se situe généralement entre soixante et quatre-vingts pour cent d'un tel plafond.
L'écart entre les deux quantifications montre surtout que le choix se joue entre la qualité des sorties et la vitesse, pas entre tenir et ne pas tenir, puisque les deux versions logent largement dans la mémoire de la machine.
Comment Qwen3.8-Flash-Next et GLM arbitrent-ils différemment ?
Les deux modèles visent la même machine et adoptent la même idée d'architecture hybride, mais ils n'arbitrent pas de la même façon. Qwen active six milliards de paramètres et plafonne autour de 320 tokens par seconde, quand GLM en active dix-huit et plafonne à 120 en 4 bits.
L'écart de vitesse se paie en capacité de raisonnement, trois fois plus de paramètres actifs pesant sur chaque token produit. Notre article dédié détaille le premier cas, sur Qwen3.8-Flash-Next servi en MLX.
Les réserves
La configuration à 512 Go du Mac Studio M5 Ultra reste annoncée pour la fin octobre 2026 (page Apple France relue le 26 septembre) ; les modèles à 96 et 256 Go sont livrés depuis le 22 septembre, sans mesure indépendante reproductible publiée à ce jour, ce qui explique que cet article s'en tienne aux calculs.
La fiche officielle du modèle reste par ailleurs avare en détails, puisqu'elle ne publie ni le nombre de couches, ni la taille des fichiers, ni la fenêtre de contexte, toutes valeurs que nous avons lues dans la configuration du dépôt.
Questions fréquentes
GLM-5.3-Flash tient-il sur un Mac Studio M5 Ultra ?
Oui, dans la configuration 512 Go. La conversion MLX 8 bits pèse 334,1 Go mesurés et laisse 178 Go pour le cache et le système, tandis que la version 4 bits descend à 177,5 Go. Aucune des deux ne tient sur la machine d'entrée à 96 Go.
Quelle longueur de contexte peut-on servir ?
La configuration déclare une fenêtre de 1 048 576 tokens, et le cache correspondant ne coûte que 11,8 Go en FP16, parce que onze couches sur quarante-cinq seulement portent un cache et qu'elles n'y stockent qu'un latent compressé de 512 valeurs. La mémoire de la machine n'est donc jamais le facteur limitant.
Faut-il préférer la conversion 4 bits ou 8 bits ?
La version 8 bits reproduit le format FP8 natif des poids d'origine et sert de référence de qualité, au plafond de 64 tokens par seconde. La version 4 bits double le débit théorique et libère 156 Go de mémoire, mais la perte de qualité doit se mesurer sur vos propres tâches avant tout engagement.
Sous quelle licence le modèle est-il publié ?
Les poids sont sous licence MIT, ce qui autorise l'ajustement fin, le déploiement commercial et la redistribution. C'est une licence nettement plus permissive que celles retenues par plusieurs modèles concurrents de taille comparable.