Mistral Large 4 « le Chonk » : ce qui est vérifié, et quel matériel pour le servir
Mistral AI a ouvert le 6 octobre 2026 la préversion de son plus grand modèle, aux poids ouverts promis pour la fin du mois. Nous avons recoupé 382 affirmations de sources officielles, de presse, de vidéos et de classements indépendants : ce qui tient, ce qui se contredit, et les machines capables de l'héberger.

Méthodologie
Cette méthodologie classe chaque chiffre selon son origine, parce que la préversion a produit en vingt-quatre heures plus de valeurs contradictoires que de valeurs officielles, et qu'un chiffre repris dix fois par la presse n'en devient pas plus sûr pour autant.
Nous avons consulté les pages de Mistral (billet en anglais et en français, fiche de documentation, fiche Hugging Face, page de gouvernance), les opérateurs qui publient leurs propres mesures (OpenRouter, Vercel, Artificial Analysis, Vals), la presse française et internationale, et quatorze vidéos dont nous avons lu les transcriptions intégrales.
Chaque valeur porte un niveau : primaire quand elle vient de Mistral ou de l'opérateur qui la mesure, secondaire concordante quand plusieurs médias la reprennent sans source primaire, et calcul quand elle sort de notre arithmétique. Les recherches, menées le 7 octobre 2026 avec save-agent-rs, notre essaim d'agents local, ont été relues à la main contre les pages sources.
Ce que Mistral a publié le 6 octobre 2026
Mistral Large 4 est sorti en « Public Preview », version v26.10, sous les identifiants d'API mistral-large-4 et mistral-large-4-0, présenté par Arthur Mensch au salon AI Everything d'Abu Dhabi. Le billet le surnomme lui-même « Officieusement ML4, très officiellement : le Chonk », en écho au mème du « chaton fat » de juin.
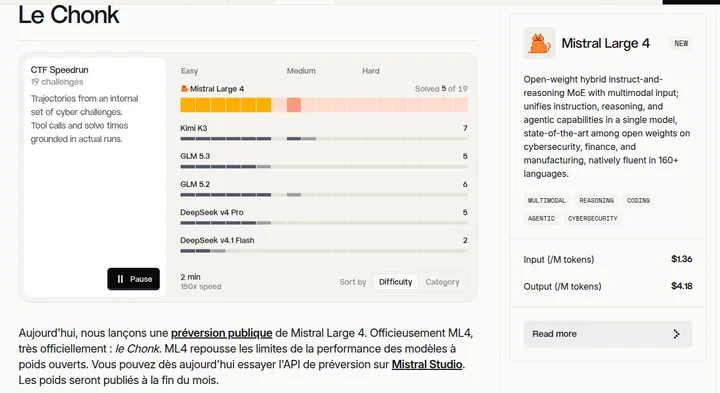
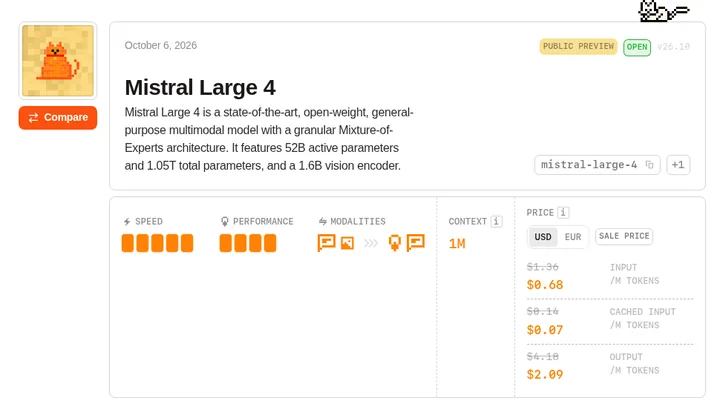
La fiche de documentation donne l'essentiel des caractéristiques publiées : mélange d'experts « granulaire », modèle hybride qui répond directement ou raisonne selon le paramètre reasoning_effort (none ou high), encodeur visuel de 1,6 milliard de paramètres, plus de 160 langues dont toutes les langues officielles de l'Union européenne. La sortie est uniquement textuelle.
Le papier technique n'existe pas encore : Mistral promet l'architecture, des bancs supplémentaires et la méthode de post-entraînement avec la publication des poids. Le nombre d'experts, le nombre de couches, la conception de l'attention et la taille du vocabulaire restent donc inconnus.
Que veulent dire 1,05 billion de paramètres et 49 milliards actifs ?
Dans un mélange d'experts, chaque jeton ne traverse qu'une petite partie du réseau : un routeur choisit quelques experts parmi des centaines, et le reste attend en mémoire. C'est ce qui permet à Mistral Large 4 de calculer chaque jeton avec 49 milliards de paramètres seulement, soit moins de 5 % du total, tout en devant garder les 1 050 milliards chargés.
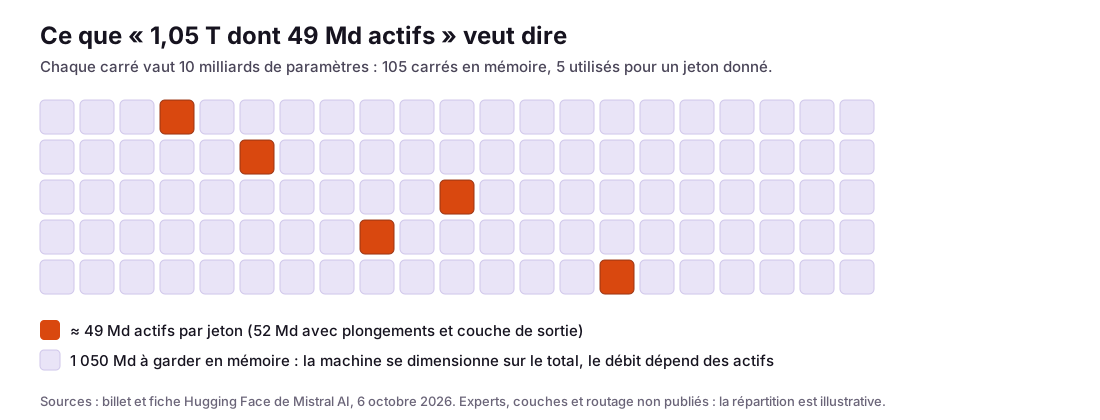
Deux conséquences pratiques en découlent pour qui veut l'héberger. La mémoire se dimensionne sur le total, car tous les experts doivent être résidents, alors que le débit de génération dépend surtout des paramètres actifs, puisque chaque jeton ne lit que leurs poids. Un modèle de ce type est donc lourd à loger mais relativement rapide une fois logé.
L'écart entre 49 et 52 milliards se résout sur la fiche Hugging Face : 49 milliards par jeton dans les couches de calcul, 52 en comptant les plongements et la couche de sortie, d'où le nom de dépôt Mistral-Large-4.0-1T05-A52B. Le billet anglais dit 49, et la fiche de documentation est passée de 49 à 52 le 6 octobre à 17 h 08 UTC.
Quelles valeurs se contredisent ?
Huit points divergent d'une source à l'autre, et aucun ne peut être tranché tant que les poids et le rapport technique ne sont pas publiés. Le tableau donne la valeur que nous retenons et la raison.
| Sujet | Ce qui circule | Valeur retenue |
|---|---|---|
| Paramètres totaux | « 1 T » (billet, X) ; « 675 Md dont 41 actifs » sur un site tiers | 1,05 T (fiche). Les 675 Md / 41 Md sont ceux de Mistral Large 3 |
| Paramètres actifs | 49 Md (billet anglais) ; 52 Md (billet français, fiche) | 49 Md par jeton, 52 Md avec plongements et sortie |
| Contexte | 1 M (fiche) ; 524 288 (API, OpenRouter, Vercel) | 1 M annoncé, 524 288 servi en préversion, 262 144 en sortie |
| GPU d'entraînement | 3 800 (billet) ; « près de 4 000 » (LinkedIn de Mistral) ; 4 000 (presse) | 3 800 GPU Grace Blackwell, génération non précisée |
| Lieu | « Europe » (billet) ; France ou Suède (presse, vidéos) | Centres de données de Mistral en Europe, pays non publié |
| Date des poids | « fin du mois » (billet) ; 26, 27 ou 31 octobre | 31 octobre, date affichée par la fiche Hugging Face |
| Licence | « licence Mistral personnalisée » (un seul média) ; MIT modifiée supposée | Non publiée |
| Matériel d'inférence | « 4 à 8 B200 ou B300 en FP8 et FP4 » (presse) | Non retrouvé dans un document Mistral |
La dernière ligne mérite un calcul : quatre B200 offrent 720 Go, ce qui ne contient pas les 1 050 Go de poids en FP8 et laisse à peine 41 Go de cache au format NVFP4. La formule « 4 à 8 GPU » ne tient donc qu'en lisant 8 pour le FP8 et 4 pour le 4 bits, avec un contexte court.
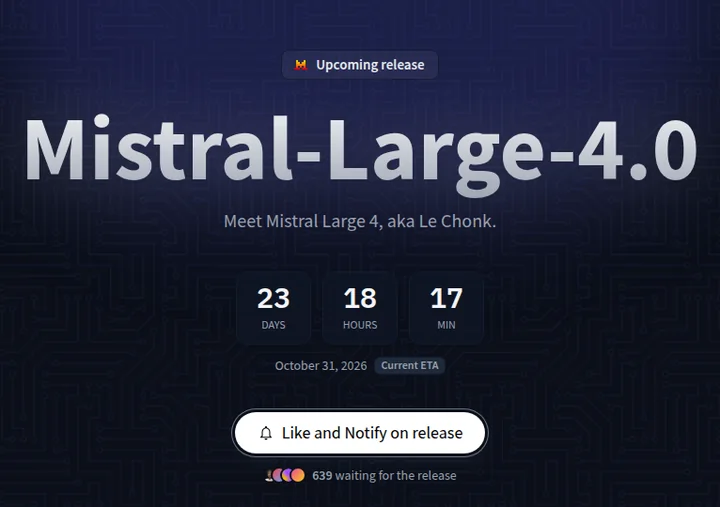
config.json n'est pas public. Source : huggingface.co, 7 octobre 2026.Entraînement et souveraineté : ce qui est européen, ce qui ne l'est pas
L'entraînement s'est fait en Europe, selon Mistral, à partir de zéro sur 3 800 GPU NVIDIA Grace Blackwell installés dans ses propres centres de données, et la préversion est servie sur la même infrastructure, opérée sous droit européen.

La phase d'apprentissage par renforcement mobilise 3 000 GPU et traite environ 33 milliards de jetons par jour, dont 16 milliards entraînables. Elle se poursuit sans saturation selon Guillaume Lample, ce qui veut dire que la préversion testée aujourd'hui n'est pas un point d'arrivée.
La souveraineté a pourtant des limites que les communiqués taisent, et qu'un acheteur public ou réglementé doit connaître. Le calcul reste du silicium NVIDIA, et la série D de 3 milliards d'euros qui finance ce modèle est menée par Samsung Electronics.
Surtout, la licence qui dira ce que vous aurez le droit de faire des poids n'est pas publiée. Héberger soi-même le modèle à partir de fin octobre réglera la question de la localisation des données, pas celle de la dépendance matérielle.
La puissance de 10 MW souvent citée vient d'une déclaration orale de Pierre Stock rapportée par la presse, et la durée de deux mois d'une seule famille de sources secondaires. Nous ne les reprenons qu'à ce titre.
Bancs d'essai : ce que déclare Mistral, ce que mesurent les tiers
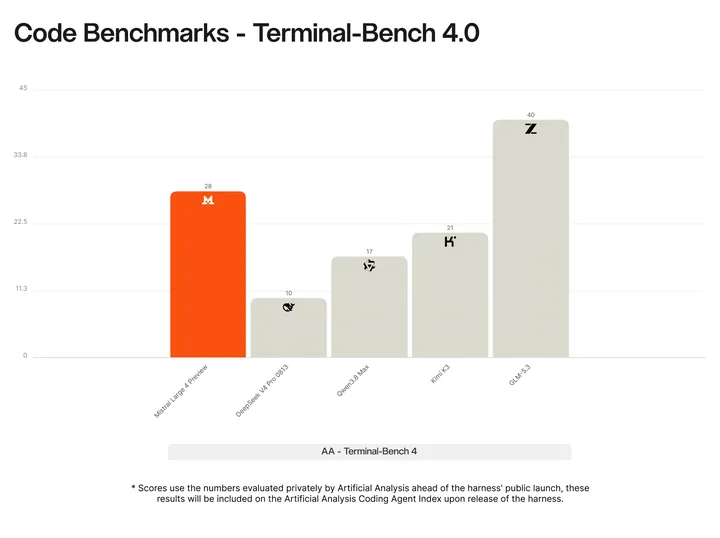
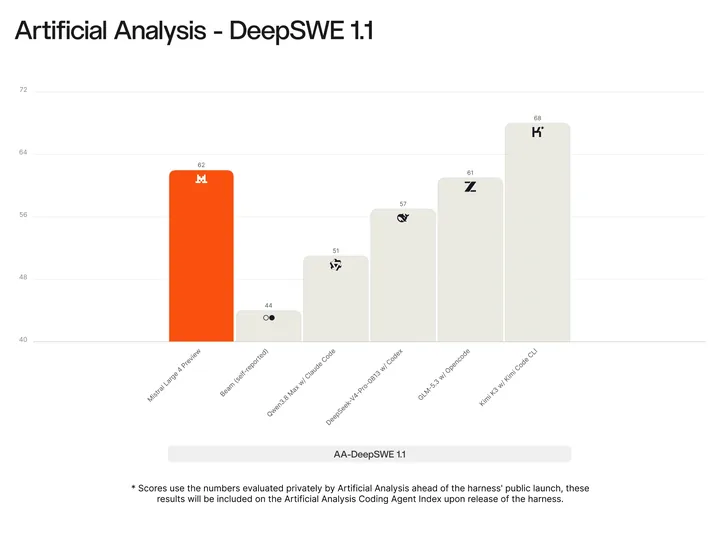
Tous les scores du billet sont autodéclarés, et trois d'entre eux sont contredits par des mesures tierces ou par les propres graphiques de Mistral. Les deux graphiques ci-dessous sont reproduits tels que publiés, avec leurs échelles.
| Épreuve | Déclaré par Mistral | Mesure indépendante |
|---|---|---|
| DeepSWE v1.1 | 61,7 % | Absent du classement public cité par VentureBeat, où Kimi K3 et GLM-5.3 approchent 69 % |
| Terminal-Bench 4 | 28,3 % | 26,8 % (Artificial Analysis), 22,73 % (Vals) |
| CyberGym-E2E | 82 %, meilleur score | 82 % confirmé par Artificial Analysis, devant MiMo-V2.6-Pro à 79 % ; plusieurs modèles fermés refusent la tâche |
| Finance Agent v2 | 54,7 | 54,68 % (Vals), concordant |
| Harvey Legal Agent | 15,8 | 15,83 %, 6e sur 75 (Vals), concordant |
| SciCode-Verified | 91,8, « état de l'art des ouverts » | Le propre graphique de Mistral place GLM-5.3 à 92,5 et Qwen3.8 2.4T à 93,8 |
Avec plus de recul, Artificial Analysis lui donne 38 à son indice d'intelligence v4.3.2, au 64e rang sur 225 et au 8e rang des modèles à poids ouverts, derrière sept modèles chinois, de MiMo-V2.6-Pro à DeepSeek V4.1 Flash. Le même organisme le décrit comme le modèle le plus capable conçu hors des États-Unis et de la Chine.
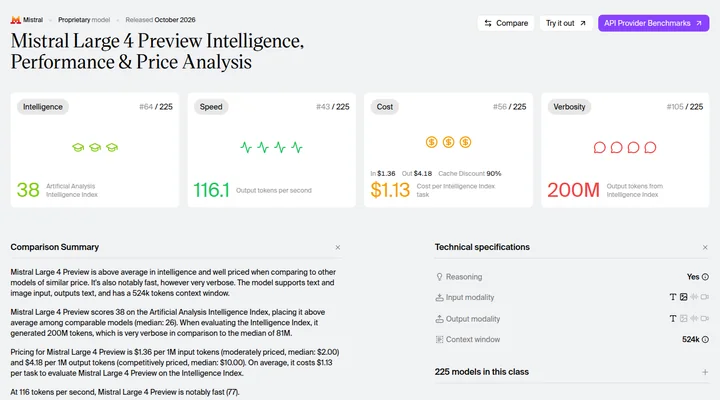
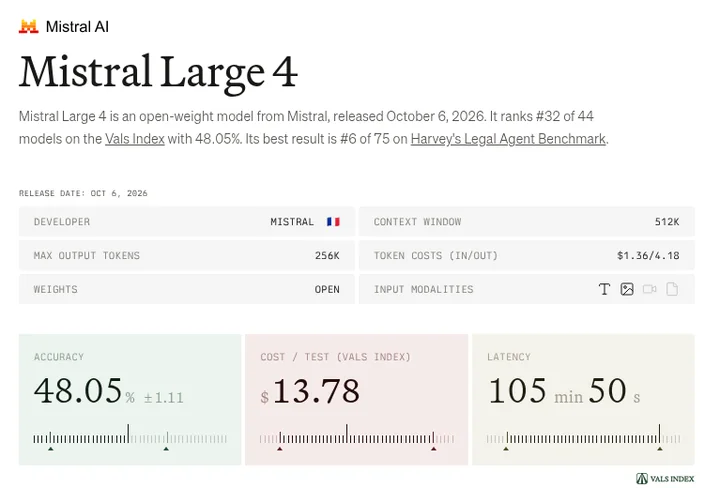
Le point faible mesuré est la verbosité : 200 millions de jetons de sortie pour passer l'indice, quand la médiane des modèles est de 81 millions. Le coût par tâche de l'indice monte ainsi à 1,13 $ au tarif de liste, malgré un prix au jeton modéré. Vals le classe 32e sur 44 avec 48,05 %.
API, prix et usage sur OpenRouter
L'API de Mistral, reprise par OpenRouter et Vercel, affiche un tarif de liste de 1,36 $ par million de jetons en entrée, 4,18 $ en sortie et 0,14 $ pour la lecture en cache, avec une remise de 50 % pendant deux semaines au lancement. Vercel fixe la fin de cette remise au 20 octobre 2026, date que Mistral n'a pas confirmée sur sa page de tarifs.
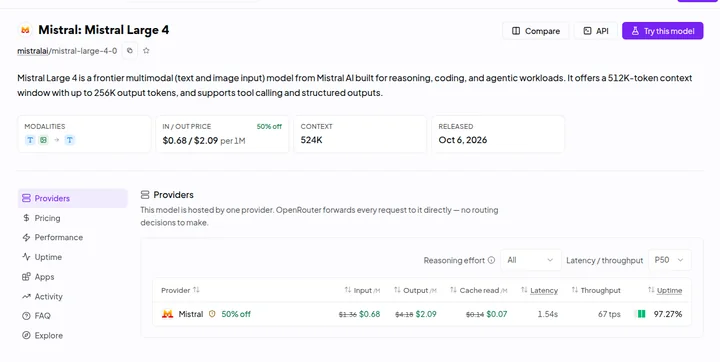
OpenRouter n'a qu'un fournisseur, Mistral lui-même, et mesurait le 7 octobre un débit médian de 67 jetons par seconde pour une latence de 1,68 seconde, avec 97,24 % de disponibilité sur trois jours. Artificial Analysis mesure 116,1 jetons par seconde sur l'API directe, Vercel 72.
Ces valeurs dépendent de l'heure, de la charge et du mode de raisonnement : elles mesurent le service de la préversion, pas le modèle. Sur son classement hebdomadaire, OpenRouter le place troisième des nouveaux modèles avec 12,7 milliards de jetons traités, mais aucune grande plateforme américaine, Azure, AWS ou Google Cloud, ne l'a encore référencé.
Quel matériel pour héberger Mistral Large 4 ?
Aucune taille officielle de point de contrôle n'existe encore, et Mistral laisse à vide les champs de mémoire minimale de sa fiche. Les chiffres qui suivent sont donc des calculs QDNA : paramètres multipliés par les octets du format, plus 15 % de marge d'exécution, sans compter le cache clé-valeur, dont la taille dépend d'une architecture non publiée.
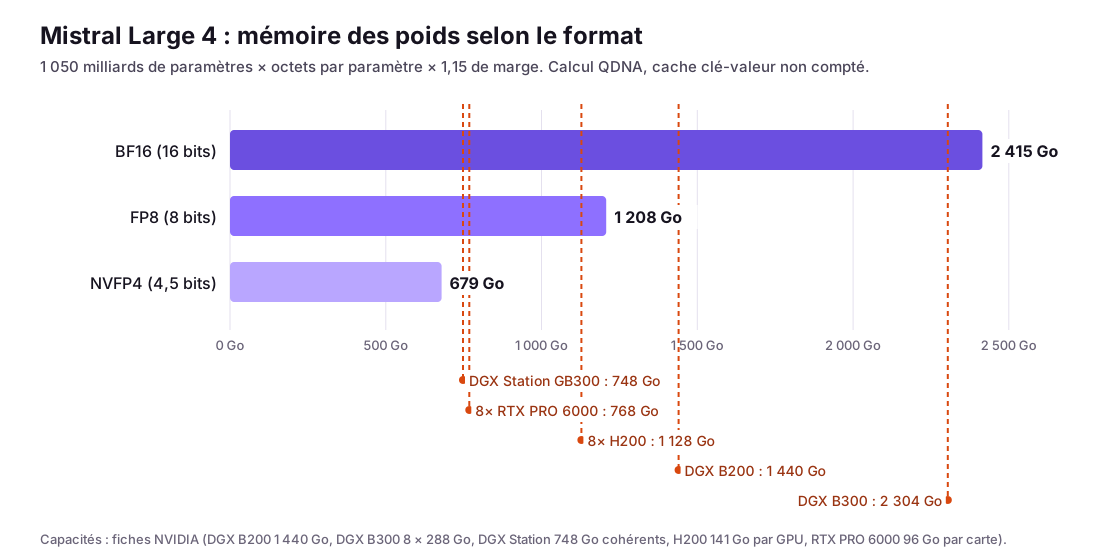
La règle se lit sur le schéma : en BF16, aucun serveur à huit GPU ne suffit, il faut une baie GB300 NVL72. En FP8, la limite passe entre le 8 × H200 (1 128 Go, trop court) et le DGX B200 (1 440 Go). En NVFP4, une DGX Station GB300 ou un serveur de huit RTX PRO 6000 suffisent, avec moins de 90 Go laissés au cache.
| Machine | Mémoire | PFLOPS FP8 dense | PFLOPS FP4 dense | Format qui tient | Reste pour le cache |
|---|---|---|---|---|---|
| DGX Spark (GB10) | 128 Go | non publié | 0,5 NVFP4 | Aucun | n/a |
| Mac Studio M5 Ultra | 512 Go | non publié | pas de FP4 matériel | Aucun, même en 4 bits (604 Go) | n/a |
| DGX Station GB300 | 748 Go | 5 | 15 NVFP4 | NVFP4 | 69 Go |
| 8 × RTX PRO 6000 Blackwell | 768 Go | 8 | 16 NVFP4 | NVFP4 | 89 Go |
| 8 × H200 | 1 128 Go | 15,8 | pas de FP4 matériel | 4 bits en poids seuls (604 Go) | 524 Go |
| DGX B200 | 1 440 Go | 36 | 72 NVFP4 | FP8 | 232 Go |
| DGX B300 | 2 304 Go | 36 | 108 NVFP4 | FP8 | 1 096 Go |
| 8 × MI355X | 2 304 Go | 40 | 80,8 MXFP4 | FP8 | 1 096 Go |
| GB300 NVL72 | 20 736 Go | 360 | 1 080 NVFP4 | BF16 | 18 321 Go |
Les PFLOPS sont les valeurs denses des fiches constructeurs ; NVIDIA publie en premier les valeurs avec parcimonie structurée, deux fois plus élevées, qu'il ne faut pas comparer aux autres. Le H200 et le Mac Studio n'ont pas d'unité FP4 : un modèle en 4 bits s'y exécute en poids compressés, avec un calcul en 8 ou 16 bits.
Ce tableau dit ce qui se charge, pas ce qui se sert bien. Un cache de 69 Go limite fortement le nombre d'utilisateurs et la longueur de contexte, et la vraie réponse dépendra de la taille du cache par jeton, que seul le config.json donnera.
Mistral Large 3 utilisait une attention latente compressée sur 61 couches, mais rien ne garantit que Large 4 en hérite. Le calculateur de mémoire QDNA intègre déjà Mistral Large 4 en préversion, avec un avertissement tant que le cache n'est pas calculable.
Que change l'AI Act pour ce modèle ?
Le règlement européen présume un risque systémique au-delà de 1025 opérations en virgule flottante d'entraînement cumulé, ce qui impose notification à la Commission sous deux semaines, évaluations adverses, signalement d'incidents et cybersécurité renforcée. Les sanctions sur les modèles d'usage général sont possibles depuis le 2 août 2026.
Sur sa page de gouvernance, Mistral classe Large 4 comme modèle d'usage général et déclare ne fournir aucun modèle à risque systémique. Or un ordre de grandeur suffit à poser la question, en partant du nombre de GPU publié et de la durée rapportée par la presse.
À environ 2,5 PFLOPS denses en BF16 par GPU, 3 800 GPU pendant soixante jours donnent 4,9 × 1025 opérations à pleine charge, et encore 1,5 × 1025 à 30 % d'utilisation. Ce calcul est le nôtre, mais il dépasse le seuil avec de la marge.
La publication en poids ouverts n'exonère pas un modèle à risque systémique de ces obligations, l'exemption de l'article 53 ne couvrant que les modèles qui restent sous le seuil. Pour un acheteur, la conséquence est simple : demander la documentation technique et le résumé des données d'entraînement que le règlement exige dans tous les cas.
Où se place-t-il parmi les modèles à poids ouverts ?
Si les poids sortent comme annoncé, Mistral Large 4 deviendra le plus grand modèle ouvert européen, sans être le plus capable ni le plus grand du marché. Les références chinoises sont plus grandes ou mieux notées, et leurs licences sont déjà publiées.

| Modèle | Taille | Licence | Indice AA v4.3.2 |
|---|---|---|---|
| Mistral Large 4 (préversion) | 1,05 T / 49 Md actifs | non publiée | 38 |
| Kimi K3 | 2,8 T / 104 Md actifs | Kimi K3 License | 43,6 |
| GLM-5.3 | 744 Md / 40 Md actifs | licence GLM-5.3 | 44,8 |
| GLM-5.3 Flash | 320 Md / 18 Md actifs | MIT | 41,8 |
| Qwen3.8 2.4T | 2,4 T / 95 Md actifs | licence Qwen, accord au-delà de 50 M$ | 39,9 |
| DeepSeek V4.1 Flash | 552 Md | MIT | 39,5 |
| Mistral Large 3 | 675 Md / 41 Md actifs | Apache 2.0 | 9 |
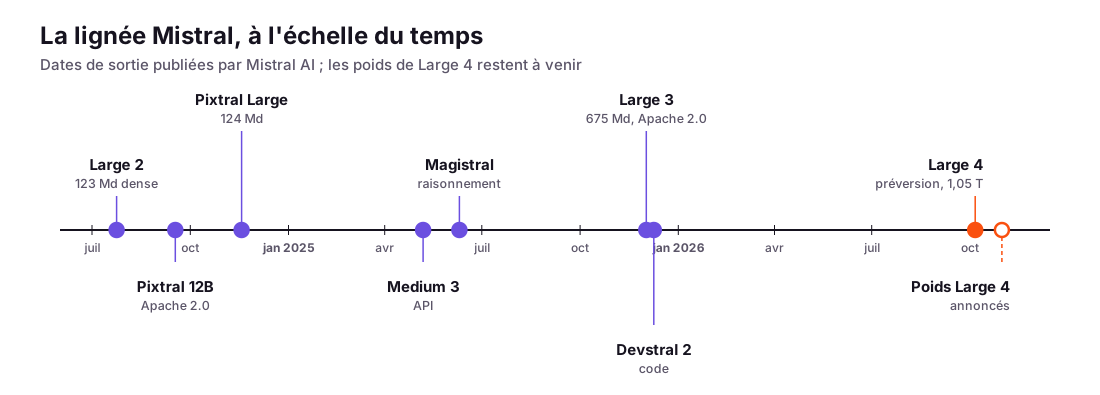
Le saut par rapport à Large 3, noté 9 sur le même indice, est considérable. L'écart restant avec la tête du classement ouvert, environ sept points, correspond à ce que Guillaume Lample décrit lui-même : le niveau des meilleurs modèles chinois d'il y a un ou deux mois.
Ce qu'en disent les vidéos
Aucune vidéo officielle de Mistral n'existait au 7 octobre, mais une trentaine de créateurs ont publié en vingt-quatre heures. Nous en avons transcrit quatorze, en anglais et en français ; les six suivantes apportent des éléments que les articles écrits n'ont pas.
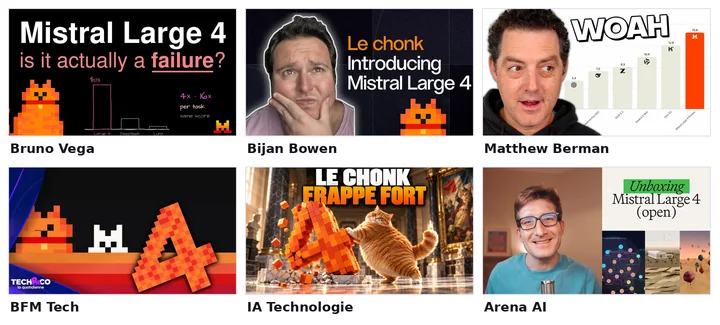
- Bruno Vega, « Is It Actually A Failure? » : la plus dense techniquement, elle calcule la mémoire, relève le contexte servi de 524 288 jetons et attribue le coût par tâche à la lecture en cache.
- Bijan Bowen, premier essai : spécifications commentées et sessions longues dans Vibe CLI, avec l'explication de l'écart entre 49 et 52 milliards.
- Matthew Berman, « Mistral is BACK! » : la plus vue, centrée sur les bancs d'essai et le prix au jeton.
- BFM Tech, Tech&Co du 6 octobre : débat français, source de l'hypothèse d'un entraînement en Suède et de la formule « 4 ou 8 puces B200 B300 ».
- IA Technologie, « la France est-elle vraiment de retour ? » : synthèse critique sur le rang parmi les modèles ouverts et le coût par tâche.
- Arena AI, premières impressions : rang au classement WebDev Arena et question ouverte sur la génération de GPU, GB200 ou GB300.
Les transcriptions automatiques écorchent les noms propres, « Lechon » pour le Chonk ou « deep 1.1 » pour DeepSWE, et nous avons vérifié chaque citation dans son contexte avant de la retenir, en écartant les chaînes à très faible audience dont le contenu semblait généré automatiquement.
Points à surveiller d'ici fin octobre
Six points restent à surveiller d'ici la publication des poids fin octobre. Chacun peut changer le dimensionnement d'un serveur, le coût d'exploitation ou le droit d'usage du modèle, et nous mettrons cet article à jour à chaque publication :
- Le fichier
config.jsonet le rapport technique, qui donneront couches, experts, attention et donc la taille réelle du cache. - La licence, qui décidera de l'usage commercial et du déploiement chez un client final.
- La présence de points de contrôle FP8 et NVFP4 officiels, et leur taille exacte.
- La fenêtre de contexte des poids publiés, 1 M ou 524 288.
- Une éventuelle notification à la Commission européenne au titre du risque systémique.
- Les premières mesures de débit sur matériel local, que nous publierons dans nos mesures quand elles existeront.
Questions fréquentes
Mistral Large 4 est-il open weight ?
Pas encore. Au 7 octobre 2026, il n'est disponible que par API en préversion. Mistral annonce les poids pour la fin octobre et le dépôt Hugging Face affiche le 31 octobre. La licence n'est pas publiée.
Combien de paramètres a Mistral Large 4 ?
1,05 billion de paramètres au total, dans un mélange d'experts. 49 milliards sont actifs par jeton, 52 en comptant les plongements et la couche de sortie. Les 675 milliards parfois cités sont ceux de Mistral Large 3.
Quel matériel faut-il pour faire tourner Mistral Large 4 en local ?
Selon notre calcul, les poids seuls demandent environ 1 210 Go en FP8 et 680 Go en NVFP4, marge de 15 % comprise. Un DGX B200 ou un DGX B300 le logent en FP8, une DGX Station GB300 ou huit RTX PRO 6000 en NVFP4 avec peu de place pour le cache. Un DGX Spark ou un Mac Studio n'y suffisent pas.
Quelle est sa fenêtre de contexte ?
La fiche annonce un million de jetons, mais l'API de la préversion en sert 524 288, avec 262 144 jetons de sortie au maximum. La fenêtre des poids publiés reste à vérifier.
Combien coûte l'API Mistral Large 4 ?
1,36 $ par million de jetons en entrée, 4,18 $ en sortie et 0,14 $ en lecture de cache, avec une remise de 50 % pendant les deux semaines de lancement. Sa verbosité porte le coût par tâche mesuré par Artificial Analysis à 1,13 $.
Sources officielles
- Mistral AI, billet d'annonce de Mistral Large 4, 6 octobre 2026
- Mistral AI, fiche de documentation Mistral Large 4
- Hugging Face, dépôt mistralai/Mistral-Large-4.0-1T05-A52B
- Mistral AI, page de gouvernance du modèle
- OpenRouter, fiche mistralai/mistral-large-4-0
- Artificial Analysis, analyse de Mistral Large 4
- Vals AI, résultats de Mistral Large 4
- Reuters, déclarations d'Arthur Mensch à Abu Dhabi
- Simon Willison, premiers essais du Chonk
- NVIDIA, fiche DGX B300 et fiche DGX B200
- Commission européenne, AI Act, article 51