Claude Fable 5.2, Gemini 4 Carbon, GPT-6.1 Sol : ce que mesurent les tiers, ce que déclarent les éditeurs
Trois modèles fermés mènent les classements en novembre 2026 : Claude Fable 5.2 d'Anthropic, Gemini 4 Carbon de Google et GPT-6.1 Sol d'OpenAI. Nous avons relu le 12 novembre annonces, fiches système, tarifs et mesures indépendantes d'Artificial Analysis et de DeepSWE, en séparant le mesuré du déclaré.

Méthodologie
Chaque chiffre de cet article vient d'une page relue le 12 novembre 2026 entre 19 h 55 et 20 h 05 UTC, citée dans les sources. Nous distinguons trois statuts : la mesure indépendante, faite par un tiers sur un protocole publié ; la déclaration de l'éditeur, faite sur son propre protocole ; et le calcul QDNA, toujours nommé comme tel.
Trois relectures indépendantes, une par éditeur, ont recoupé les annonces, les fiches système et la documentation, et quand une valeur manque, nous écrivons « non publié » au lieu de l'estimer. Les captures d'écran ont été prises le même jour, et leur date figure dans chaque légende pour que le lecteur puisse vérifier la page d'origine.
Un point de nom d'abord : la question « Sol 6.2 » revient souvent, mais OpenAI n'a publié ni annonce, ni fiche système, ni entrée de catalogue pour un GPT-6.2 Sol. Les adresses qu'aurait ce modèle répondent par une erreur 404, et le dernier Sol au catalogue de l'API est gpt-6.1-sol, sorti le 29 septembre 2026.
Quels modèles, à quelle date, à quel prix ?
Les trois modèles partagent une fenêtre d'un million de jetons et un réglage de l'effort de réflexion, mais leurs dates, leurs prix et leurs plafonds de sortie diffèrent nettement. Le tableau reprend les valeurs publiées par chaque éditeur dans sa documentation, hors remises de traitement par lots.
| Caractéristique | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6.1 Sol |
|---|---|---|---|
| Éditeur | Anthropic | Google DeepMind | OpenAI |
| Sortie | 9 novembre 2026 | 28 octobre 2026 (accès restreint), ouvert le 10 novembre | 29 septembre 2026 |
| Identifiant API | claude-fable-5-2 | gemini-4-carbon | gpt-6.1-sol |
| Prix entrée / sortie (par million de jetons) | 8 $ / 40 $ | 2 $ / 10 $ jusqu'au 30 novembre, puis 4 $ / 20 $ | 2 $ / 10 $ |
| Lecture de cache (par million) | 0,20 $ | 0,10 $, puis 0,20 $ | 0,10 $ |
| Fenêtre de contexte | 1 million de jetons | 1 048 576 jetons | 1 050 000 jetons |
| Sortie maximale | 128 000 jetons | 65 536 jetons en appel synchrone | 128 000 jetons |
| Niveaux d'effort | low à max, high par défaut dans l'API | low, medium (défaut), high | low à max, medium par défaut |
| Connaissances arrêtées à | juin 2026 | mars 2026 | 30 avril 2026 |
Sources : documentation Anthropic, tarifs de l'API Gemini, fiche OpenAI de gpt-6.1-sol, relues le 12 novembre 2026.
Deux conditions changent la facture : chez OpenAI, une requête qui dépasse 272 000 jetons d'entrée est facturée deux fois plus cher en entrée et une fois et demie en sortie, tandis que chez Google le tarif de lancement de Carbon prend fin le 30 novembre 2026, et chaque prix par jeton double à partir du 1er décembre.
Que dit le classement Artificial Analysis ?
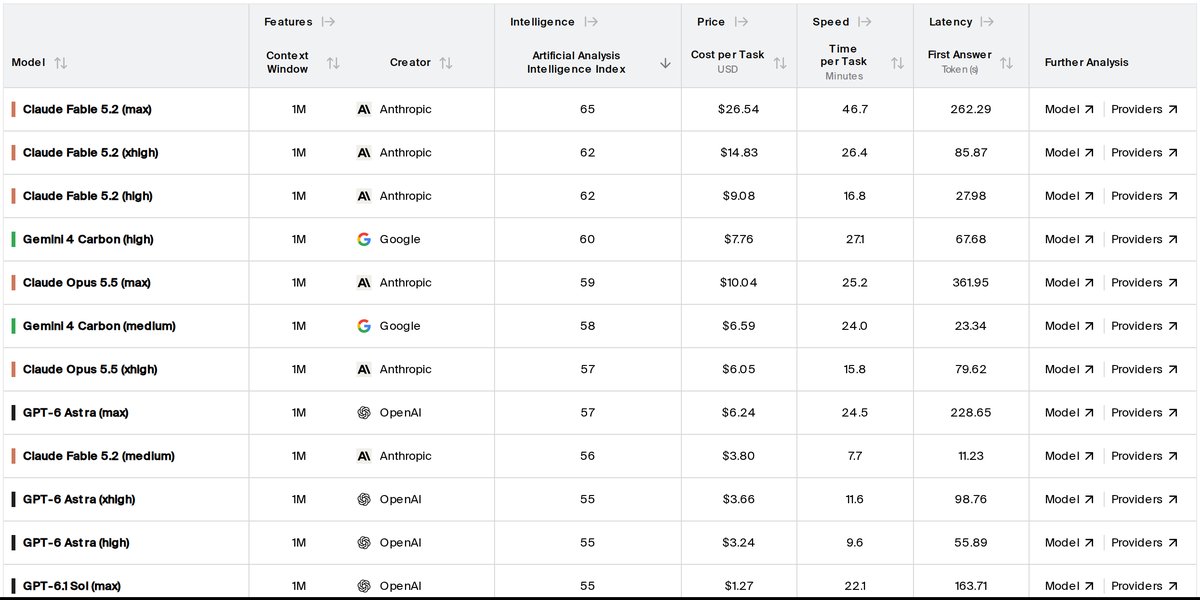
Artificial Analysis fait passer à chaque modèle neuf évaluations, dont Terminal-Bench 4.0, FrontierCode-AA 2.0, HLE-Diamond et AA-Briefcase, et en tire un indice unique, dont les trois fiches ci-dessous en résument l'essentiel pour la configuration la plus élevée de chaque modèle.
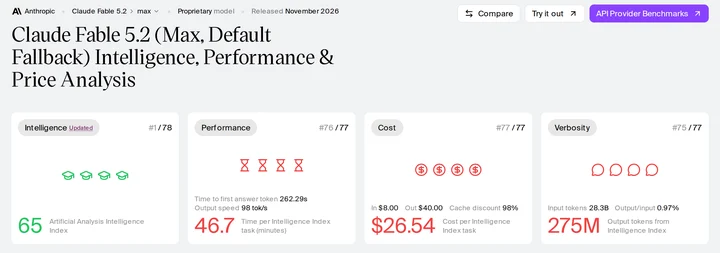
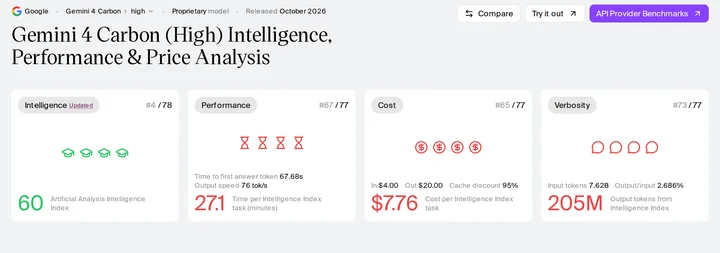
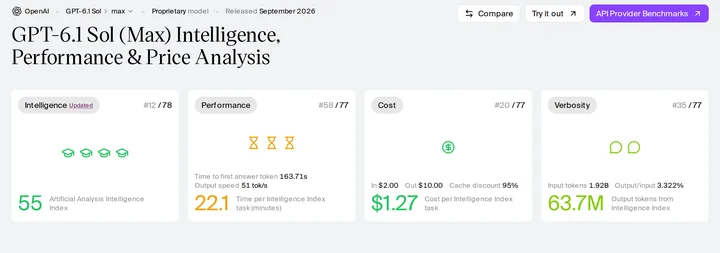
| Mesure Artificial Analysis | Fable 5.2 (max) | Carbon (high) | Sol (max) |
|---|---|---|---|
| Indice d'intelligence v5.0.1 | 65 | 60 | 55 |
| Rang sur 78 | 1er | 4e | 12e |
| Coût par tâche de l'indice | 26,54 $ | 7,76 $ | 1,27 $ |
| Temps par tâche | 46,7 min | 27,1 min | 22,1 min |
| Jetons de sortie sur l'indice | 275 millions | 205 millions | 63,7 millions |
| Vitesse de sortie | 98 jetons/s | 76 jetons/s | 51 jetons/s |
| Délai avant le premier jeton de réponse | 262,29 s | 67,68 s | 163,71 s |
Source : classement Artificial Analysis et fiches modèles, relevés du 12 novembre 2026.
Le délai avant le premier jeton de réponse inclut le temps de réflexion, ce qui explique que Fable, pourtant le plus rapide à écrire avec 98 jetons par seconde, fait attendre plus de quatre minutes avant sa première phrase en effort maximal ; pour un assistant conversationnel, ce délai compte davantage que la note.
Combien coûte une tâche, et à quel niveau d'effort ?
La note seule ne suffit pas à choisir, car chaque modèle se règle sur plusieurs niveaux d'effort qui déplacent à la fois le score et la facture. Le graphique place chaque configuration selon sa note et son coût moyen par tâche, sur une échelle logarithmique où chaque graduation multiplie le coût par dix.

Trois enseignements ressortent des chiffres, à commencer par Fable 5.2, qui obtient 62 en effort high comme en xhigh, mais pour 9,08 $ au lieu de 14,83 $ par tâche : monter d'un cran n'achète ici aucun point. Quant à Sol en effort max, il atteint 55 pour 1,27 $, soit un point de plus que Fable en effort low pour 2,4 fois moins cher.
Carbon présente une anomalie : en réflexion low, la tâche coûte 7,19 $, plus qu'en medium à 6,59 $, pour une note inférieure de quatre points, et Artificial Analysis calcule par ailleurs ces coûts au tarif de 4 $ et 20 $ par million. Jusqu'au 30 novembre, à 2 $ et 10 $, le même travail coûte deux fois moins, soit environ 3,88 $ par tâche en high, selon notre calcul.
DeepSWE : qui a publié quoi ?
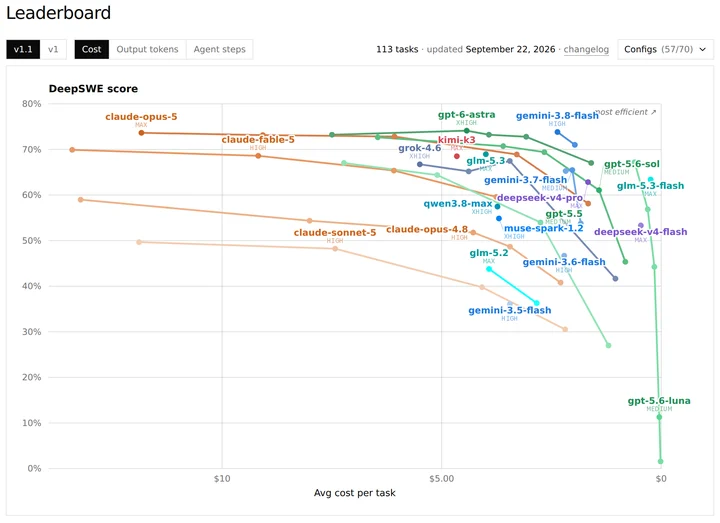
DeepSWE, conçu par Datacurve, mesure les agents de code sur 113 tâches longues écrites de zéro, dans 91 dépôts et cinq langages, en faisant tourner tous les modèles dans le même outil, mini-swe-agent, ce qui rend les scores comparables entre eux. Or son classement public, mis à jour le 22 septembre 2026, ne contient aucun des trois modèles de cet article.
| Modèle | Score DeepSWE v1.1 | Statut |
|---|---|---|
| Claude Fable 5.2 | 74,3 % | Déclaré par Anthropic dans la fiche système (section 8.3), moyenne de cinq essais, outil d'exécution non précisé |
| Gemini 4 Carbon | Non publié | Absent des billets, de la fiche modèle et du rapport de sécurité de Google |
| GPT-6.1 Sol | Non publié en valeur | OpenAI écrit seulement qu'il égale GPT-6 Astra pour environ un cinquième du coût |
| gpt-6-astra (xhigh), pour repère | 74 % ±3 | Mesuré par Datacurve, 4,43 $ par tâche |
| claude-fable-5 (xhigh), pour repère | 70 % ±3 | Mesuré par Datacurve, 13,41 $ par tâche |
Sources : classement DeepSWE, fiche système de Fable 5.2, annonce de GPT-6.1 Sol, relus le 12 novembre 2026.
Les 74,3 % de Fable 5.2 ne se comparent donc pas directement aux 74 % de GPT-6 Astra : le premier vient de l'éditeur, sur un outil qu'il ne nomme pas, le second de Datacurve sous mini-swe-agent. Tant que Datacurve n'a pas mesuré ces modèles lui-même, aucun classement DeepSWE de la génération de novembre ne tient.
Les bancs que publient les éditeurs
Les trois éditeurs publient des scores sur des bancs portant les mêmes noms, mais rarement dans la même configuration. Le tableau aligne ce qui l'est à peu près, avec la configuration déclarée ; une case vide signifie qu'aucune valeur n'est publiée, pas un mauvais résultat.
| Banc (déclaré par l'éditeur) | Fable 5.2 | Carbon | Sol |
|---|---|---|---|
| Terminal-Bench 4.0 | 67,6 % (effort max, dix essais) | 65,2 % (chiffre attribué par Google à Artificial Analysis) | Non publié |
| Terminal-Bench-Science 0.1 | 74,6 % | 64,8 % | Non publié en valeur (« plus du double » de GPT-6 Sol) |
| FrontierSWE 2 | 69,9 % | 61,2 % | Non publié |
| AutomationBench (mesuré par Zapier) | 51,4 % | 53,9 % | Non publié en valeur |
| OSWorld 2.1 | 89,3 % en score partiel, 54,6 % en strict | 81,5 % sur 82 tâches, meilleur de trois | Écart publié seulement, sur OSWorld 2.0 |
Sources : annonce d'Anthropic et fiche système, fiche modèle de Gemini 4 Carbon, annonce d'OpenAI, relues le 12 novembre 2026.
OSWorld illustre le piège : Fable passe de 89,3 % à 54,6 % selon que l'on compte les réussites partielles ou non, et Carbon est mesuré sur un sous-ensemble de 82 tâches en gardant le meilleur de trois essais, tandis qu'OpenAI publie des écarts relatifs sans valeur absolue, si bien que seul un tiers qui fait passer le même protocole aux trois tranche.
Ce que les éditeurs conseillent eux-mêmes
Aucun des trois éditeurs ne présente son modèle comme le choix par défaut : Anthropic recommande de commencer par Claude Opus 5.5 et de ne passer à Fable 5.2 qu'en cas de besoin, Google indique que Gemini 4 Argon reste conseillé pour la majorité des tâches, et OpenAI réserve GPT-6 Astra aux recherches scientifiques les plus difficiles.
Ces modèles sont donc des outils de pointe, à appeler sur les tâches qui les justifient. Le reste du travail se confie à un modèle moins cher, le routage entre les deux relevant de l'architecture plutôt que du choix d'un fournisseur unique, comme nous le détaillons dans notre article sur le routage entre modèles.
Données, conservation et souveraineté
Les trois modèles sont fermés : leurs poids ne sont pas téléchargeables, et chaque requête part chez l'éditeur ou chez un hébergeur cloud. Les conditions de traitement des données diffèrent pourtant, et elles pèsent plus que la note pour une entreprise soumise au RGPD ou à un secret professionnel.
- Fable 5.2 : Anthropic impose une conservation de 30 jours, sans conservation nulle sauf autorisation expresse. Des classifieurs bloquent la cybersécurité à haut risque et la plupart des tâches de recherche en biologie, et la requête est alors traitée par un modèle plus ancien.
- Gemini 4 Carbon : sur Google Cloud, le modèle est servi dans les régions
global,useteu, pour des clients entreprise vérifiés. - GPT-6.1 Sol : OpenAI propose un traitement régional facturé 10 % de plus. Sa fiche système le classe au niveau « Critical » en cybersécurité, avec les garde-fous de GPT-6 Astra.
L'écart avec les modèles à poids ouverts reste large, puisque le premier d'entre eux, Kimi K3.1 Pro, obtient 46 sur le même indice le 12 novembre 2026, soit 19 points sous Fable 5.2 et 9 sous GPT-6.1 Sol. En contrepartie, il s'héberge sur ses propres machines, ce que notre calculateur de mémoire permet de dimensionner.
Quel modèle pour quel usage ?
Les chiffres relevés permettent de proposer une première orientation, qui ne remplace pas un essai sur vos propres tâches. Le tableau associe chaque besoin à la configuration qui le sert le mieux selon les mesures d'Artificial Analysis, en rappelant la donnée qui fonde le choix.
| Besoin | Configuration | Donnée qui fonde le choix |
|---|---|---|
| Meilleure note possible, budget secondaire | Claude Fable 5.2 (max) | 65, premier sur 78, à 26,54 $ par tâche |
| Note élevée à coût maîtrisé | Claude Fable 5.2 (high) | 62 comme en xhigh, pour 9,08 $ au lieu de 14,83 $ |
| Meilleur rapport note sur prix | GPT-6.1 Sol (max) | 55 pour 1,27 $, une tâche vingt fois moins chère que Fable en max |
| Réponse rapide en conversation | Fable 5.2 (low) ou Sol (medium) | Premier jeton en 8,42 s et 4,54 s |
| Essai à moindre coût d'un modèle de pointe | Gemini 4 Carbon (high) avant le 30 novembre | 60, à tarif de lancement divisé par deux |
| Données qui ne doivent pas sortir | Modèle à poids ouverts hébergé sur site | Kimi K3.1 Pro à 46, sans transfert |
Source : classement Artificial Analysis, 12 novembre 2026. Orientation QDNA.
Les réserves déclarées
Chaque éditeur publie aussi ses faiblesses, et elles éclairent les usages à éviter. Nous retenons celles qui touchent directement un déploiement en entreprise, c'est-à-dire la fiabilité des réponses, les délais et le comportement en code, telles que décrites dans les fiches système et la documentation :
- Anthropic signale que Fable 5.2 peut terminer un tour avant la fin du travail, surtout en effort low et medium, et qu'il réfléchit même quand le prompt lui demande de s'en abstenir.
- Google prévient que Carbon consomme beaucoup de jetons en réflexion élevée et peut expirer : il conseille des délais client d'au moins 15 minutes. Artificial Analysis relève un taux d'erreur de l'API de 10,3 %.
- OpenAI mesure chez Sol un taux de mensonge sur le code de 1,50 %, contre 0,51 % pour GPT-6 Astra, et davantage de contournements de la récompense.
Points à surveiller
Quatre événements peuvent modifier ce comparatif dans les semaines qui viennent, qu'il s'agisse d'une mesure indépendante, d'un changement de tarif ou d'un nouveau modèle, et nous mettrons l'article à jour à chacun d'eux, en conservant une note datée de chaque changement :
- L'entrée des trois modèles au classement DeepSWE, seule mesure de code longue sur un outil commun.
- Le passage de Carbon au tarif plein le 1er décembre 2026, qui double son coût par tâche réel.
- Une éventuelle annonce d'un GPT-6.2 Sol, aujourd'hui inexistant chez OpenAI.
- Les mesures indépendantes par banc d'Artificial Analysis, qui permettront de comparer Terminal-Bench 4.0 sur un même protocole.
Questions fréquentes
Quel est le meilleur modèle d'IA en novembre 2026 ?
Sur l'indice indépendant d'Artificial Analysis (v5.0.1, relevé du 12 novembre 2026), Claude Fable 5.2 en effort maximal est premier avec 65, devant Gemini 4 Carbon en réflexion high à 60 et Claude Opus 5.5 à 59. GPT-6.1 Sol en effort maximal obtient 55 et se classe douzième.
GPT-6.2 Sol existe-t-il ?
Non. Au 12 novembre 2026, OpenAI n'a publié ni annonce, ni fiche système, ni entrée de catalogue pour un GPT-6.2 Sol, et les adresses qu'aurait ce modèle répondent par une erreur 404. Le dernier modèle de la lignée est GPT-6.1 Sol, sorti le 29 septembre 2026.
Combien coûte Claude Fable 5.2 ?
Anthropic facture 8 $ par million de jetons en entrée et 40 $ en sortie. Mesurée par Artificial Analysis, une tâche de son indice coûte 26,54 $ en effort maximal et 9,08 $ en effort high, pour une note de 62 identique à celle de l'effort xhigh.
Quel score DeepSWE pour Fable 5.2, Gemini 4 Carbon et GPT-6.1 Sol ?
Aucun des trois ne figure au classement public DeepSWE, mis à jour le 22 septembre 2026. Anthropic déclare 74,3 % pour Fable 5.2 dans sa fiche système, sans nommer l'outil d'exécution. Google ne publie aucun score, et OpenAI affirme seulement que Sol égale GPT-6 Astra pour environ un cinquième du coût.
Gemini 4 Carbon est-il moins cher que Claude Fable 5.2 ?
Oui. Carbon coûte 2 $ et 10 $ par million de jetons jusqu'au 30 novembre 2026, puis 4 $ et 20 $, contre 8 $ et 40 $ pour Fable 5.2. Calculée au tarif plein, une tâche de l'indice Artificial Analysis coûte 7,76 $ à Carbon en réflexion high et 26,54 $ à Fable en effort maximal.
Sources officielles
- Anthropic, annonce de Claude Fable 5.2 et Mythos 5.2, 9 novembre 2026
- Anthropic, fiche système de Claude Fable 5.2
- Anthropic, documentation du modèle Fable 5.2
- Google, annonce de Gemini 4 Carbon, 28 octobre 2026
- Google, ouverture générale de Gemini 4 Carbon, 10 novembre 2026
- Google DeepMind, fiche modèle de Gemini 4 Carbon
- Google, tarifs de l'API Gemini
- OpenAI, annonce de GPT-6.1 Sol, 29 septembre 2026
- OpenAI, fiche système de GPT-6.1 Sol
- OpenAI, fiche API de gpt-6.1-sol
- Artificial Analysis, classement des modèles et classement des modèles ouverts
- Datacurve, classement DeepSWE v1.1