Moteur d'inférence LLM : comparatif vLLM, SGLang, TensorRT-LLM, llama.cpp et Dynamo en 2026
Le moteur d'inférence décide de la vitesse, de la latence et du coût de vos modèles autant que le matériel lui-même. En 2026, vLLM, SGLang, TensorRT-LLM, Dynamo et llama.cpp occupent le terrain avec des compromis très différents. Ce comparatif rassemble les mesures publiées, leurs conditions exactes, et les critères de choix par plateforme.
Qu'est-ce qu'un moteur d'inférence LLM et que fait-il vraiment ?
Un moteur d'inférence est le logiciel qui orchestre l'exécution d'un modèle : il traite le prefill, génère les jetons en décodage, gère le cache KV, regroupe les requêtes en lots et déclenche la spéculation. Le modèle et le GPU ne suffisent pas, car deux moteurs sur la même carte affichent des écarts d'un facteur trois selon Tom's Hardware.
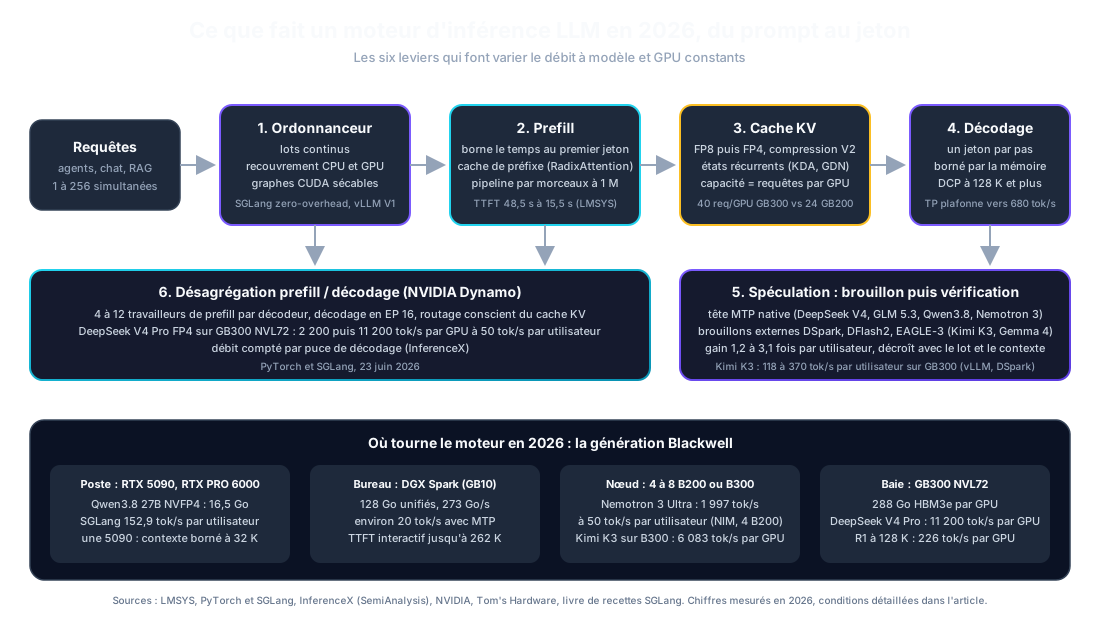
Concrètement, l'inférence se décompose en deux phases au profil matériel opposé. Le prefill absorbe l'invite entière et sature les calculs matriciels du processeur. Le décodage produit les jetons un à un et sature surtout la bande passante mémoire. Le moteur doit donc arbitrer en permanence entre ces deux régimes, décider quand entrelacer un nouveau prefill dans le flux de décodage, et conserver le cache KV des séquences pour éviter de recalculer les préfixes déjà vus. L'ordonnancement par lots continus (continuous batching) transforme ces arbitrages en gains de débit mesurables. La prédiction multi-jetons (MTP) et le décodage spéculatif ajoutent une couche de paris : un brouillon rapide propose plusieurs jetons, le modèle principal les valide en une passe, et la longueur acceptée détermine le gain réel.
Deux moteurs exécutant le même modèle sur la même carte peuvent ainsi diverger fortement. Le comparatif Jarvislabs de mai 2026 sur H100 montre des écarts de temps au premier jeton allant du simple au quadruple selon le moteur. Le choix du moteur est donc une décision d'architecture, pas un détail de configuration.
Quels moteurs d'inférence comparer en 2026 ?
Six moteurs d'inférence se dégagent en 2026, vLLM, SGLang, TensorRT-LLM, NVIDIA Dynamo, llama.cpp et Ollama, dont cinq sous licence Apache 2.0 ou MIT, et ils se distinguent surtout par la spéculation prise en charge, le cache de préfixe, la désagrégation, les formats de poids acceptés et la vitesse de prise en charge des modèles du moment.
| Moteur | Versions 2026 | Spéculation | Cache de préfixe | Désagrégation | Formats | Modèles 2026 servis au jour de sortie | Licence |
|---|---|---|---|---|---|---|---|
| vLLM | 0.22 à 0.28, moteur V1 | MTP natif, EAGLE-3, DFlash, DFlash2, DSpark | Automatique, hybride pour les états récurrents (Kimi K3) | Via Dynamo et NIXL | FP8, NVFP4, MXFP4, AWQ | DeepSeek V4, Kimi K3, Nemotron 3 Ultra, Qwen3.8, GLM 5.3 (0.28) | Apache 2.0 |
| SGLang | 0.5.15 (juillet) à 0.5.20 (18/09/2026) | EAGLE (têtes MTP), DSpark, DFlash2 | RadixAttention, HiCache, arbre radix unifié | Oui, avec Dynamo, pipeline par morceaux au prefill, DCP au décodage | FP8, NVFP4 W4A4, MXFP4 MegaMoE | DeepSeek V4 (jour 0), Kimi K3, GLM 5.3, Qwen3.8 27B (202 configurations mesurées) | Apache 2.0 |
| TensorRT-LLM | 1.2 | MTP (trois têtes sur Nemotron 3 Super) | Oui | Oui | FP8, NVFP4 | Nemotron 3 Ultra ; DeepSeek V4 Pro corrigé au neuvième jour (SemiAnalysis) | Apache 2.0 |
| NVIDIA Dynamo | 1.5 (septembre 2026) | Celle du moteur orchestré | Routage conscient du cache KV | Orchestrateur dédié, pools prefill et décodage | Au-dessus de vLLM, SGLang, TRT-LLM | Voie GB300 NVL72 d'InferenceX | Apache 2.0 |
| llama.cpp | b9330 à b9549 (mai 2026) | MTP depuis le 16/05/2026, EAGLE-3, DFlash, DSpark, n-grammes | Oui, par emplacements | Non | GGUF, NVFP4 | Qwen3.6 et 3.8, Gemma 4 avec brouillon | MIT |
| Ollama | 2026 | Celle de llama.cpp, étiquettes Gemma 4 MTP | Celle de llama.cpp | Non | GGUF | Suit llama.cpp avec retard | MIT |
Ollama reste une surcouche de llama.cpp commode pour démarrer, mais Red Hat, cité par Towards AI en juillet 2026, mesure un écart de débit d'un facteur dix-neuf face à vLLM en charge. Dynamo n'exécute pas lui-même les modèles : il répartit les phases de prefill et de décodage sur des processeurs distincts et route les requêtes selon le contenu du cache KV. TensorRT-LLM impose une compilation d'environ 28 minutes selon Spheron, et SemiAnalysis raconte qu'une constante de taille cachée figée à 4 096 a corrompu les sorties de DeepSeek V4 Pro pendant neuf jours avant correction, quand vLLM et SGLang servaient le modèle dès sa publication.
Quelles nouveautés 2026 changent le choix du moteur ?
Les nouveautés 2026 déplacent la concurrence des noyaux vers la spéculation à longueur variable, la gestion des états récurrents et la désagrégation : DSpark et DFlash2 côté brouillons, arbre radix unifié et HiCache côté cache, parallélisme de contexte au décodage et W4A4 côté Blackwell. Chaque fonction a une date de fusion et une mesure publiée.
- Spéculation à vérification variable. DSpark, publié par DeepSeek en juillet 2026 puis intégré à SGLang le 6 juillet et à vLLM pour Kimi K3 le 27 juillet, ajuste la longueur vérifiée par requête selon la confiance du brouillon : LMSYS mesure sur Kimi K3 un gain de 68 pour cent à lot 256 en conversation et de 24 pour cent en mathématiques par rapport à la vérification complète. Les têtes FastMTP de Red Hat, depuis Speculators 0.6 et vLLM 0.24, réentraînent la tête MTP pour le tirage récursif.
- Cache pour architectures hybrides. vLLM a reconstruit le 27 juillet 2026 son cache de préfixe pour les états récurrents de Kimi K3 (69 couches KDA pour 24 couches MLA), ce qui bénéficie à Qwen3.8 et GLM 5.3 Flash ; SGLang déplace les états KDA par copie à l'écriture et instantanés, et propose en option une mémoire unifiée où états et blocs KV puisent dans une même réserve.
- Arbre radix unifié et HiCache. Les notes de version SGLang 2026 font passer le taux de réutilisation du cache de 43,8 à 60,8 pour cent et le temps moyen au premier jeton de 1,57 à 1,07 seconde, tandis que HiCache étage le cache KV entre HBM, mémoire hôte et disque pour les agents à conversations longues.
- Blackwell exploité en FP4. Le chemin W4A4 MegaMoE de SGLang, actif depuis le 2 juin 2026 sur DeepSeek V4, quantifie aussi les activations en MXFP4 ; les noyaux de compression du cache KV en version 2 et la fusion du chemin MHC réduisent le surcoût de prefill de DeepSeek V4 ; le parallélisme de contexte au décodage (DCP) dépasse le plafond du parallélisme tensoriel à 128 000 jetons sur huit B200.
- Ordonnancement sans bulle. Les graphes CUDA sécables du prefill DeepSeek V4, l'ordonnanceur à recouvrement de SGLang et le moteur V1 de vLLM suppriment les temps morts entre pas ; ReplaySSM réduit la mémoire de brouillon des modèles à états de 11,5 à 1,8 Go selon les notes SGLang.
- Poste de travail. llama.cpp a fusionné la prédiction multi-jetons le 16 mai 2026, puis les brouillons EAGLE-3, DFlash et DSpark, et Google publie depuis le 5 mai 2026 des brouillons MTP pour toute la famille Gemma 4, annoncés jusqu'à trois fois plus rapides et repris par vLLM, SGLang, MLX et Ollama.
Que disent les benchmarks 2026 sur Blackwell et sur les modèles récents ?
Les benchmarks 2026 sur Blackwell montrent qu'à interactivité fixée le débit par GPU dépend d'abord de la recette de service, désagrégation, parallélisme d'experts et spéculation, puis du moteur : DeepSeek V4 Pro passe de 2 200 à 11 200 jetons par seconde par GPU sur GB300 NVL72 en deux mois avec le même SGLang.
| Source et date | Modèle et matériel | Moteur et conditions | Résultat mesuré |
|---|---|---|---|
| PyTorch et SGLang, 23/06/2026 (InferenceX) | DeepSeek V4 Pro 1,6 T en FP4, GB300 NVL72 | Dynamo et SGLang désagrégés, MTP, 8 000 jetons d'entrée, 1 000 de sortie | Environ 11 200 tok/s par GPU à 50 tok/s par utilisateur, contre 2 200 au jour 0 ; débit compté par puce de décodage |
| InferenceX, 16/08/2026 | Kimi K3 2,8 T en FP4, B300 | vLLM, charge agentique AgentX, onze configurations | 7 855 tok/s par GPU à 30 tok/s par utilisateur, 6 083 à 50, 4 051 à 100, pic 12 566 ; 0,10 dollar par million de jetons à 50 |
| InferenceX, 2026 | GLM 5 et 5.1 744 Md en FP4, B200 et MI355X | SGLang, 8 000 d'entrée, 1 000 de sortie | B200 : 1 756 tok/s par GPU à 32 tok/s par utilisateur, 1 004 à 71 ; MI355X : 1 369 et 709 |
| LMSYS, 19/02/2026 | DeepSeek R1 NVFP4, GB300 NVL72 contre GB200 | SGLang et Dynamo, 128 000 d'entrée, 8 000 de sortie | 226,2 tok/s par GPU (1,53 fois GB200) ; avec MTP, 224,2 par GPU et 43 tok/s par utilisateur au lieu de 23 ; TTFT 8,6 s |
| Notes de version SGLang, été 2026 | GLM 5.2 NVFP4 sur 8 B300 et 4 GB300 ; DeepSeek V4 Pro sur 8 B300 | Lot unitaire ; DSpark pour V4 Pro | Plus de 500 tok/s par utilisateur sur 8 B300, 450 sur 4 GB300 ; 383,7 tok/s avec DSpark sur V4 Pro |
| Lambda, juin 2026 | Nemotron 3 Ultra 550 Md, 4 Blackwell | 8 192 d'entrée, 65 536 de sortie, 512 invites, 256 simultanées | TensorRT-LLM 3 404 tok/s (13,3 par utilisateur), SGLang 2 363 (9,23), vLLM 0.22 2 305 provisoire (450 requêtes sur 512) |
| NVIDIA, 10/09/2026 | Nemotron 3 Ultra, 4 B200 | NIM 2.0.12, 64 000 d'entrée, 400 de sortie, 76 pour cent de préfixes réutilisés, 50 tok/s par utilisateur | 718 puis 1 997 tok/s, soit 2,5 fois, par noyaux autoréglés, réutilisation d'état Mamba et MTP |
| MLPerf Inference v6.0, avril 2026 | 8 B300 ; 8 MI355X ; 288 GB300 | Scénario serveur | Llama 2 70B : 107 317 tok/s sur 8 B300, 100 282 sur 8 MI355X ; DeepSeek R1 : 42 721 sur 8 B300, 1,55 million sur 288 GB300 |
Trois enseignements ressortent de ces mesures. D'abord, le même moteur gagne un facteur cinq en huit semaines sur un modèle neuf, si bien que la date de la mesure compte autant que le moteur : la voie GB300 d'InferenceX est passée de MTP à DSpark en septembre 2026 et les courbes bougent encore. Ensuite, la structure des invites décide du classement : Spheron mesure moins de 5 pour cent d'écart entre vLLM, SGLang et TensorRT-LLM sur invites uniques, alors que The AI Engineer mesure 29 pour cent de débit supplémentaire pour SGLang, 16 200 contre 12 500 jetons par seconde, dès que plus de 60 pour cent des préfixes se partagent, ce qui est le régime des agents. Enfin, les comparaisons Hopper restent un repère utile mais daté : sur H100, Jarvislabs plaçait en mai 2026 vLLM devant sur invites uniques (23 523 jetons par seconde contre 16 787 pour SGLang et 16 517 pour TensorRT-LLM sur Qwen2.5-7B) et SGLang devant en latence par jeton sur RULER 16K (63,2 contre 96,7 millisecondes), avec un débit plat de 553 à 582 jetons par seconde dès soixante requêtes, signe que le prefill sature avant le moteur.
Sur serveurs Blackwell, la mesure Lambda confirme la maturité de TensorRT-LLM sur le matériel de son éditeur pour Nemotron 3 Ultra, tandis que le chiffre provisoire de vLLM 0.22, 450 requêtes terminées sur 512, illustre la jeunesse de la prise en charge de ce modèle hybride Mamba au moment du test. Le rapport technique de Nemotron 3 Ultra annonce jusqu'à six fois le débit des modèles ouverts concurrents à précision NVFP4 sur GB200, mais compare TensorRT-LLM pour lui-même à vLLM pour les autres, ce qui interdit d'y lire une comparaison de moteurs à recette constante.
Que change la prédiction multi-jetons selon le moteur et le modèle ?
La prédiction multi-jetons accélère un utilisateur seul d'un facteur 1,2 à 3,1 selon le moteur, le modèle et le brouillon employé, puis son gain se dissipe à mesure que le lot et le contexte grandissent. Le taux d'acceptation par position décide du bénéfice, et les mesures publiées conduisent à régler deux ou trois jetons spéculatifs plutôt que cinq.
Les têtes MTP natives se comportent différemment d'une famille de modèles à l'autre, ce que Red Hat a mesuré le 8 septembre 2026 avec vLLM 0.24, Speculators 0.6 et deux H200 sur Qwen3-Next-80B : l'acceptation par position vaut 0,897, 0,719 puis 0,476, et un affinage FastMTP la porte à 0,912, 0,776 et 0,616, pour un gain de latence inter-jetons médiane pouvant atteindre 1,25 fois. Le rapport technique de Nemotron 3 Ultra du 9 juin 2026 donne une longueur d'acceptation moyenne de 4,387 avec un brouillon de sept jetons sur SPEED-Bench, portée à 4,584 par son procédé de renforcement de la tête, quand DeepSeek V4 Flash reste à 2,667 dans le même protocole.
Les brouillons génériques rivalisent désormais avec les têtes natives, puisque DSpark, publié par DeepSeek dans l'article arXiv 2607.05147 de juillet 2026, annonce en production 60 à 85 pour cent de vitesse supplémentaire par utilisateur face à la référence MTP à une tête. SGLang a mesuré le 6 juillet 2026 un débit de 383,7 jetons par seconde à lot unitaire sur DeepSeek V4 Pro en parallélisme tensoriel sur huit B300, et vLLM a fait passer Kimi K3 de 118 à 370 jetons par seconde par utilisateur, soit 3,14 fois, sur seize GPU GB300 le 27 juillet 2026, avec une longueur acceptée de 4,73 en code contre 2,61 en écriture créative. Ce dernier point mérite d'être souligné, car le fichier de configuration de Kimi K3 ne déclare aucune tête MTP native : la vitesse vient entièrement d'un brouillon externe entraîné par l'éditeur du moteur.
Le billet du blog vLLM du 23 août 2026, mesuré sur MI300X et MI355X, situe les gains entre 2,20 fois pour la tête native de Qwen3.5-122B-A10B sur MATH500 et 2,87 fois pour le brouillon DFlash sur Gemma 4 26B-A4B, avec 2,83 fois pour le brouillon MTP de Gemma. Du côté des postes de travail, llama.cpp a fusionné la prédiction multi-jetons le 16 mai 2026 dans la demande de fusion 22673 : sur Qwen3.6 27B et une RTX PRO 6000, Jarvislabs passe de 45,76 à 79,37 jetons par seconde, soit 1,73 fois, alors qu'un modèle à experts 35B-A3B ne gagne que 1,17 fois parce qu'une fraction seulement de ses paramètres travaille à chaque jeton.
Les limites apparaissent dès que la charge monte, comme le montre la mesure d'un contributeur du forum NVIDIA en mai 2026 sur DGX Spark en Q4_K_M avec cinq brouillons : 28,3 jetons par seconde à une requête contre 13,1 sans MTP, mais 29,9 contre 41,5 à quatre requêtes simultanées, car la vérification des brouillons consomme le calcul que le lot aurait utilisé. Une discussion Hugging Face sur Qwen3.8-27B-FP8 confirme le piège du réglage : avec cinq jetons spéculatifs, l'acceptation par position tombe à 0,702, 0,298, 0,149, 0,085 et 0,085, la longueur acceptée plafonne à 2,32 et le débit s'effondre à 23 jetons par seconde sur RTX PRO 6000, d'où la recommandation de s'arrêter à deux ou trois jetons. Le ticket vLLM 47602 documente enfin que l'acceptation décroît avec la longueur du contexte sur Qwen3.6-27B, et le ticket llama.cpp 23752 une régression allant jusqu'à 28 pour cent sur Apple Metal.
Comment le débit évolue-t-il avec le contexte et le nombre d'utilisateurs ?
Le débit sature d'abord au prefill quand le contexte s'allonge, puis bute sur la capacité mémoire par requête quand la concurrence augmente, ce qui pousse les moteurs vers le pipeline par morceaux, le parallélisme de contexte au décodage et la désagrégation prefill/décodage. Sous charge, le temps au premier jeton devient la contrainte qui compte, bien avant le débit brut.
LMSYS a montré le mur du prefill le 15 janvier 2026 avec le parallélisme de pipeline par morceaux de SGLang : sur DeepSeek V3.1 à un million de jetons, le temps au premier jeton passe de 48,5 secondes en PP1 TP8 à 15,5 secondes en PP4 TP8, pour un débit de prefill multiplié par 3,31, tandis que Qwen3-235B-A22B en FP8 réclame encore 420,91 secondes à un million de jetons en PP8 TP4 contre 10,54 secondes à 128 000. Le 19 février 2026, la même équipe a mesuré DeepSeek R1 en NVFP4 sur GB300 NVL72 avec 128 000 jetons d'entrée et 8 000 de sortie : 226,2 jetons par seconde et par GPU, la prédiction multi-jetons conservant 224,2 jetons par seconde et par GPU tout en portant chaque utilisateur de 23 à 43 jetons par seconde. La capacité de décodage atteint 40 requêtes par GPU avec 288 Go de mémoire contre 24 avec 192 Go, à raison de 35 136 octets de cache KV par jeton, et le temps au premier jeton tient à 8,6 secondes pour 128 000 jetons grâce à des morceaux dynamiques de 32 000.
Le décodage possède sa propre limite, puisque les notes de version 2026 de SGLang indiquent qu'à 128 000 jetons d'entrée sur huit B200 le parallélisme tensoriel plafonne vers 680 jetons par seconde, alors que le parallélisme de contexte au décodage continue de monter avec la concurrence. La désagrégation se combine à la spéculation : le billet commun de PyTorch et SGLang du 23 juin 2026 mesure environ 11 200 jetons par seconde et par GPU sur DeepSeek V4 Pro en FP4, avec 8 000 jetons d'entrée et 1 000 de sortie, sur GB300 NVL72 orchestré par Dynamo avec MTP, contre 2 200 au jour de la sortie du modèle, soit cinq fois plus à 50 jetons par seconde par utilisateur. InferenceX compte toutefois ce débit par puce de décodage et non par puce totale, précision indispensable avant de comparer des offres.
Deux mises en garde ferment la boucle. L'article arXiv 2605.24217 de mai 2026 démontre qu'un client de mesure Python à processus unique gonfle artificiellement le temps au premier jeton et la latence par jeton sous forte charge, et propose la métrique NTPOT pour amortir le prefill et l'ordonnancement. SiliconBench, arXiv 2609.19169 du 12 septembre 2026, mesure sur DGX Spark une montée de 4,3 à 7,7 fois entre une et seize requêtes simultanées pour vLLM CUDA et SGLang, avec un temps au premier jeton stable, quand le débit de llama.cpp s'aplatit en charge agentique.
Quel moteur choisir sur une RTX 5090, un DGX Spark ou un serveur Blackwell ?
Sur poste de travail, SGLang mène aujourd'hui sur une RTX 5090 seule et vLLM l'emporte sur deux RTX 5090 en contexte long, tandis que les serveurs Blackwell favorisent TensorRT-LLM ou le couple SGLang et Dynamo selon la date de sortie du modèle. Mesurez sur vos propres invites avant de choisir, car les goulots logiciels pèsent davantage que la capacité mémoire.
Tom's Hardware a passé Qwen3.8 27B au banc le 8 septembre 2026 sur plusieurs plateformes : une RTX 5090 sous vLLM délivre 20 jetons par seconde sans MTP avec un contexte plafonné à 32 000 jetons, alors que SGLang tourne presque trois fois plus vite que vLLM sur cette même carte. Deux RTX 5090 sous vLLM tiennent 70 à 80 jetons par seconde sur tout le balayage de contexte et 100 à 110 avec MTP, tandis que llama.cpp affiche un temps au premier jeton d'environ trente minutes à long contexte sur RTX 5090, et qu'un DGX Spark se contente d'environ 20 jetons par seconde avec MTP tout en restant interactif jusqu'au contexte natif de 262 144 jetons.
La quantification change l'arithmétique, comme le documente le livre de recettes SGLang v0.5.19 avec 202 configurations mesurées sur RTX 5090, RTX PRO 6000 et DGX Spark : NVFP4 avec EAGLE atteint 152,9 jetons par seconde par utilisateur sur RTX 5090 en état FP32 contre 144,5 en BF16, et les poids passent de 28,5 Go en FP8 à 16,5 Go en NVFP4. La recette vLLM pour deux RTX 5090 annonce 445 875 jetons de capacité de cache KV à 262 000 jetons de contexte en NVFP4, avec une acceptation MTP de 0,897. Sur les grappes Blackwell, TensorRT-LLM a mené la mesure Lambda sur Nemotron 3 Ultra, tandis que SGLang avec Dynamo a fourni le quintuplement mesuré par PyTorch sur DeepSeek V4 Pro : alignez le moteur sur le support au jour de sortie de votre modèle.
Questions fréquentes
Faut-il déployer vLLM ou SGLang ?
Les deux servent les modèles 2026 dès leur sortie et se tiennent à moins de 5 pour cent sur invites uniques selon Spheron. Préférez SGLang quand les invites partagent des préfixes ou dépassent 128 000 jetons, car son arbre radix unifié et le DCP y gagnent, et vLLM pour sa couverture de brouillons et de matériels.
TensorRT-LLM est-il plus rapide que vLLM ?
Parfois. Spheron mesure 2 100 jetons par seconde pour TensorRT-LLM 1.2.0 contre 1 850 pour vLLM 0.18 sur Llama 3.3 70B FP8 et une H100, et Lambda le place en tête sur Nemotron 3 Ultra. Prévoyez environ 28 minutes de compilation par moteur avant la première requête.
Faut-il activer la prédiction multi-jetons dans llama.cpp ?
Oui à faible concurrence. Sur Qwen3.6 27B et RTX PRO 6000, le débit passe de 45,76 à 79,37 jetons par seconde avec MTP. Sur DGX Spark, la tendance s'inverse à quatre requêtes simultanées, 29,9 contre 41,5, et Apple Metal régresse jusqu'à 28 pour cent.
Qu'est-ce que la désagrégation prefill/décodage ?
Elle exécute le prefill et le décodage sur des groupes de GPU distincts, chacun adapté à la charge de sa phase. Dynamo route les requêtes selon le contenu du cache KV, et PyTorch mesure environ 11 200 jetons par seconde par GPU sur DeepSeek V4 Pro et GB300 NVL72 avec SGLang et MTP.
Combien de jetons spéculatifs faut-il configurer ?
Deux ou trois. Une discussion Hugging Face sur Qwen3.8-27B-FP8 mesure une acceptation qui tombe à 0,149 et moins après la troisième position, pour une longueur acceptée de 2,32. Les brouillons supplémentaires coûtent du calcul sans ajouter de jetons acceptés.
Quel moteur convient à une seule carte grand public ?
SGLang sur une RTX 5090, que Tom's Hardware mesure presque trois fois plus rapide que vLLM sur Qwen3.8 27B. Gardez llama.cpp pour les archives GGUF et le repli processeur, en acceptant un long temps au premier jeton dès que le contexte s'allonge.
Sources officielles
- Jarvislabs, comparatif vLLM, SGLang et TensorRT-LLM sur H100 : jarvislabs.ai
- Spheron, benchmarks vLLM, TensorRT-LLM et SGLang : spheron.network
- Lambda, mesures d'inférence de Nemotron 3 Ultra : lambda.ai
- Red Hat, têtes FastMTP pour le décodage spéculatif de vLLM : developers.redhat.com
- vLLM, décodage spéculatif sur GPU AMD : vllm.ai
- vLLM, prise en charge de Kimi K3 et brouillon DSpark : vllm.ai
- LMSYS, parallélisme de pipeline par morceaux pour le contexte long : lmsys.org
- LMSYS, DeepSeek en contexte long sur GB300 NVL72 : lmsys.org
- LMSYS, DSpark dans SGLang : lmsys.org
- PyTorch et SGLang, DeepSeek V4 sur GB300 : pytorch.org
- DeepSeek, DSpark (arXiv 2607.05147) : arxiv.org
- arXiv 2605.24217, biais de mesure des clients de benchmark et métrique NTPOT : arxiv.org
- SiliconBench, arXiv 2609.19169 : arxiv.org
- Tom's Hardware, Qwen 3.8 27B sur RTX 5090 et au-delà : tomshardware.com
- SGLang, livre de recettes Qwen3.8 27B : docs.sglang.io
- vLLM, recette Qwen3.8 27B sur RTX 5090 : recipes.vllm.ai
- InferenceX (SemiAnalysis), Kimi K3 sur B300 : inferencex.semianalysis.com
- InferenceX (SemiAnalysis), GLM 5 et 5.1 sur B200 et MI355X : inferencex.semianalysis.com
- InferenceX (SemiAnalysis), DeepSeek V4 du jour 0 au jour 43 : inferencex.semianalysis.com
- NVIDIA, optimisations NIM sur Nemotron 3 Ultra : developer.nvidia.com
- LMSYS, prise en charge de Kimi K3 au jour 0 : lmsys.org
- Nebius, résultats MLPerf Inference v6.0 : nebius.com
- Google, brouillons MTP pour Gemma 4 : blog.google
- SGLang, notes de version : github.com
- NVIDIA, rapport technique Nemotron 3 Ultra : research.nvidia.com
- Forum NVIDIA, MTP dans llama.cpp sur Qwen3.6 27B et DGX Spark : forums.developer.nvidia.com
Choisir et régler votre moteur d'inférence
Un échange sans engagement pour mesurer vos invites réelles, choisir le moteur adapté à votre matériel et régler la spéculation et le cache.
Réserver un échange