Chatbot IA et RGPD : les quatre obligations qui se règlent dans l'architecture
Un chatbot interne paraît anodin : une zone de texte, un modèle, une réponse. C'est pourtant le traitement dont le périmètre est défini par ses utilisateurs et non par son concepteur, ce qui déplace la conformité du contrat vers l'architecture.
Mis à jour le 26 septembre 2026 : Passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Qu'est-ce qui distingue un chatbot des autres traitements ?
Un chatbot interne paraît anodin : une zone de texte, un modèle, une réponse. Il concentre pourtant trois particularités qui le rendent nettement plus sensible qu'un formulaire ordinaire, et qui expliquent pourquoi sa conformité ne se règle pas comme celle d'un traitement classique.
L'utilisateur y verse ce qu'il veut. Un formulaire contraint ses champs, mais une conversation n'impose aucune limite. Un collaborateur y collera donc un extrait de contrat, un compte rendu d'entretien, le nom d'un client mécontent, parfois une donnée de santé.
Le périmètre du traitement est donc défini par les utilisateurs, et non par le concepteur. Il devient impossible de le documenter après coup avec exactitude, ce qui impose de le cadrer avant l'ouverture du service, quand les usages ne sont encore que des hypothèses.
La conversation est conservée par défaut, parce qu'un historique améliore l'expérience et que la quasi-totalité des déploiements l'activent. Cet historique constitue pourtant un fichier de données personnelles à part entière, que le registre des traitements oublie souvent : personne ne l'a décidé, il est apparu comme un effet de bord de la bibliothèque retenue.
La réponse peut se tromper avec aplomb. Un moteur de recherche qui ne trouve rien l'annonce, alors qu'un modèle de langage produit une réponse plausible même sans rien avoir trouvé. Si le chatbot répond sur les congés, la paie ou une procédure interne, l'erreur a des conséquences concrètes, et la question de l'intervention humaine se pose aussitôt.
Obligation 1 : dire que c'est une machine
La transparence constitue l'obligation la moins exigeante à satisfaire, et pourtant celle que les projets bâclent le plus souvent. Elle ne se satisfait pas d'une mention en pied de page : l'information doit être accessible au moment où la personne interagit.
Concrètement, trois éléments doivent être visibles dans l'interface elle-même : le fait que l'interlocuteur est un système automatisé, ce que deviennent les messages envoyés, et comment joindre un humain. Le règlement européen sur l'IA renforce cette exigence pour les systèmes qui interagissent directement avec des personnes physiques.
Le détail qui fait la différence en audit : la mention doit survivre à l'intégration. Un chatbot embarqué dans un outil métier, une messagerie interne ou un widget perd souvent son bandeau d'information en cours de route. C'est donc le composant lui-même qui doit porter la mention d'information, et non la page d'accueil du portail qui l'héberge.
Quelle base légale choisir avant l'outil pour un chatbot interne ?
Pour un chatbot interne, la base légale la plus courante est l'intérêt légitime de l'employeur, et non le consentement du salarié, dont la validité reste fragile dans une relation hiérarchique. Ce choix n'est pas un détail de formulaire. Il conditionne les droits que vous devrez servir et la mise en balance que vous devrez documenter.
Deux dérives reviennent systématiquement, et toutes deux transforment la nature du traitement sans que personne l'ait décidé :
- Le glissement de finalité. Un assistant déployé pour répondre aux questions RH devient, six mois plus tard, une source d'indicateurs sur l'activité des équipes. C'est une finalité nouvelle, qui exige sa propre analyse, et qui, si elle permet d'évaluer des personnes, change la nature du traitement.
- Le réentraînement implicite. Utiliser les conversations pour améliorer le modèle est une finalité distincte de celle d'y répondre. Si le fournisseur le fait par défaut, c'est un traitement que vous n'avez pas décidé mais dont vous répondez.
Obligation 3 : limiter ce qui reste
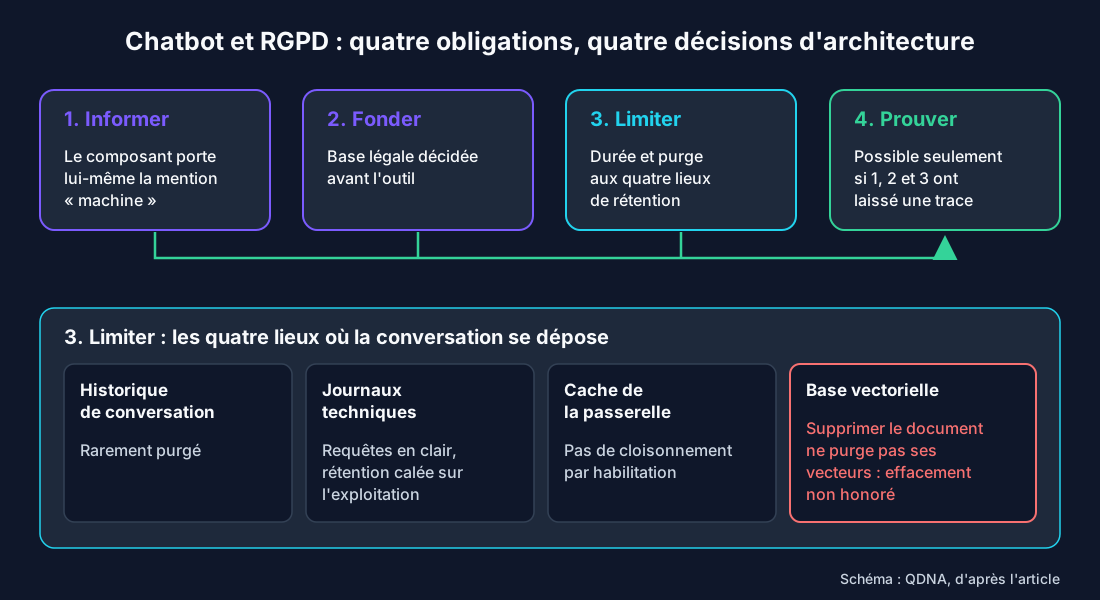
C'est ici que l'architecture décide et que les bonnes intentions cessent de suffire. Un chatbot laisse des traces à quatre endroits distincts, et la plupart des projets ne documentent que le premier, la base de connaissances.
| Où | Ce qui s'y trouve | Ce qu'on oublie |
|---|---|---|
| Historique de conversation | Messages, pièces jointes, réponses | Rarement purgé ; le seul point que le registre mentionne |
| Journaux techniques | Requêtes complètes, souvent en clair | Durée de rétention alignée sur l'exploitation, pas sur le RGPD |
| Cache de la passerelle | Réponses réutilisées entre appels | Cloisonnement par habilitation absent |
| Base vectorielle | Extraits de documents indexés | La suppression d'un document source ne purge pas les vecteurs |
Le dernier point de ce tableau est aussi le plus coûteux à corriger après coup. Si un document est retiré parce qu'il n'aurait jamais dû être indexé, ses fragments restent interrogeables tant que l'index n'a pas été reconstruit ou purgé de façon sélective.
Une demande d'effacement portant sur ce document ne sera donc pas honorée, alors même que l'équipe est convaincue du contraire. Le sujet est traité plus dans une large mesure dans notre guide du RAG en entreprise.
Obligation 4 : prouver, ce qui suppose d'avoir conçu pour
Les trois obligations précédentes ne valent que si elles se démontrent, et quatre artefacts y suffisent. Encore faut-il les construire pendant le projet plutôt qu'après sa mise en service, quand les choix ne se retracent plus.
- Le registre, qui inclut les quatre lieux de rétention du tableau ci-dessus et pas seulement l'historique visible.
- L'analyse d'impact, lorsque le chatbot traite des données sensibles ou permet d'évaluer des personnes. Le doute doit conduire à la faire, son absence étant plus difficile à justifier que son contenu.
- La cartographie des sous-traitants : quel modèle, hébergé où, sous quel contrat, avec quelle politique de conservation. Un modèle appelé via une API est un sous-traitant, même quand l'intégration a pris dix minutes.
- La journalisation des décisions de routage, si plusieurs modèles coexistent : c'est la seule preuve que les données sensibles n'ont pas emprunté le mauvais chemin. Voir le moteur d'orchestration.
Un modèle hébergé sur site dispense-t-il des quatre obligations ?
Faire tourner le modèle dans votre propre infrastructure ne vous exonère d'aucune des quatre obligations, puisque la transparence, la base légale, la limitation des durées et la preuve restent dues à l'identique. Ce que le déploiement local change tient à la nature de la démonstration.
Sur une API externe, vous démontrez par le contrat, c'est-à-dire un engagement de non-réutilisation, une localisation déclarée et une durée de conservation annoncée. Vous dépendez d'un tiers pour un fait inobservable. Sur site, vous démontrez par l'architecture, puisque les journaux sont vos journaux, la purge est votre script, et le réentraînement n'a pas lieu car rien ne l'exécute.
La différence apparaît le jour où il faut prouver, parce qu'une clause contractuelle décrit une intention du fournisseur là où une trace d'exploitation décrit un fait établi. C'est la même logique que celle exposée dans IA générative et RGPD, appliquée au cas particulier du chatbot.
Le corollaire pratique, souvent contre-intuitif : un déploiement local mal exploité peut être moins conforme qu'une API bien contractualisée. Des journaux locaux conservés indéfiniment, sur un serveur dont personne ne surveille les accès, sont un risque, pas une garantie. La souveraineté donne la capacité de contrôler ; elle ne dispense pas de le faire.
Quelle trajectoire de mise en œuvre évite les reprises coûteuses ?
L'ordre ci-dessous évite les reprises coûteuses, parce qu'il traite d'abord ce qui est structurant. La finalité du projet, le lieu d'exécution des modèles et les durées de conservation se décident avant la première ligne de code.
- Écrire la finalité en une phrase, et la liste de ce que le chatbot ne fera pas. C'est ce refus explicite qui protégera du glissement de finalité.
- Décider où tournent les modèles selon la sensibilité, avant d'écrire du code. Revenir dessus après coup revient à refaire l'intégration.
- Fixer les durées de conservation aux quatre endroits, et implémenter la purge tout de suite. Une purge ajoutée plus tard ne rattrape pas les données déjà accumulées.
- Instrumenter avant d'ouvrir : sans journalisation des décisions dès le premier jour, la période de démarrage restera un angle mort.
- Ouvrir à un périmètre restreint, observer ce que les utilisateurs y mettent réellement, puis ajuster. C'est la seule façon de connaître le périmètre réel du traitement.
Cet article décrit des conséquences d'architecture, il ne constitue pas un conseil juridique. Sources : recommandations IA et RGPD de la CNIL, fiches pratiques IA de la CNIL, règlement (UE) 2024/1689, recommandations de sécurité de l'ANSSI. Consultées le 28 août 2026.
Ce qu'il faut retenir
Les quatre obligations d'un chatbot conforme se révèlent, à l'examen, des décisions d'architecture déguisées en obligations juridiques. Informer se code dans le composant ; fonder se décide avant l'outil ; limiter se joue aux quatre endroits où la donnée se dépose ; prouver n'est possible que si les trois premières ont laissé une trace.
Le point de bascule est le choix de l'endroit où tourne le modèle. Il détermine si votre conformité repose sur un contrat ou sur une architecture observable. Le sujet est aussi traité par secteur, notamment la santé et le secteur public.
Questions fréquentes
Un chatbot interne doit-il annoncer qu'il est une IA ?
Oui, et la mention doit être accessible au moment de l'interaction, pas seulement dans une page de conditions générales. Le règlement européen sur l'IA renforce cette exigence pour les systèmes qui interagissent directement avec des personnes physiques. Le piège fréquent est l'intégration : un chatbot embarqué dans un outil métier ou une messagerie perd souvent son bandeau d'information. C'est le composant qui doit porter la mention.
Quelle base légale pour un chatbot d'entreprise ?
L'intérêt légitime de l'employeur est la base la plus courante, plutôt que le consentement du salarié dont la validité est fragile dans une relation hiérarchique. Ce choix conditionne les droits à servir et la mise en balance à documenter. Deux dérives à surveiller : le glissement de finalité, quand un assistant RH devient une source d'indicateurs sur les équipes, et le réentraînement du modèle sur les conversations, qui est une finalité distincte.
Combien de temps peut-on conserver les conversations d'un chatbot ?
Le RGPD ne fixe pas de durée : elle doit être proportionnée à la finalité et documentée. Le vrai sujet est que les conversations se déposent à quatre endroits, pas un seul : l'historique visible, les journaux techniques, le cache de la passerelle et la base vectorielle. La plupart des projets ne fixent une durée que pour le premier.
Un modèle hébergé sur site rend-il le chatbot conforme au RGPD ?
Non, il n'exonère d'aucune obligation. Ce qu'il change est la nature de la preuve : sur une API externe vous démontrez par le contrat, sur site vous démontrez par l'architecture, les journaux et la purge que vous exploitez. Un déploiement local mal exploité, avec des journaux conservés indéfiniment, peut être moins conforme qu'une API bien contractualisée.
Supprimer un document supprime-t-il ses données du chatbot ?
Pas automatiquement, et c'est l'angle mort le plus coûteux. Si le document a été indexé dans une base vectorielle, ses fragments restent interrogeables tant que l'index n'a pas été purgé sélectivement ou reconstruit. Une demande d'effacement peut donc être considérée comme traitée alors qu'elle ne l'est pas.