Inférence souveraine en entreprise : 8 × RTX PRO 6000 Blackwell face à 8 × H200 SXM
Pour traiter ses flux documentaires confidentiels en septembre 2026, une organisation déploie sur site une grappe d'inférence redondée de huit cartes accélératrices, éliminant tout transfert externe de données grâce à un arbitrage technique et financier entre puces professionnelles PCIe et modules pour centres de données.
Prix : carte RTX PRO 6000 Max-Q chez LDLC et place de marché NVIDIA (relevés du 26 septembre 2026), configurateurs BIZON et Supermicro pour les machines à quatre cartes (sur devis), serveur HGX H200 chez CTO Servers (2 septembre 2026), taux BCE du 25 septembre 2026. Les débits sont des hypothèses de travail de QDNA, non mesurées.
Mis à jour le 26 septembre 2026 : coûts refaits : investissement RTX PRO 6000 ramené aux prix relevés (carte à 14 758 € HT chez LDLC, machines à quatre cartes sur devis intégrateurs, 105 000 à 140 000 € HT pour deux nœuds au lieu de 384 000 €), serveur H200 au taux BCE du 25 septembre, et correction d'une erreur d'un facteur mille sur le coût par million de tokens (environ 165 à 200 € HT par million à 27 millions de tokens par mois, non 0,45 €) ; les débits sont désormais présentés comme des hypothèses non mesurées ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots).
Pourquoi dimensionner deux serveurs pour l'inférence locale ?
Le choix de deux serveurs physiques identiques garantit la continuité de service grâce à une répartition de charge active et une tolérance aux pannes matérielles. En cas d'indisponibilité fortuite d'un nœud de calcul, la seconde machine prend en charge l'ensemble des flux d'inférence sans interruption.
Dans une architecture d'entreprise en production, un point de défaillance unique expose les applications métier à un arrêt critique. L'hébergement de quatre cartes graphiques par châssis sur deux serveurs jumeaux permet d'effectuer les opérations de maintenance logicielle ou les mises à jour du système d'exploitation sans suspendre les services d'intelligence artificielle.
Cette répartition physique équilibre également la charge électrique et thermique sur deux baies ou deux disjoncteurs distincts. Chaque machine absorbe une alimentation électrique d'environ 3 200 W sans exiger les travaux d'infrastructure lourds ni le refroidissement liquide complexe que requiert l'arrivée d'une baie monobloc à très haute densité.
Quelles différences d'architecture entre RTX PRO 6000 et H200 SXM ?
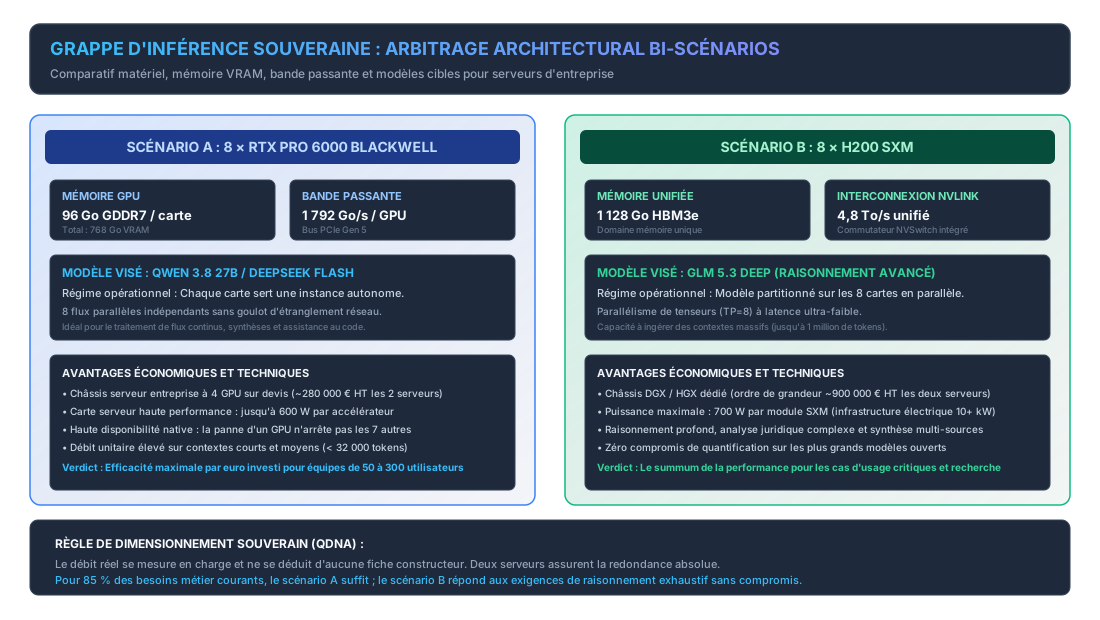
La carte RTX PRO 6000 Blackwell exploite un bus PCIe standard et quatre-vingt-seize gigaoctets de mémoire vive rapide, tandis que le module H200 SXM dispose de cent quarante et un gigaoctets de mémoire à très haute bande passante, reliée par des interconnexions NVLink spécialisées.
Le module pour centre de calcul H200 SXM privilégie la puissance brute afin de propulser les charges massives d'apprentissage et d'inférence distribuée, là où la carte PCIe vise le service de modèles qui tiennent dans sa mémoire.
Grâce à sa mémoire HBM3e offrant 4,8 To/s de débit par composant et à son réseau d'interconnexion NVLink à 900 Go/s bidirectionnel, les processeurs échangent les activations de couches à une célérité sans commune mesure avec le bus PCIe standard.
La carte accélératrice pour serveur RTX PRO 6000 Blackwell adopte une enveloppe thermique allant jusqu'à 600 W en pleine charge de calcul. Dotée de mémoire GDDR7 à 1 792 Go/s, elle s'insère dans des emplacements PCIe Gen 5 renforcés et fonctionne en refroidissement par air sans nécessiter de boucle liquide dédiée.
| Caractéristique technique | Grappe 8 × RTX PRO 6000 Blackwell | Grappe 8 × H200 SXM5 |
|---|---|---|
| Mémoire graphique totale | 768 Go GDDR7 (96 Go par carte) | 1 128 Go HBM3e (141 Go par GPU) |
| Bande passante mémoire unitaire | 1 792 Go/s par carte (14,3 To/s cumulés) | 4,8 To/s par module (38,4 To/s cumulés) |
| Interconnexion inter-GPU | Bus PCIe Gen 5 (64 Go/s bidirectionnel) | NVLink 4 (900 Go/s bidirectionnel par GPU) |
| Consommation électrique estimée | Jusqu'à 600 W par carte (~3 200 W par serveur) | ~700 W par module (~3 800 W par serveur) |
| Raccordement électrique nécessaire | Lignes dédiées 16 A ou 32 A par châssis | Alimentation triphasée 32 A haute densité |
| Refroidissement en baie | Air pulsé standard sans aménagement | Refroidissement liquide ou couloir confiné |
| Modèles ouverts recommandés | Qwen 3.8 27B, DeepSeek V4 Flash | GLM 5.3 Deep, DeepSeek V4 671B |
Quels modèles ouverts faire tourner sur chaque grappe ?
Une grappe de puces RTX PRO 6000 fait tourner des modèles ouverts compacts comme Qwen 3.8 27B ou DeepSeek V4 Flash. L'architecture H200, plus puissante, héberge sans compromis de quantification les très grands réseaux comme GLM 5.3 Deep, qui exigent une mémoire et une bande passante bien supérieures pour préserver la précision en virgule flottante native.
Avec un volume de 768 Go de mémoire graphique cumulée sur les deux serveurs, la configuration en cartes RTX PRO 6000 charge simultanément plusieurs instances spécialisées. Une équipe peut ainsi héberger un modèle de raisonnement de trente milliards de paramètres, un réseau d'intégration vectorielle pour la recherche documentaire et un modèle d'extraction structurée sans saturation de la mémoire vive.
Les modules H200 SXM, totalisant 1 128 Go de mémoire HBM3e à latence ultra-faible, s'imposent dès lors qu'une organisation souhaite servir un modèle géant monolithique sans dégradation de précision en virgule flottante native. Cependant, le surcoût matériel doit correspondre à un besoin réel d'analyse complexe non résolu par des modèles compacts hautement entraînés.
Quel débit d'inférence attendre sous le moteur vLLM ?
Le moteur vLLM optimise le débit d'inférence en combinant le groupement continu des requêtes et la conservation du cache clé-valeur en mémoire graphique. Grâce aux huit cartes RTX PRO 6000 réparties sur les deux nœuds, la bande passante globale cumulée maintient un débit d'exécution fluide face à des flux d'invites concurrentes.
La vitesse d'inférence d'un grand modèle de langage se décompose en deux régimes distincts : le traitement initial de l'invite de commande et la génération séquentielle des unités lexicales. La phase de préremplissage mobilise la puissance de calcul brute des cœurs tenseurs, tandis que la phase de décodage dépend de la bande passante mémoire.
Sur des requêtes documentaires comprenant de longs préfixes partagés, l'ordonnanceur de vLLM réutilise les segments d'attention déjà calculés. Cette conservation locale du cache évite le recalcul redondant des mêmes contextes d'entreprise et stabilise la latence, même lorsque des dizaines de collaborateurs interrogent la plateforme en parallèle.
Quel coût total de possession sur trois ans d'exploitation ?
Le coût total de possession comprend l'investissement initial amorti sur trente-six mois, la consommation électrique continue et la maintenance en centre de données. Les cartes RTX PRO 6000 offrent un ticket d'entrée plus accessible qu'une infrastructure de modules H200 SXM, et l'analyse sur trois années d'exploitation met en lumière un écart budgétaire déterminant lié à l'exigence de redondance physique.
Deux serveurs complets avec quatre cartes RTX PRO 6000 chacun représentent environ 105 000 à 140 000 € HT d'investissement initial. Les huit cartes seules coûtent environ 118 000 € HT, soit 14 758 € HT la carte Max-Q chez LDLC le 26 septembre 2026, et 16 000 $ sur la place de marché NVIDIA selon Thunder Compute.
Les intégrateurs BIZON, Exxact ou Supermicro chiffrent une machine complète à quatre cartes entre 60 000 et 80 000 dollars sur devis, soit environ 53 000 à 70 000 € HT par nœud au taux BCE du 25 septembre 2026 (1 € = 1,1403 $). Cette répartition offre une tolérance aux pannes native sur deux nœuds.
Pour la grappe 8 × H200 SXM5, un châssis serveur unique HGX de huit processeurs coûte environ 451 000 € HT (387 785 £ chez CTO Servers le 2 septembre 2026, taux BCE du 25 septembre). Si l'organisation déploie deux serveurs pour éliminer tout point unique de défaillance matérielle en miroir, l'investissement matériel initial atteint alors environ 902 000 € HT.
En intégrant un coût de l'électricité à 0,1624 €/kWh HT pour une puissance moyenne continue de 6,4 kW et l'hébergement en baie dédiée, la grappe RTX PRO 6000 revient à environ 4 480 à 5 450 € HT par mois : 2 917 à 3 889 € HT d'amortissement sur 36 mois, 759 € d'électricité et 800 € d'hébergement.
Sur le modèle dense Qwen 3.8 27B servi sous vLLM en quantification FP8, nous retenons en hypothèse de travail, non mesurée, 1 500 tokens par seconde en crête et une moyenne lissée de 500 tokens par seconde, soit environ 1,3 milliard de tokens par mois à pleine charge.
Le coût par million de tokens se lit en divisant le coût mensuel par le volume servi : environ 165 à 200 € HT pour 27 millions de tokens mensuels, environ 3,4 à 4,2 € HT à pleine charge continue. La version précédente publiait 0,45 € et 0,010 €, une erreur d'un facteur mille corrigée le 26 septembre 2026.
| Poste de dépense et métriques | Grappe 8 × RTX PRO 6000 Blackwell | Grappe 8 × H200 SXM5 |
|---|---|---|
| Investissement matériel initial (2 serveurs d'entreprise) | ~105 000 à 140 000 € HT (2 serveurs de 4 GPU, devis intégrateurs) | ~451 000 € HT (1 serveur HGX 8 GPU) à ~902 000 € HT (2 serveurs redondés) |
| Amortissement matériel mensuel (36 mois) | 2 917 à 3 889 € HT / mois | 12 528 € HT / mois (base 1 serveur HGX) |
| Électricité (0,1624 €/kWh HT en continu) | ~759 € HT / mois (6,4 kW moyens) | ~903 € HT / mois (7,6 kW moyens) |
| Hébergement et maintenance en baie privée | ~800 € HT / mois | ~1 000 € HT / mois |
| Coût mensuel total d'exploitation (TCO) | ~4 480 à 5 450 € HT / mois | ~14 431 € HT / mois (1 serveur HGX) |
| Coût total cumulé sur 36 mois | ~161 000 à 196 000 € HT | ~519 500 € HT (1 serveur HGX) |
| Débit estimé avec Qwen 3.8 27B (vLLM, FP8) | ~1 500 tokens/s en crête (~500 tokens/s moyen), hypothèse non mesurée | ~4 200 tokens/s en crête (~1 400 tokens/s moyen), hypothèse non mesurée |
| Volume mensuel moyen généré (Qwen 3.8 27B) | ~1,3 milliard de tokens / mois | ~3,7 milliards de tokens / mois |
| Coût estimé par million de tokens (usage modéré) | ~165 à 200 € HT (base 27 M tokens / mois) ; ~3,4 à 4,2 € HT à pleine charge (1,3 G tokens / mois) | ~320 € HT (base 45 M tokens / mois) ; ~3,9 € HT à pleine charge (3,7 G tokens / mois) |
Comment sécuriser la passerelle LiteLLM et le réseau privé ?
La passerelle LiteLLM sécurise les accès internes au moyen de clés virtuelles étanches et de plafonds de consommation par service, sans nécessiter d'ouverture vers Internet. Toutes les requêtes demeurent cantonnées au réseau local de l'organisation, prévenant toute fuite documentaire.
L'intégration d'une passerelle centrale entre les applications internes et les moteurs vLLM simplifie l'administration quotidienne. LiteLLM distribue une clé d'accès virtuelle à chaque équipe, limite le volume d'appels autorisés par utilisateur et consigne chaque transaction dans un journal d'audit local exploitable pour la conformité réglementaire.
L'isolation réseau complète protège le secret des affaires et garantit la conformité aux exigences des référentiels de sécurité européens. Aucune bribe d'information, qu'il s'agisse de contrats, de correspondances juridiques ou de notes de synthèse, ne franchit le périmètre du centre de données de l'organisation.
Une infrastructure d'inférence souveraine repose sur un compromis rationnel : des processeurs adaptés au profil réel des modèles, une passerelle d'accès rigoureusement cloisonnée et un coût de possession maîtrisé dans la durée.
Sources officielles
Sources : documentation officielle vLLM pour l'inférence distribuée, spécifications des processeurs graphiques NVIDIA pour centres de calcul et guide de sécurité de l'ANSSI.
Questions fréquentes
Pourquoi deux serveurs de quatre cartes sont-ils préférables à un seul serveur de huit cartes ?
La répartition en deux serveurs distincts supprime le point de défaillance unique. Elle permet de redémarrer ou maintenir une machine sans couper la production logicielle, tout en répartissant les besoins électriques sur deux lignes d'alimentation indépendantes.
Quelle est la durée d'amortissement recommandée pour une grappe d'inférence ?
Une période d'amortissement linéaire de trente-six mois constitue la norme industrielle en entreprise. Elle équilibre le coût mensuel comptable avec le cycle de renouvellement technologique des accélérateurs graphiques.
Peut-on combiner des cartes RTX PRO 6000 et des modules H200 dans le même cluster ?
Oui, au niveau de l'orchestration logicielle. La passerelle LiteLLM peut orienter les requêtes courantes vers les cartes RTX PRO 6000 et réserver un serveur H200 aux rares traitements nécessitant un très grand modèle géant.
La mémoire GDDR7 bride-t-elle les temps de réponse par rapport à la HBM3e ?
Sur la phase de décodage séquentiel, la mémoire HBM3e offre un débit supérieur pour les très grands modèles. En revanche, pour des modèles de taille intermédiaire optimisés en virgule flottante réduite, l'écart de latence reste imperceptible pour les utilisateurs finaux.