Full Stack AI Company : bâtir sa plateforme avec l'IA on-premise, Hugging Face et NVIDIA
Opérer une organisation entièrement propulsée par l'intelligence artificielle exige de s'affranchir des simples wrappers d'API distantes. Voici l'architecture industrielle d'une Full Stack AI Company souveraine, combinant serveurs accélérés, conteneurs NVIDIA, modèles ouverts et essaims d'agents outillés.
Mis à jour le 8 octobre 2026 : prix du cluster 2× DGX Spark porté à 14 000 € HT (7 000 € HT par nœud, prix de référence d'octobre 2026) ; indice Artificial Analysis v4.3.2 relu le 8 octobre 2026 (GLM 5.3 à 44,8, Kimi K3 à 43,6) ; données structurées de la foire aux questions alignées sur le texte affiché.
Mis à jour le 26 septembre 2026 : indice Artificial Analysis relu en version 4.3.2 (GLM 5.3 à 45, Kimi K3 à 44, MiMo-V2.6-Pro en tête à 46), prix du cluster 2× DGX Spark réaligné sur LDLC.pro ; passages les plus denses réécrits pour la lisibilité (phrases de 22 à 26 mots) ; acquisition de Hugging Face par NVIDIA (3 septembre 2026) et méthode v4.3 de l'indice Artificial Analysis ajoutées.
Qu'est-ce qu'une Full Stack AI Company opérant sur site ?
Une Full Stack AI Company sur site maîtrise toute sa chaîne de valeur, logicielle et matérielle. Elle va des accélérateurs GPU et des modèles ouverts Hugging Face jusqu'au moteur d'inférence, à l'orchestration par essaim d'agents et aux interfaces métiers, sans dépendre d'une API cloud fermée.
Le modèle classique, qui intègre l'IA par simple appel d'une API distante, montre ses limites dès que le volume de requêtes augmente. Le coût grimpe, et la dépendance envers un fournisseur qui fixe seul ses conditions grimpe avec lui.
Une société qui délègue son intelligence à des points d'accès propriétaires s'expose à des hausses tarifaires unilatérales, à des coupures de service imprévues, à des dérives comportementales des modèles distants et à des transferts illégitimes de propriété intellectuelle. À l'inverse, l'approche Full Stack AI On-Premise traite le calcul comme un actif stratégique durable.
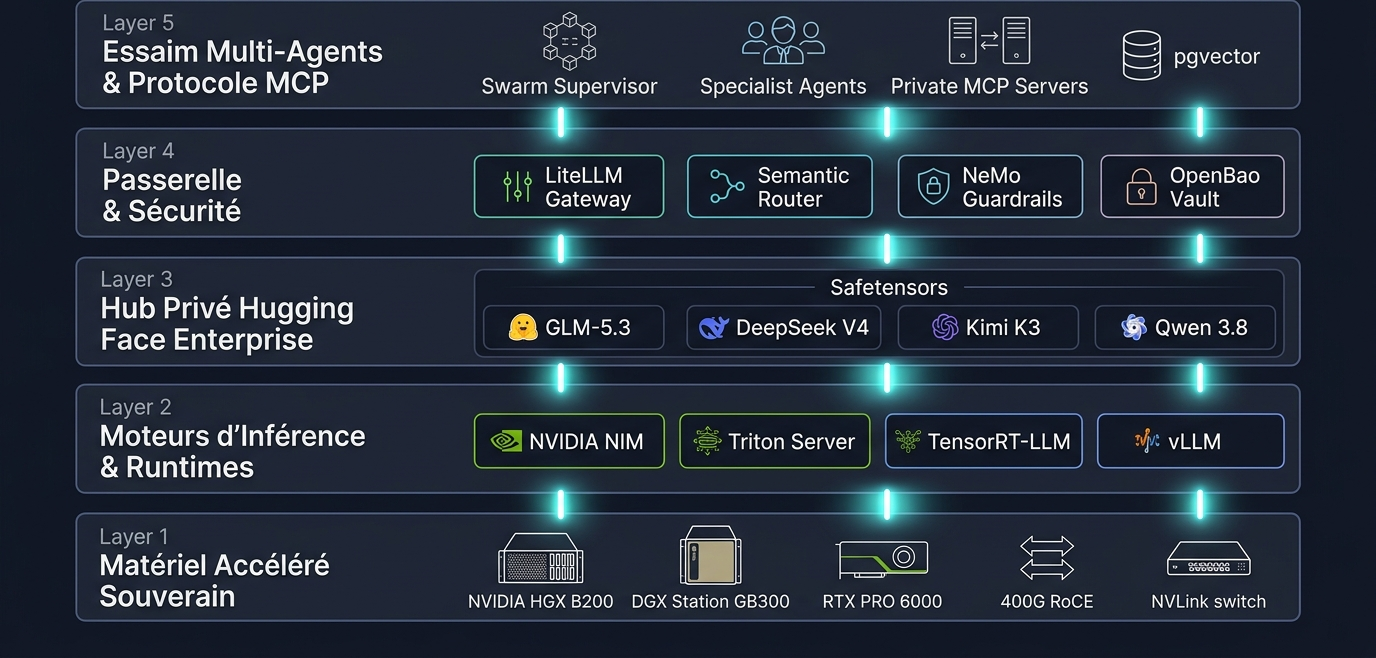
L'organisation qui possède ses serveurs de calcul gagne une prévisibilité d'exploitation. Postes de travail RTX PRO 6000, stations DGX Station GB300 ou baies HGX B200 SXM interconnectées en RoCE 400G : le choix dépend de la charge, la logique reste la même.
Les modèles de langage ne sont plus une boîte noire externe. Ce sont des artefacts versionnés au format Safetensors, que l'on inspecte, audite et spécialise sur le patrimoine documentaire interne, et que l'équipe peut figer, comparer ou remplacer à sa main.
Comment intégrer les modèles open-weights Hugging Face avec NVIDIA AI Enterprise ?
L'intégration relie les modèles à poids ouverts au format Safetensors, hébergés sur un hub Hugging Face Enterprise privé, à la plateforme NVIDIA AI Enterprise. Les conteneurs NIM ou le moteur Triton Inference Server les exécutent avec TensorRT-LLM sur GPU Blackwell ou Hopper, dans un réseau entièrement isolé.
Le lien entre les deux acteurs s'est resserré le 3 septembre 2026 : NVIDIA a annoncé l'acquisition de Hugging Face pour 12,93 milliards de dollars, selon le billet officiel de NVIDIA. La plateforme de référence des modèles ouverts et le premier fournisseur de matériel forment donc une seule maison, ce que toute stratégie d'approvisionnement sur site doit désormais intégrer.
L'écosystème Hugging Face s'est imposé comme le registre universel des pondérations libres de référence, et les bancs d'évaluation impartiaux de septembre 2026 confirment que les modèles ouverts dominent désormais les premières places :
- Sur le banc DeepSWE (Datacurve), évaluant 113 tâches d'ingénierie logicielle réelles sur 91 dépôts avec vérificateurs manuels, GLM 5.3 et Kimi K3 décrochent chacun 69 % de réussite (à 3,99 $ et 4,65 $ par tâche), égalant ou surclassant les modèles propriétaires fermés les plus réputés.
- Le cas GLM 5.3 Flash constitue la rupture d'efficience majeure de 2026 : un mélange d'experts (MoE) de 320 milliards de paramètres dont 18 milliards actifs, doté d'une fenêtre de contexte native de 1 048 576 tokens (1M) et d'un cache KV ultra-compact de 11 Kio par token (via MLA et 11 couches d'attention creuse dynamique DSA). Il valide 63 % sur DeepSWE pour seulement 0,24 $ par tâche, soit un coût seize fois inférieur à GLM 5.3 pour seulement six points d'écart.
- DeepSeek V4 Flash 0731 (284B / 13B actifs, contexte 1M natif, 167 Go publiés en safetensors mixtes FP4+FP8 sous licence MIT) affiche 82,7 % sur Terminal Bench 2.1, 76,7 % sur Cybergym et 54,4 % sur DeepSWE.
- Qwen 3.8 27B (27,8B dense hybride Gated DeltaNet, 262K extensible à 1M par YaRN, licence Apache 2.0) combine une empreinte compacte (55,6 Go en BF16, 23,4 Go en NVFP4) avec un score de 90,3 % sur LiveCodeBench v6 et 61,7 % sur SWE-bench Pro.
- Sur l'indice Artificial Analysis (v4.3.2, relevé du 26 septembre 2026), GLM 5.3 (45) et Kimi K3 (44) suivent MiMo-V2.6-Pro (46) en tête des modèles ouverts, devant GLM 5.3 Flash (42), DeepSeek V4.1 Flash (39) et Qwen 3.8 27B (34) (indice v4.3.2 du 8 octobre 2026 : GLM 5.3 44,8, Kimi K3 43,6, GLM 5.3 Flash 41,8, DeepSeek V4.1 Flash 39,5, Qwen 3.8 27B 33,7) ; l'indice a été recalibré depuis la version 4.1.1, les scores ne se comparent pas d'une version à l'autre. La version 4.3 du 7 septembre 2026 remplace τ³-Banking par AutomationBench-AA et porte à 45 % le poids des épreuves à jeu de test privé, contre 40 % auparavant.
Grâce à une organisation Hugging Face Enterprise déployée sur site ou connectée via des jetons d'accès programmatiques chiffrés sous OpenBao, l'entreprise gère un miroir local de dépôts Git LFS. Aucun flux de données de production n'est transmis vers des serveurs publics.
La couche certifiée NVIDIA AI Enterprise apporte le cadre d'exécution pour les déploiements de production. L'orchestration de l'infrastructure s'appuie sur Kubernetes équipé du NVIDIA GPU Operator, qui gère le cycle de vie des pilotes noyau, le partitionnement matériel Multi-Instance GPU (MIG) et l'allocation des périphériques CUDA aux pods d'inférence.
Les microservices conteneurisés NVIDIA NIM (NVIDIA Inference Microservice) et le runtime Triton Inference Server y sont déployés sous forme de StatefulSets ou de contrôleurs KServe et vLLM Operator. Cette architecture assure l'autoscaling horizontal fondé sur la latence de file d'attente et l'occupation mémoire du cache KV, tout en appliquant la quantification NVFP4 ou FP8 sur les cœurs Tensor.
Comment structurer un essaim agentique autonome avec le protocole MCP et des outils souverains ?
Un essaim agentique autonome repose sur un agent superviseur qui coordonne des agents spécialisés. Le protocole Model Context Protocol (MCP) les relie à des outils souverains internes : bacs à sable d'exécution conteneurisés, passerelles Git locales et bases vectorielles privées sous contrôle d'accès strict.
Les architectures agentiques isolées, où un modèle unique planifie, rédige et contrôle à la fois, s'effondrent vite sur les cas d'usage complexes. L'essaim multi-agents (Swarm System) répartit au contraire la charge cognitive selon une hiérarchie précise :
- Le superviseur d'essaim (Orchestrateur) : modèle à fort raisonnement logique (GLM 5.3 ou Kimi K3) chargé de décomposer la demande utilisateur en un graphe de dépendances d'étapes (DAG), de déléguer l'exécution aux agents spécialistes et de vérifier la cohérence finale.
- Les agents spécialistes : instances dédiées au code (GLM 5.3 Flash ou Qwen 3.8 27B), à l'analyse de données, à la conformité réglementaire ou à la revue de sécurité (DeepSeek V4 Flash 0731), opérant en parallèle dans des boucles de travail itératives.
- Le juge et arbitre déterministe : mécanisme contradictoire chargé d'évaluer les résultats intermédiaires, de rejouer les tests unitaires et de bloquer toute régression avant validation.
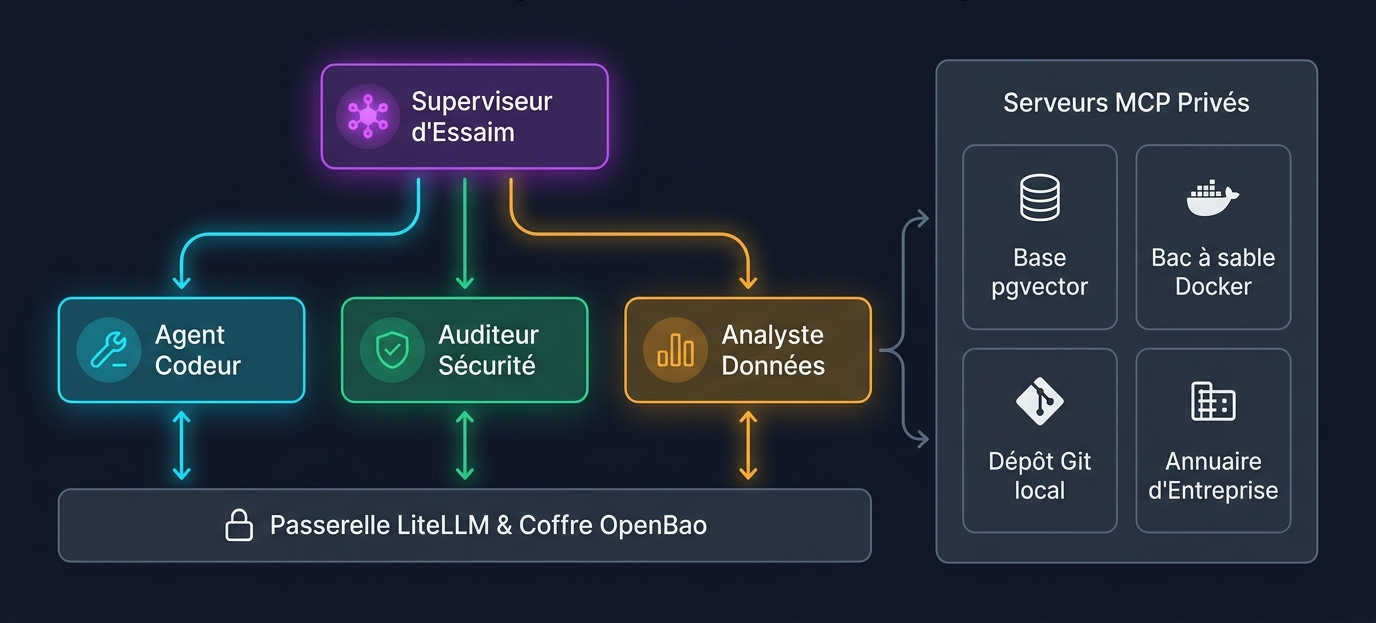
Pour interagir avec le système d'information de l'entreprise sans compromettre la sécurité, l'essaim adopte le protocole standardisé Model Context Protocol (MCP). Des serveurs MCP privés sont déployés au sein du réseau local étanche. Ils exposent quatre capacités fondamentales au travers d'interfaces JSON-RPC strictement auditées :
- Base relationnelle et vectorielle (PostgreSQL avec pgvector) : sert de mémoire sémantique à long terme et d'ancrage documentaire (RAG hybride associant recherche dense et BM25) sans solliciter de service vectoriel cloud tiers.
- Bac à sable conteneurisé (Kubernetes Jobs / Podman) : offre un environnement d'exécution éphémère isolé par des règles réseau Kubernetes (NetworkPolicy), un contexte de sécurité sans privilèges root et des quotas stricts de calcul et de mémoire vive, où les agents exécutent et testent leurs scripts sans risque pour le cluster hôte.
- Dépôt Git local (Gitea / GitLab on-premise) : permet la lecture de l'arborescence du code source, la génération de branches isolées et la soumission de pull requests auditées sans exfiltration vers l'extérieur.
- Annuaire d'entreprise (LDAP / Active Directory) : applique un contrôle d'accès fondé sur les rôles (RBAC) pour que chaque agent n'accède qu'aux ressources documentaires correspondant aux privilèges de l'utilisateur demandeur.
La passerelle d'accès LiteLLM, couplée au coffre de secrets OpenBao, agit comme un pare-feu applicatif d'inférence. Elle gère les clés virtuelles d'API, applique les quotas stricts de tokens par département, consigne les métriques d'audit requises par l'AI Act européen, et fournit un coupe-circuit (kill switch) instantané en cas d'activité anormale.
Quelle matrice technique régit les rôles de l'essaim et le dimensionnement GPU ?
La matrice technique associe à chaque rôle de l'essaim un modèle à poids ouverts adapté à sa tâche. Elle arbitre entre débit de décodage, taille de contexte et mémoire vidéo, afin de maximiser le débit global sur des serveurs qui vont du poste RTX PRO 6000 à la baie HGX B200.
Le déploiement simultané d'un essaim d'agents exige une gestion serrée de la mémoire vidéo (VRAM) et des caches de clés-valeurs (KV Cache). Chaque agent résident occupe en effet sa part du budget mémoire de la machine, et la somme ne doit jamais dépasser ce budget.
Allouer systématiquement le modèle le plus lourd à l'intégralité des micro-tâches sature inutilement la bande passante mémoire et dégrade le temps d'attente utilisateur. Le tableau ci-dessous formalise la distribution des charges et les caractéristiques techniques mesurées en laboratoire.
| Rôle dans l'essaim | Modèle open-weight | Runtime et format | Fenêtre contexte | Débit et latence TTFT | Accélérateur cible |
|---|---|---|---|---|---|
| Superviseur d'essaim et raisonnement | GLM 5.3 (744B / 40B actif) ou Kimi K3 | Triton / TensorRT-LLM NVFP4 | 1 048 576 jetons (1M) | 68 tok/s · TTFT 38 ms | 8× H200 SXM, 8× B200 ou DGX Station |
| Ingénieur code et refactoring | GLM 5.3 Flash (320B / 18B actif) | vLLM / NIM FP8 | 1 048 576 jetons (1M) | 84 tok/s · TTFT 22 ms | 4× RTX PRO 6000 ou DGX Station GB300 |
| Auditeur sécurité et conformité | DeepSeek V4 Flash 0731 (284B / 13B) | vLLM 0.25 (DSpark) FP4+FP8 | 1 048 576 jetons (1M) | 75 tok/s · TTFT 24 ms | Cluster 2× DGX Spark ou 2× RTX PRO 6000 |
| Synthèse documentaire et RAG | Qwen 3.8 Flash Next (176B / 6B actif) | oMLX / vLLM FP8 | 262 144 jetons (ext. 1M) | 110 tok/s · TTFT 16 ms | Mac Studio M5 Ultra 512 Go (1 personne locale) ou 2× DGX Spark |
| Micro-agent outils MCP et triage | Qwen 3.8 27B Coder (dense hybride) | TensorRT-LLM / vLLM FP8 | 262 144 jetons (ext. 1M) | 95 tok/s · TTFT 12 ms | 1× RTX PRO 6000 ou DGX Spark 128 Go |
Les données publiées sur le banc SemiAnalysis InferenceX (scénario AgentX) éclairent les choix d'infrastructure. Contrairement aux tests statiques (8k entrée / 1k sortie), le scénario AgentX simule des sessions multi-tours réalistes à contexte croissant, où le prefix caching et le décodage spéculatif multi-tokens (MTP) deviennent primordiaux.
- Sur un cluster NVIDIA Blackwell GB300 NVL72, le débit de pointe atteint 137 337 tok/s par puce, et se stabilise à 63 340 tok/s par puce à une cible d'interactivité fluide de 96 tok/s par utilisateur. Le coût marginal d'inférence s'effondre à 0,010 $ par million de tokens, avec une capacité d'accueil de 546 flux concurrents par accélérateur.
- Sur architecture NVIDIA Hopper H200 SXM, le débit se situe à 4 361 tok/s par puce pour un coût de 0,137 $ par million de tokens. Le bond architectural de Blackwell s'explique par l'interconnexion NVLink 5 (130 To/s bisectionnel par rack) qui fluidifie le routage des tokens vers les experts des grands modèles MoE sans saturation de bus.
- À l'échelle d'une équipe ou d'un poste de travail individuel, les formats compacts permettent un déploiement performant sans investissement datacenter : un cluster de deux DGX Spark GB10 reliés en ConnectX-7 200 Gb/s (14 000 € HT, soit deux nœuds à 7 000 € HT, prix retenu en octobre 2026 après la hausse constatée (relevé LDLC.pro relue le 18 octobre 2026 : 5 083 € HT)) sert DeepSeek V4 Flash 0731 à 95,9 tok/s avec DSpark pour une équipe multi-utilisateurs, tandis qu'un Mac Studio M5 Ultra (512 Go unifiés à 1,2 To/s) opéré sous le serveur oMLX constitue la station idéale pour une personne en local (ingénieur ou chercheur dédié), servant GLM 5.3 Flash en 4 bits (177,5 Go) à plus de 200 tok/s en décodage solo avec un cache KV hiérarchique RAM et SSD NVMe pour ses agents personnels.
Combien de jetons de contexte et de sessions simultanées chaque carte peut-elle accueillir ?
Dans une architecture d'entreprise, un essaim d'agents autonomes ne se dimensionne plus sur des contextes étroits de 8k ou 32k jetons. Ingérer des arborescences Git complètes, des schémas SQL, des spécifications OpenAPI et des journaux d'erreurs impose un plancher opérationnel minimal de 256 000 jetons (256K) par agent.
Une extension naturelle atteint 1 048 576 jetons (1M) pour couvrir les tâches d'audit et de refactoring complexe. Le dimensionnement combine deux métriques : la rétention du cache KV en mémoire vive vidéo (VRAM) et le régime de vitesse entre les deux temps du modèle :
- Le débit de prefill (prompt processing, borné par le calcul) : mesuré en jetons par seconde (tok/s), il quantifie la vitesse à laquelle le GPU ingère le contexte de 256K jetons et détermine le délai avant le premier jeton (TTFT). Plus les cœurs Tensor en FP8 ou FP4 sont puissants, plus l'analyse initiale du dépôt ou du schéma est rapide.
- Le débit de decode (génération, borné par la bande passante mémoire) : mesuré en jetons par seconde émis, il fixe la cadence à laquelle l'agent rédige sa réponse et ses arguments d'outils MCP, chaque jeton imposant la relecture complète des poids actifs et du cache KV accumulé.
- L'empreinte du cache KV par jeton : régie par l'architecture d'attention, elle s'élève à 160 Kio par jeton en FP8 sur GQA classique (Llama 3.1 70B, soit 41 Go rien que pour 256K de contexte), 32 Kio par jeton en FP8 sur attention hybride linéaire (Qwen 3.8 27B, soit 8,59 Go pour 256K), 21 Kio sur DeepSeek V4 Flash DSA (5,5 Go pour 256K), et seulement 11 Kio par jeton en FP8 sur GLM 5.3 Flash (2,88 Go pour 256K).
Le tableau ci-dessous décrit, pour chaque configuration matérielle, la mémoire utilisable par le cache KV ainsi que les débits estimés de prefill et de decode. Il indique aussi le nombre maximal de flux simultanés, du standard minimal de 256K jetons jusqu'à 1M de contexte plein :
| Accélérateur et mémoire totale | Modèle hébergé et format | VRAM disponible pour le cache KV | Débits estimés (prefill · decode) | Capacité totale de cache (jetons) | Sessions simultanées (plancher 256k jetons) | Sessions simultanées (512k et 1M plein) |
|---|---|---|---|---|---|---|
| DGX Spark GB10 128 Go LPDDR5x (273 Go/s) |
Qwen 3.8 27B Coder FP8 (~32 Go fixes) |
~96 Go | Prefill : ~1 450 tok/s Decode : ~58 tok/s |
~2,93 millions de jetons (32 Kio / tok hybride) |
11 sessions à 256k | 5 sessions à 512k 2 sessions à 1M (ext.) |
| Cluster 2× DGX Spark 256 Go unifiés (ConnectX-7 200G) |
DeepSeek V4 Flash 0731 FP4/FP8 DSpark (~175 Go fixes) |
~81 Go | Prefill : ~2 800 tok/s Decode : ~96 tok/s |
~3,76 millions de jetons (21 Kio / tok MLA) |
14 sessions à 256k | 7 sessions à 512k 3 sessions à 1M plein |
| Mac Studio M5 Ultra 512 Go unifiés (1,2 To/s) Station 1 personne locale |
GLM 5.3 Flash (320B / 18B) oMLX 4 bits (~193 Go fixes) |
~319 Go | Prefill : ~3 100 tok/s Decode : ~215 tok/s (solo) |
~28,3 millions de jetons (11 Kio / tok DSA · cache oMLX) |
108 sessions à 256k (dédié 1 utilisateur local) |
54 sessions à 512k 27 sessions à 1M plein |
| Serveur 2× RTX PRO 6000 96 Go GDDR6 (PCIe Gen5) |
Qwen 3.8 27B Coder FP8 (~32 Go fixes) |
~64 Go | Prefill : ~6 200 tok/s Decode : ~95 tok/s |
~1,95 million de jetons (32 Kio / tok hybride) |
7 sessions à 256k | 3 sessions à 512k 1 session à 1M (ext.) |
| Serveur 4× RTX PRO 6000 192 Go GDDR6 (PCIe Gen5) |
GLM 5.3 Flash (320B / 18B) NVFP4 / FP8 (~178 Go fixes) |
~14 Go | Prefill : ~7 800 tok/s Decode : ~84 tok/s |
~1,24 million de jetons (11 Kio / tok DSA) |
4 sessions à 256k | 2 sessions à 512k 1 session à 1M plein |
| DGX Station GB300 748 Go (252 Go HBM3e + 496 Go RAM) |
GLM 5.3 (744B / 40B actif) NVFP4 (~483 Go fixes) |
~265 Go | Prefill : ~12 500 tok/s Decode : ~68 tok/s (HBM3e) |
~5,90 millions de jetons (44 Kio / tok MLA) |
22 sessions à 256k | 11 sessions à 512k 5 sessions à 1M plein |
| Baie 8× H200 SXM 1 128 Go HBM3e (38,4 To/s) |
GLM 5.3 (744B / 40B actif) FP8 natif (~788 Go fixes) |
~340 Go | Prefill : ~38 000 tok/s Decode : ~145 tok/s (4,3k agrégé) |
~7,56 millions de jetons (44 Kio / tok MLA) |
28 sessions à 256k | 14 sessions à 512k 7 sessions à 1M plein |
| Baie 8× B200 SXM 1 440 Go HBM3e (64 To/s) |
GLM 5.3 (744B / 40B actif) FP8 natif (~788 Go fixes) |
~652 Go | Prefill : ~95 000 tok/s Decode : ~280 tok/s (14k agrégé) |
~14,5 millions de jetons (44 Kio / tok MLA) |
55 sessions à 256k | 27 sessions à 512k 13 sessions à 1M plein |
| Rack GB300 NVL72 20,7 To HBM3e unifiée (130 To/s) |
GLM 5.3 ou MoE 1 000B+ FP8 (~1 200 Go fixes) |
~19,5 To | Prefill : ~850 000 tok/s Decode : 63,3k tok/s / puce |
~434 millions de jetons (44 Kio / tok MLA) |
1 650 sessions à 256k | 825 sessions à 512k 414 sessions à 1M plein |
Comment prédire les coûts d'inférence et calculer le ROI sur trois ans face aux API cloud ?
La prédiction des coûts compare la volumétrie exponentielle des jetons consommés par les essaims agentiques au coût total de possession (TCO) d'une infrastructure sur site. Cette infrastructure s'amortit sur trois ans et le seuil de rentabilité est franchi dès cinq ingénieurs ou deux cent cinquante millions de jetons mensuels.
L'économie des systèmes agentiques diffère radicalement de celle des chatbots conversationnels classiques. Alors qu'un utilisateur humain formule une requête de quelques centaines de jetons et reçoit une réponse unique, un essaim autonome génère des boucles réflexives continues.
Une seule tâche complexe de développement logiciel ou d'analyse financière déclenche fréquemment entre vingt et quatre-vingts appels de modèles. Elle mobilise la relecture du contexte complet et consomme couramment de deux à dix millions de jetons par problème traité.
Notre plancher opérationnel de 256 000 jetons couvre l'ingestion simultanée de l'arborescence des dépôts Git, des schémas relationnels SQL et de l'historique des traces d'outils MCP. À chaque nouvelle boucle itérative correspond un prompt massif réinjecté, que seul un cache de préfixe rend supportable.
Sur une API commerciale fermée facturée au jeton d'entrée et de sortie, cette volumétrie fait exploser le coût unitaire d'une simple passe de refactoring à plus de vingt dollars. À l'échelle d'une équipe de dix ingénieurs ou analystes utilisant intensivement des agents outillés, la consommation mensuelle dépasse aisément un milliard de jetons.
Les grilles tarifaires des modèles commerciaux infonuagiques de pointe facturent 10 à 15 dollars le million de jetons d'entrée et 30 à 60 dollars en sortie. La facture mensuelle atteint alors 25 000 à 50 000 euros, soit plus de 300 000 euros par an.
En comparaison, l'acquisition d'un serveur d'inférence équipé de deux cartes RTX PRO 6000 s'amortit sur une durée comptable de trente-six mois. Un nœud accéléré huit GPU suit la même logique, et la dépense proportionnelle au volume devient un coût fixe et prévisible.
Le calcul de TCO intègre l'investissement initial, à savoir le châssis, les cartes graphiques et le stockage NVMe. Il ajoute les abonnements NVIDIA AI Enterprise ainsi que la consommation électrique, calculée sur la base du Tarif Bleu professionnel. Ce tarif s'élève à 0,1624 € HT par kWh selon la délibération CRE 2026-147, et les charges de maintenance complètent le calcul :
| Échelle d'usage et volume mensuel | Facturation API cloud commerciale | Coût TCO on-premise sur 36 mois | Seuil de rentabilité et gain net |
|---|---|---|---|
| Équipe de 5 ingénieurs (250 M jetons / mois) | 4 250 € HT / mois (153 000 € sur 3 ans) | Serveur 2× RTX PRO 6000 (53 180 € tout compris) | Rentabilisé en 12 mois · Gain net : 99 820 € |
| Département de 25 ingénieurs (2,5 Md jetons / mois) | 38 500 € HT / mois (1 386 000 € sur 3 ans) | Nœud HGX 8× H200 (429 200 € tout compris) | Rentabilisé en 11 mois · Gain net : 956 800 € |
| Entreprise de 100 collaborateurs (15 Md jetons / mois) | 215 000 € HT / mois (7 740 000 € sur 3 ans) | Cluster 2× HGX B200 (968 500 € en colocation) | Rentabilisé en 5 mois · Gain net : 6 771 500 € |
Quelles exigences de conformité et de souveraineté le modèle on-premise satisfait-il ?
Le modèle d'IA déployé sur site garantit une conformité native au RGPD et au règlement européen AI Act. Les données confidentielles et les secrets industriels restent dans le périmètre informatique de l'entreprise, sans transfert transfrontalier ni réutilisation non consentie pour l'apprentissage.
L'entrée en application du règlement européen sur l'intelligence artificielle (AI Act) impose aux organisations une traçabilité de leurs traitements automatisés. Les directives renforcées de la CNIL et du CEPD imposent la même exigence, que l'exécution locale documente par construction.
L'utilisation d'API tierces hébergées hors de l'Union européenne expose l'entreprise aux législations extraterritoriales telles que le Cloud Act américain, rendant illusoire toute garantie d'étanchéité absolue. En opérant sa propre plateforme locale, l'organisation applique le principe fondamental de minimisation des données et de confinement cryptographique.
Les journaux d'inférence générés par LiteLLM sont chiffrés localement, les bases vectorielles pgvector résident sur des disques NVMe sécurisés, et aucun paramètre n'est soumis à un entraînement tiers. Cette souveraineté technique constitue le socle indispensable pour valoriser son capital numérique en toute indépendance.
Questions fréquentes
Qu'est-ce qu'une Full Stack AI Company opérant sur site ?
Une Full Stack AI Company sur site maîtrise toute sa chaîne de valeur, logicielle et matérielle. Elle va des accélérateurs GPU et des modèles ouverts Hugging Face jusqu'au moteur d'inférence, à l'orchestration par essaim d'agents et aux interfaces métiers, sans dépendre d'une API cloud fermée.
En quoi NVIDIA AI Enterprise sécurise-t-il l'exploitation des modèles ouverts ?
NVIDIA AI Enterprise fournit des microservices conteneurisés NIM et le runtime Triton validés pour la production, garantissant des correctifs de sécurité réguliers, une compilation optimisée TensorRT-LLM et une compatibilité matérielle certifiée sur GPU Hopper et Blackwell.
Comment le protocole MCP protège-t-il les outils internes de l'entreprise ?
Le Model Context Protocol (MCP) normalise les échanges entre les modèles et les outils au travers de serveurs locaux hermétiques, assurant que les requêtes aux bases SQL pgvector, aux bacs à sable Docker et aux dépôts Git restent cantonnées au réseau interne sans fuite de télémétrie.
À quel volume de calcul l'infrastructure on-premise devient-elle plus rentable que les API cloud ?
Le seuil d'amortissement économique est franchi dès 250 millions de jetons mensuels ou cinq ingénieurs exploitant des boucles d'agents autonomes, réduisant le coût unitaire du million de jetons d'un facteur quatre à huit par rapport aux tarifs des API commerciales.
Pourquoi fixer un plancher minimal de 256 000 jetons de contexte pour les essaims d'agents ?
L'exécution d'un essaim d'agents requiert l'injection simultanée du référentiel Git, des schémas de base de données, des interfaces OpenAPI et de l'historique complet des appels d'outils MCP. Les fenêtres classiques de 8k ou 32k tokens provoquent une amnésie contextuelle et des hallucinations, rendant un plancher de 256K jetons (extensible à 1M natif sur GLM 5.3 Flash et DeepSeek V4 Flash) indispensable en environnement d'ingénierie.
Quelle différence technique fait-on entre le débit de prefill et le débit de decode ?
Le débit de prefill (en prompt tok/s) mesure la vitesse d'ingestion initiale du contexte de 256K jetons, bornée par la puissance brute de calcul (FLOPS) des cœurs Tensor, conditionnant le temps de premier jeton (TTFT). Le débit de decode (en generation tok/s) mesure la vitesse de rédaction mot à mot de l'agent, bornée par la bande passante mémoire (Go/s) de la carte graphique.
Quel est le positionnement d'un Mac Studio sous oMLX par rapport aux clusters GPU de production ?
Un Mac Studio M5 Ultra doté de 512 Go de mémoire unifiée opérant sous le runtime oMLX constitue un poste de travail dédié à une personne locale (ingénieur ou chercheur). Il permet de faire tourner en local des modèles de 320 milliards de paramètres comme GLM 5.3 Flash à plus de 200 tok/s en décodage solo avec cache étendu sur SSD NVMe, réservant les clusters multi-GPU NVIDIA en rack (DGX, HGX) aux flux concurrents multi-utilisateurs et aux déploiements d'entreprise.